
你有没有过这样的经历:和 AI 聊天时,话刚说到一半,AI 已经开始滔滔不绝地回复,你只能干等着它说完才能继续?或者你突然想到一个重要的补充信息,却不得不等它输出完几百字的错误内容才能纠正?
本文要解决的就是这个问题:让飞书里的 AI 对话也支持"可插话"模式——你和真人聊天一样,可以在 AI 回复的任意时刻打断它、补充信息、或者改变话题,完全不用等待。
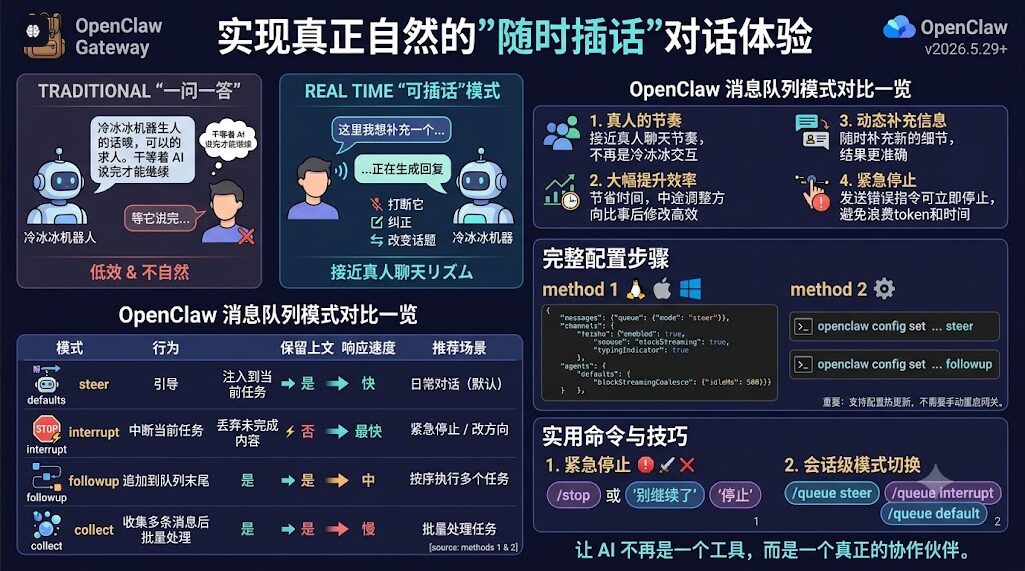
为什么"随时插话"如此重要
传统的 AI 对话模式是严格的"一问一答":你发一条消息,AI 生成一条回复,你再发下一条。这种模式在简单查询时还能接受,但在复杂的协作场景中会变得非常低效和不自然。
真正的可插话对话模式带来了以下几方面的改进:
1. 对话体验更接近真人
和真人聊天时,我们经常会在对方说话的过程中插话、点头表示理解、或者纠正对方的误解。可插话模式让 AI 对话也拥有了这种自然的节奏,不再是冷冰冰的机器交互。
2. 大幅提升沟通效率
当你发现 AI 正在走向错误的方向时,不用等它输出完一整篇错误的内容,直接打断它并纠正,可以节省大量时间。特别是在处理复杂任务时,中途调整方向比事后修改要高效得多。
3. 可以动态补充信息
很多时候,我们在提问时并不能一次性想到所有需要的信息。有了可插话功能,你可以在 AI 思考和生成的过程中随时补充新的细节,让最终的结果更加准确和符合你的需求。
4. 紧急停止能力
当你不小心发送了错误的指令,或者 AI 开始生成你不需要的内容时,你可以立即停止它,避免浪费 token 和时间。
OpenClaw 的四种消息队列模式
OpenClaw 通过消息队列(message queue)模式来控制如何处理用户的新消息。官方提供了四种不同的模式,每种模式都有其适用场景:
推荐:Steer(引导)模式(官方默认)
这是最适合日常使用的模式。当你发送新消息时,OpenClaw 会将它立即注入到正在运行的 Agent 任务中,在下一个工具调用边界处生效。
- 优点:保留 AI 已经生成的内容,模型会根据你的新信息调整后续回复,过渡非常自然。
- 缺点:在非流式阶段(例如工具调用过程中)会自动回退到 followup 模式。
备选:Interrupt(中断)模式
这是最激进的模式。当你发送新消息时,OpenClaw 会直接终止当前所有任务,丢弃未完成的内容,立即开始处理你的新消息。
- 优点:响应最快,完全不等待。
- 缺点:会丢失 AI 已经生成但还没发送给你的内容。
其他两种模式
- Followup 模式:将新消息添加到队列末尾,等当前任务完成后再处理。适合按顺序执行多个独立任务。
- Collect 模式:收集多条消息后一起处理。最省 token,但响应最慢,适合批量处理。
四种模式对比一览:
| 模式 | 行为 | 保留上文 | 响应速度 | 推荐场景 |
|---|---|---|---|---|
| Steer | 引导,注入到当前任务 | 是 | 快 | 日常对话(默认) |
| Interrupt | 中断当前任务 | 否 | 最快 | 紧急停止 / 改方向 |
| Followup | 追加到队列末尾 | 是 | 中 | 按序执行多个任务 |
| Collect | 收集多条后批量处理 | 是 | 慢 | 批量处理任务 |
完整配置步骤
方法 1:直接编辑配置文件(最稳妥)
编辑 OpenClaw 的主配置文件:
- Linux / macOS:
~/.openclaw/openclaw.json - Windows:
C:\Users\你的用户名\.openclaw\openclaw.json
将以下内容复制到文件中:
{
  "messages": {
    "queue": {
      "mode": "steer" // 官方默认值,新安装的 OpenClaw 已经是这个设置
    }
  },
  "channels": {
    "feishu": {
      "enabled": true,
      "appId": "你的飞书机器人 AppID",
      "appSecret": "你的飞书机器人 AppSecret",
      "streaming": true,        // 启用流式输出,这是可插话的基础
      "blockStreaming": true,   // 启用块级流式传输
      "typingIndicator": true,  // 显示"正在输入"状态
      "resolveSenderNames": true // 解析发送者的真实姓名
    }
  },
  "agents": {
    "defaults": {
      "blockStreamingCoalesce": {
        "idleMs": 500 // 流式块合并的空闲时间,单位毫秒
      }
    }
  }
}重要提示:OpenClaw Gateway 支持配置热更新,你编辑保存后,配置会自动生效,不需要手动重启网关。只有在版本升级或修改网络相关配置时才需要重启。
方法 2:命令行配置(适用于临时调整)
如果你只是想临时测试不同的模式,可以使用命令行来配置:
# 全局设置为 steer 模式(官方默认,新安装无需执行)
openclaw config set messages.queue.mode steer

# 仅为飞书渠道单独设置(如需覆盖全局设置)
openclaw config set messages.queue.byChannel.feishu steer

# 如果你想要更激进的中断模式
# openclaw config set messages.queue.byChannel.feishu interrupt

# 启用飞书流式输出(必须)
openclaw config set channels.feishu.streaming true
openclaw config set channels.feishu.blockStreaming true

# 优化流式合并延迟
openclaw config set agents.defaults.blockStreamingCoalesce.idleMs 500
版本要求与前置条件
- OpenClaw 版本要求:2026.5.29 或以上。
- 飞书是 OpenClaw 的内置频道,无需单独安装插件。
- 确保飞书开放平台已授予机器人消息和卡片相关权限。
实用命令与技巧
1. 紧急停止
无论使用哪种模式,你都可以在飞书聊天中发送以下命令立即停止所有操作:
/stop或者使用自然语言:
别继续了
停止
2. 会话级模式切换
在飞书聊天中直接发送以下命令,可以临时切换当前会话的队列模式:
/queue steer     # 切换到引导模式(推荐)
/queue interrupt # 切换到中断模式
/queue followup  # 切换到跟进模式
/queue collect   # 切换到收集模式
恢复到全局默认模式:
/queue default3. 查看运行日志
如果你遇到问题,可以查看 OpenClaw 的运行日志:
# 实时查看所有运行日志
openclaw logs --follow
常见问题排查
问题 1:发送新消息后还是要等很久
- 确认飞书开放平台已为你的机器人授予了必要的消息和卡片权限。
- 运行
openclaw logs --follow查看是否有错误信息。 - 确认没有其他进程占用飞书机器人的 WebSocket 连接。
问题 2:steer 模式不生效
- 确保已启用流式输出:
channels.feishu.streaming: true。 - steer 模式只在"可安全注入"的窗口生效(也就是 AI 正在生成文本的流式阶段)。
- 当 AI 正在调用工具时,会自动回退到 followup 模式,等工具调用完成后再处理你的新消息。
问题 3:飞书消息更新不及时
- 调整
agents.defaults.blockStreamingCoalesce.idleMs参数。 - 减小该值会提高消息更新频率,但可能增加 API 调用次数。
- 建议值范围:300ms – 1000ms。
总结
OpenClaw 的 steer 模式为我们带来了真正自然的 AI 对话体验。通过简单的配置,你就可以在飞书中实现和真人聊天一样的"随时插话"功能,大幅提升你和 AI 协作的效率。
笔者使用这个配置已经有一段时间了,现在已经完全无法回到传统的一问一答模式。那种可以随时打断、随时补充的对话体验,真的会让你感觉 AI 不再是一个工具,而是一个真正的协作伙伴。
如果你也在使用 OpenClaw 和飞书的集成,强烈建议你尝试一下这个配置。相信我,一旦你体验过真正的可插话对话,就再也回不去了。