
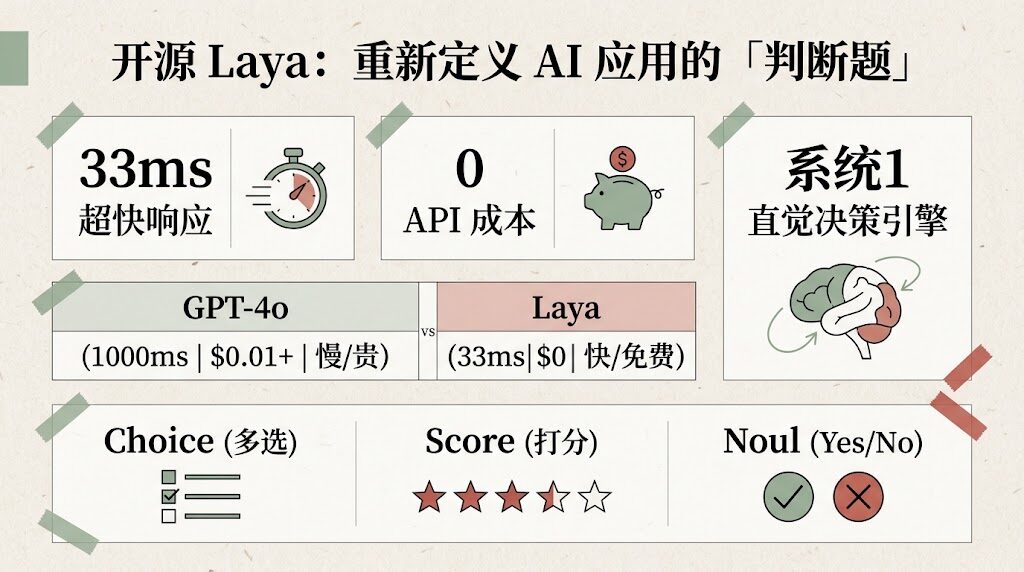
如果你的 AI 应用每天要给客服工单分类、给钓鱼邮件打分、判断一段提示词是不是越狱攻击——你可能一直在为「判断题」付出「问答题」的代价:调用 GPT-4o 一次要 1000ms、$0.01+,但它只做了一件事:选 A 还是 B。
Laya 是这个问题的开源答案:单次推理 33ms,本地就能跑,Apache-2.0 完全开放。
一、Laya 是什么
Laya 是 Convai Innovations(Nandha Kishor M)开源的系统1决策引擎,不是生成式模型——它不写文字、不组织语言,只在一次前向传播里直接输出一个类型化的决策结果。
它的核心思路来自 Daniel Kahneman 在《思考,快与慢》里的双系统理论:
- 系统 1:快速、直觉、自动化(识别「危险/安全」「A/B/C 选哪个」)
- 系统 2:慢速、推理、生成(写代码、写分析、写故事)
GPT-4o 这种生成式大模型在系统 2 上很强,但很多 AI 应用其实只需要系统 1。Laya 把这一层独立出来,做成一个轻量、本地、可校准的决策模型。
一句话定位:让 AI 应用在「分类/打分/判断」类任务上摆脱昂贵生成式 API,本地小模型即可精准决策。
二、它能做什么决策
Laya 直接输出三种类型化决策,每一种都附带概率校准:
2.1 三种决策类型
| 决策类型 | 含义 | 典型场景 |
|---|---|---|
| choice | 从多个选项里选一个(多选题) | 客服工单分到 A/B/C 哪个部门 |
| score | 0–1 之间的置信度评分 | 邮件是钓鱼的概率、用户流失概率 |
| noul | yes / no / 中立(neutral) | 这段 prompt 是不是越狱攻击 |
2.2 概率校准:告诉你「这个判断有多可信」
它用一种叫 RLCD(Reinforcement Learning with Calibrated Decisions) 的方法训练,预期校准误差 ECE 只有 0.081——意味着它说「这是钓鱼邮件的概率 0.87」,实际大约 87% 真的是钓鱼邮件。
这个特性在生产环境里很重要:你不会因为模型说「可能是恶意」就把正常邮件扔进垃圾箱,也不会因为说「可能安全」就把真钓鱼邮件放行——你可以设定阈值,让模型成为自动化门控。
2.3 你能用在哪些场景
| 场景 | 用 Laya 做什么 | 替代什么 |
|---|---|---|
| 客服工单分流 | 意图分类 + 置信度阈值,自动路由到部门 | GPT-4o 分类(1000ms,$0.01)→ Laya(33ms,$0) |
| 风险/钓鱼检测 | 置信度评分,阈值过滤高可信恶意邮件 | 调用生成式 API 让它「判断」 |
| Guardrails(安全护栏) | Jailbreak / Prompt Injection 检测 | 规则匹配(漏报高)→ Laya 概率判断 |
| 用户流失预测 | 客户流失概率评分,主动干预 | 训练专门的 sklearn 模型(费人) |
| 电商评论真假判断 | 置信度判断「5 星好评是不是刷的」 | 人工审核(慢) |
| 退款申请合理性 | 置信度判断「这个退款是不是恶意薅羊毛」 | 规则(漏)→ Laya(准) |
三、为什么能这么快
3.1 非自回归:33ms 出答案
大模型生成文字是「一个字一个字蹦」,从「今天」蹦到「天气」蹦到「不错」需要 50–200ms/字。Laya 不做生成,它在一次前向传播里直接输出决策向量,所以延迟可以压到 33ms。
实测对比:
| 方案 | 单次延迟 | 单次成本 | 可解释性 |
|---|---|---|---|
| Laya | 33ms | $0(自托管) | 概率校准,置信度可信 |
| TypeSafe Jev(商业版) | 236–276ms | API 费用 | 概率 |
| GPT-4o 判断 | ~1000ms | $0.01+ / 请求 | 弱(不直接给概率) |
3.2 多语言 Router:自动选模型
Laya 内置了一个 Python 写的 Router,不到 0.5ms 就能检测输入的语言和任务类型,然后路由到合适的 checkpoint:
convaiinnovations/laya:ModernBERT-large 编码器,421M 参数,512 token 上下文,英文专用convaiinnovations/laya-multilingual:mmBERT-base 编码器,322M 参数,1024 token 上下文,支持 100+ 语言,比英文版快 2 倍convaiinnovations/laya-typed-decisions:微调版,在 400 个案例的 benchmark 上训练过
你不需要自己写路由逻辑,pip install 之后三行代码就能用。
3.3 安装与上手
pip install layaimport laya
# 加载多语言版本
agent = laya.load("convaiinnovations/laya", subfolder="multilingual")
# 一次决策调用
result = agent.decide(
state="这条用户请求会动到什么数据?",
instructions="按影响从轻到重选一档",
criteria={
"低": "只读公开信息",
"中": "修改用户自己的数据",
"高": "修改他人数据或调用支付"
},
decision_type="choice"
)
print(result) # 输出: {"choice": "中", "confidence": 0.91}四、为什么 6 天拿下 22,896 颗星
这个项目 2026-09-18 上线,到 9 月 24 日 6 天内涨到 22,896 颗星——连续 3 天每天 1500+ 颗星,在 GitHub Trending 上几乎霸榜。
爆发原因:
- Jev 闭源 → Laya 开源复现,填补空白
TypeSafe 的 Jev 是同类决策引擎,但商业闭源、API 调用收费。Laya 用 Apache-2.0 完全开放,社区直接 fork。
- AI 应用降本刚需
意图分类、邮件风控、Guardrails 这些任务其实不需要生成式模型——但很多团队图省事直接调 GPT-4o,每月光判断题就要烧几千美元。Laya 让这部分成本归零。
- Apache-2.0 协议无商业限制
你可以把它集成进商业产品、SaaS 服务、内部分类器,没有任何授权问题。
- Hugging Face 权重公开
直接 laya.load("convaiinnovations/laya") 就能下载权重,本地 GPU / CPU 都能跑(CPU 也能 33ms,因为模型只有 322M-421M 参数)。
- 文档与示例齐全
仓库自带 5 个应用示例(客服分流 / 风控 / Guardrails / 流失预测 / 投票分类),复制代码就能用。
五、和同类方案对比
| 维度 | Laya | Hugging Face 零样本分类 | 规则 + 关键词 | GPT-4o 判断 |
|---|---|---|---|---|
| 延迟 | 33ms | 100–500ms | <1ms | ~1000ms |
| 成本 | $0(本地) | $0(本地) | $0 | $0.01+/次 |
| 可解释性 | 概率 + 校准 | 概率(未校准) | 规则可见 | 弱 |
| 多语言 | 100+ | 取决于模型 | 取决于规则 | 强 |
| 冷启动 | 开箱即用 | 需要选模型 | 需要写规则 | 开箱即用 |
| 数据隐私 | 本地 | 本地 | 本地 | 数据上云 |
什么时候你用不上它:
- 你的判断场景每天只有几十次、每次都是高难度语义推理(这时 GPT-4o 反而更准)
- 你需要模型给的是「解释理由」而不是「一个数字」(生成式模型更合适)
- 你的判断场景每条都需要专业知识(医学、法律)——这种还是用专用微调大模型
什么时候你该用它:
- 每天几千到几百万次判断请求(成本敏感)
- 判断结果需要置信度门控(自动化决策)
- 数据隐私敏感不能上云(本地部署)
- 任务可以用 1-3 个标签概括(客服分类、邮件打分)
六、给 AI 应用开发者的三条启发
6.1 把「判断」和「生成」解耦
很多团队的 AI 应用架构里,所有任务都走同一个 LLM——客服分类走 LLM、风控判断走 LLM、内容审核走 LLM。这其实是个反模式:判断类任务根本不需要生成式模型。
参考 Laya 的思路:
- 小模型(200-500M)专精「分类/打分/判断」
- 大模型(>7B)专注「生成/推理/创作」
- 中间用 Router 分流
这样能省下 50-90% 的 API 成本,延迟从秒级降到毫秒级。
6.2 概率校准是可量化的置信度
很多 AI 应用开发者把 LLM 的输出当成「是/否」布尔值用——「它说高风险就是高风险」。但 LLM 的概率输出没经过校准,说 0.7 不代表真有 70%。
Laya 的 RLCD 训练 + ECE 评估给你一个范本:让模型告诉你「这个判断的可信度是多少」,然后你设阈值、做门控、做异常告警。这是工业级 AI 应用必备的能力。
6.3 Router 模式:低开销元判断
Laya 的 Router 用不到 0.5ms 的 Python 脚本检测语言和任务类型——这是个值得学习的元判断模式。在复杂 AI 系统里:
- 加一层「这个请求该怎么处理」的 Router
- Router 用极简逻辑(关键词 + 长度 + 元数据)快速分流
- 大头请求才进昂贵的 LLM
这种「轻路由 + 重处理」的架构,比「所有请求都进同一个模型」更省钱、更快、更可观测。
七、相关项目快速索引
| 项目 | GitHub Stars | 定位 |
|---|---|---|
| NandhaKishorM/laya | ~22,896★ | 非自回归决策引擎,本地、33ms、零成本 |
| google/ax | ~10,491★ | Google 分布式 Agent 运行时 |
| vectorize-io/hindsight | ~27,800★ | Agent 记忆系统,让 Agent 越用越聪明 |
| huggingface/transformers | 130k+★ | Transformer 模型库,Laya 也基于它 |
八、读这篇你能带走什么
- ✅ 新工具:如果你每天要给几千几万次「分类/打分/判断」任务烧 API 钱,Laya 可以直接换掉那部分成本
- ✅ 新架构思路:把 AI 应用里的「判断」和「生成」解耦,单独优化每一层
- ✅ 新质量标准:概率校准 ECE < 0.1 是工业级决策模型的入门门槛,不是所有概率输出都可信
仓库地址:github.com/NandhaKishorM/laya
许可:Apache-2.0(可商用、无限制)
安装:pip install laya 三行代码即可上手。