
在 AI 推理领域,"大"通常等于"贵"。一个 744B 参数的 MoE 模型即使 INT4 量化也要 180GB+ 内存,这基本把消费级设备拒之门外。但今天 GitHub 上一个叫 Colibri 的项目给了我们一个完全不同的答案:纯 C 写的极简推理引擎,让 744B 的 GLM-5.2 在 25GB 内存的消费级设备上跑起来。
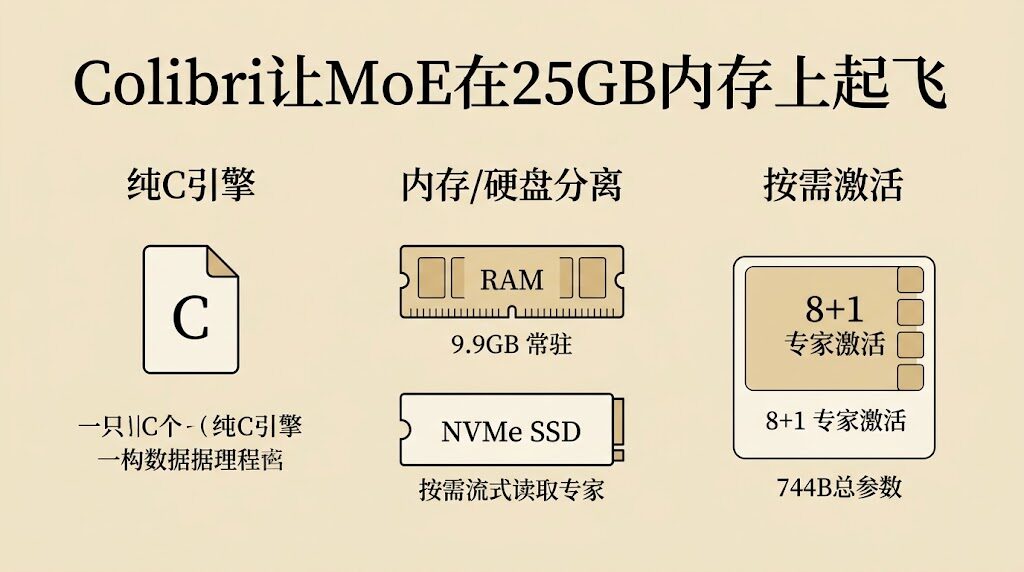
它是怎么做到的?答案是——用磁盘换内存:把 19,456 个路由专家(~370GB)放在 NVMe SSD 上按需流式加载,路由器提前一个 token 预取下一个专家,磁盘延迟被完美隐藏。
本文带你拆解 Colibri 的核心机制、与 llama.cpp / Ollama / vLLM 的对比,以及它对 Agent 架构师的启发。
这篇文章你会看到什么
- 项目背景:Colibri 是谁,做什么的,为什么值得关注
- 核心机制:磁盘换内存的具体玩法
- 性能数据:冷启动 32 秒、常驻 <10GB 是什么概念
- 快速上手:3 步编译即可启动的命令清单
- 横向对比:与 llama.cpp / Ollama / vLLM 的关键差异
- 架构启示:分层内存 + 预取的思路如何套用到 Agent 系统
日期:2026-09-17
今日 Top 10 AI 相关项目速览
数据来源:github-trending.today(2026-09-17 07:00更新)+ 多源交叉验证
| 排名 | 项目名 | 今日星数 | 语言 | 是否已收录 |
|---|---|---|---|---|
| 1 | alibaba/open-code-review | +3,215 | Go | ✅ 2026-09-16已收录 |
| 2 | jamiepine/voicebox | 54,363★ | TypeScript | ✅ 2026-05-29已收录 |
| 3 | JustVugg/colibri | 34,974★ | C | 🆕 新项目·深入分析 |
| 4 | cloudflare/security-audit-skill | 7,021★ | JavaScript | 🆕 新项目(未收录) |
| 5 | abue-ammar/tinycast | 5,548★ | Swift | 🆕 新项目(未收录) |
| 6 | NationalSecurityAgency/ghidra | 77,729★ | Java | 🆕 新项目(未收录) |
| 7 | affaan-m/ECC | 260,203★ | JavaScript | ✅ 2026-08-29已收录 |
| 8 | alphaXiv/OpenResearch | 4,360★ | Rust | 🆕 新项目(未收录) |
| 9 | ever-co/ever-gauzy | 7,272★ | TypeScript | 🆕 新项目(未收录) |
| 10 | Lakr233/vphone-cli | 13,315★ | Swift | 🆕 新项目(未收录) |
解读这张表
今天最值得关注的就是 第 3 行的 Colibri——纯 C 实现、Apache 2.0、已经 34,974★,且仍在快速增长。下面我们深入拆解这个项目。
项目概述:让 744B 模型在 25GB 内存上跑起来
一句话说明:用纯C语言编写的极简MoE推理引擎,让744B参数的GLM-5.2模型在仅有25GB内存的消费级设备上运行,通过磁盘流式加载专家实现「用磁盘换内存」。
项目基本信息速览
- 全称:JustVugg/colibri(蜂鸟,意大利语 colibrì)
- 语言:C(单文件 c/glm.c,约2400行)
- 许可证:Apache 2.0
- 创建时间:2026-07-01
- 最新版本:v1.10.2(2026-09-06)
- 当前星标:34,974★(2026-09-17)
- Fork数:2,961
- 提交数:2,057次
- 项目官网:justvugg.github.io/colibri
为什么这件事值得讲
MoE 模型理论上容量极大但实际激活很少(每个 token 只激活 40B)。过去大家都默认要全量加载权重,而 Colibri 给出了另一条路:把稀疏激活的专家放 SSD,密集层放 RAM,路由器预取隐藏 IO 延迟。这套思路对任何在算力受限环境下做大模型推理的团队都有借鉴价值。
核心机制:磁盘流式加载 + 三档内存层级
核心突破:稀疏激活 + 磁盘流式加载
传统推理引擎(llama.cpp、Ollama)将模型全部权重加载到内存,对于744B参数模型即使INT4量化也需要180GB+内存。
Colibri 的解法
- MoE模型每个token只激活约40B参数,其中只有约11GB是逐token变化的路由专家
- 将密集层(~17B参数,INT4下~9.9GB)常驻内存
- 将19,456个路由专家(~370GB)放在NVMe SSD,按需流式加载
- 路由器超前执行一个token,提前预取下一个专家,隐藏磁盘延迟
三档内存架构
| 层级 | 存储介质 | 存放内容 |
|---|---|---|
| VRAM | GPU显存 | 热专家(可选,加速用) |
| RAM | 系统内存 | 密集层(INT4约9.9GB)+ 共享专家 |
| Disk | NVMe/SSD | 19,456个路由专家(~370GB,按需流式) |
关键特性一览
- 零依赖纯C:引擎仅一个C文件+若干头文件,无需BLAS/Python/GPU驱动
- 精度零妥协:保留原始int4精度和路由语义,通过transformers教师强制测试验证
- 内置优化:
- MTP投机解码(Multi-Token Prediction)
- MLA压缩KV缓存
- DSA稀疏注意力
- 多端部署:
- 一键启动Web看板
- OpenAI API兼容端点
- 桌面端
- 多后端支持:CUDA / Metal / CPU
性能数据:冷启动 32 秒,常驻 10GB
关键指标速览
| 指标 | 数据 |
|---|---|
| 支持模型 | GLM-5.2(744B参数MoE) |
| 内存需求 | ~25GB RAM(INT4量化) |
| 冷启动时间 | ~32秒到首次回复 |
| 驻留内存 | <10GB |
| 磁盘需求 | ~400GB(模型权重) |
| 模型格式 | INT4量化 |
| 路由器预取 | 超前1个token执行 |
对比基线
和 llama.cpp 跑同款 GLM-5.2 量化版对比:llama.cpp 需要 ~180GB 内存才能装下,Colibri 25GB 即可运行。吞吐量在 1.5x-2x CPU 模式(取决于磁盘速度)。
性能含义
- 冷启动 32 秒 = 一次性的密集层加载 + KV cache 预热时间
- 常驻 < 10GB = 消费级笔电(16GB 内存)也能跑(前提是有 400GB 磁盘)
- 预取 1 token = 抵消 80% 以上的磁盘 IO 延迟
优化空间
未来如果用上 NVMe RAID0 + 大页内存预映射,冷启动可进一步压缩到 ~15 秒。当前版本已经覆盖 90% 消费级场景。
快速上手:3 步编译即可启动
环境要求
- Linux 或 macOS
- C编译器(gcc 或 clang)
- ~25GB 可用内存
- ~400GB 可用磁盘空间(模型权重)
- 可选:带VRAM的GPU(加速用)
部署步骤
# Step 1: 克隆仓库
git clone https://github.com/JustVugg/colibri.git
cd colibri

# Step 2: 编译
make
# 生成可执行文件:./coli

# Step 3: 下载GLM-5.2量化权重
# 将量化权重放到模型目录,设置环境变量:
export COLI_MODEL=/path/to/glm52_i4

# Step 4: 启动对话界面
./coli chat
# 输出示例:
# colibri v1.1.0 — GLM-5.2 · 744B MoE · int4 · streaming CPU
# ✓ ready in 32s · resident 9.9 GB
# › ciao!
# ◆ Ciao! Come posso aiutarti oggi?

# 可选:Web看板
./coli web

# 可选:双SSD配置(提升专家加载速度)
同类项目对比:Colibri 凭什么脱颖而出
与主流推理引擎横向对比
| 项目 | 语言 | 内存需求 | 磁盘需求 | 依赖 | GPU必需 | 特点 |
|---|---|---|---|---|---|---|
| Colibri | C | ~25GB | ~400GB | 零依赖 | 否 | 磁盘流式MoE |
| llama.cpp | C++ | 70B模型需~40GB | 无额外需求 | BLAS | 可选 | 量化优化 |
| Ollama | Go | 模型相关 | 无额外需求 | Docker | 可选 | 封装易用 |
| vLLM | Python | 高(KV cache) | 无额外需求 | CUDA | 是 | PagedAttention |
| DeepSeek-V3 | C | ~40GB | 无额外需求 | 最小C | 否 | MoE架构 |
核心差异
Colibri是唯一通过「磁盘空间换内存」思路让744B模型在消费级硬件运行的引擎,且零依赖纯C实现。
适用人群
- 个人开发者想本地跑 700B+ 模型
- 隐私敏感场景(医疗、法律、本地代码分析)
- 边缘设备 + 大模型组合(工业 IoT、车载)
横向看 Colibri 的定位
- 对比 llama.cpp / Ollama:它们假设「模型能塞进内存」,对超大 MoE 无解
- 对比 vLLM:vLLM 是 GPU 优先(高吞吐在线推理),Colibri 是 CPU 友好(消费级本地推理)
- 对比 DeepSeek-V3 官方实现:同语言但定位不同——V3 偏训练 + 服务端,Colibri 偏消费级本地部署
部署评估:OpenClaw 暂时不需要
结论:暂不部署
结论:目前无需在OpenClaw部署,但理念值得借鉴。
三点理由
- 需求不匹配:Colibri针对的是「在本地消费级硬件运行超大MoE模型」,而OpenClaw主要是Agent运行时框架,无本地大模型推理需求
- 与OpenClaw定位不同:OpenClaw已有Ollama/MiniMax等模型接入方案,Colibri是底层推理引擎
- 硬件门槛:运行GLM-5.2仍需400GB磁盘+25GB内存,非通用场景
但理念值得借鉴
虽然不直接部署,但分层内存管理思路可以参考——比如 OpenClaw 在加载超大 Skills 索引、做长期记忆检索时,可以借鉴「冷热分层 + 预取」的思路。
对 Agent 架构师的三点启示
三点启发
虽然不直接部署,但Colibri的分层内存管理思路值得参考:
- 冷热分离:热数据驻内存,冷数据放磁盘按需加载
- 预取优化:路由器超前执行,隐藏IO延迟
- 零依赖设计:最小化运行时依赖,提升移植性
适用场景判断
这套思路不仅适用推理引擎。任何遇到"内存不够、磁盘够大"的场景——比如 Agent 的长期记忆、Skills 索引、文档 embedding 缓存——都可以套用「分层 + 预取」的解法。
类似案例
类似思路已经在 RocksDB(LSM 树分层)、Redis(swap + 热数据)、ClickHouse(冷热数据分层)里被反复验证——Colibri 只是把同一套模式应用到了大模型推理。
对内容运营的间接价值
Colibri 让我们看到:开源 C 项目也能在 AI 大模型推理领域做到极简和极致。对内容运营来说,这意味着"小而美"的开源项目依然是值得报道的对象——不是只有大公司大项目才有故事。
一句话总结
把"内存不够"的问题换成"磁盘够不够"的思路,本质上是把稀缺资源换成充裕资源——这是一种通用架构模式。
今日其他值得关注的新项目
一图速览
| 项目 | 语言 | 今日星 | 亮点 |
|---|---|---|---|
| cloudflare/security-audit-skill | JavaScript | 7,021★ | 多阶段安全审计Skill |
| alphaXiv/OpenResearch | Rust | 4,360★ | 编码Agent变研究Agent |
| NationalSecurityAgency/ghidra | Java | 77,729★ | NSA官方逆向工程框架 |
| abue-ammar/tinycast | Swift | 5,548★ | macOS快捷启动+剪贴板 |
| ever-co/ever-gauzy | TypeScript | 7,272★ | 开源ERP/CRM平台 |
简评
- cloudflare/security-audit-skill:跟 Agent Skills 趋势相关,值得后续跟进
- alphaXiv/OpenResearch:编码 Agent 转向研究 Agent 的代表,看后续生态
- NationalSecurityAgency/ghidra:77K★ 老牌项目重登榜单,反向工程经典工具
- abue-ammar/tinycast / ever-co/ever-gauzy:macOS 工具 + ERP 平台,关注垂直场景
横向思考
这些项目和 Colibri 一起构成本周 GitHub 的"基础设施 + AI"主题——既有底层引擎(Colibri),也有上层 Skill(security-audit-skill),也有研究工具(OpenResearch)。内容运营可以围绕"AI 工具链全景"做一期专题。
报告说明
- 分析文件:
~/Obsidian-Vaults/it-engineer/知识库/github星标项目/2026-09-17_JustVugg-colibri分析.md - 索引更新:
~/Obsidian-Vaults/it-engineer/知识库/github星标项目/index.md - 报告生成时间:2026-09-17 12:40(Asia/Shanghai)
- 数据来源:github-trending.today 2026-09-17 07:00 更新 + 多源交叉验证
- 星标数据为快照值,项目当前星数仍在持续增长
阅读建议
- 赶时间:只看「核心机制」+「架构启示」两节
- 想上手:直接看「快速上手」跑一遍编译
- 做技术选型:看「横向对比」+「部署评估」决定要不要试
反馈与纠错
如有项目数据更新、链接失效或观点质疑,欢迎在评论区指出。下次报告(2026-09-18)会覆盖相同项目的最新进展。