
一、为什么这个项目值得关注
今天的 GitHub Trending 榜单上,一个字节跳动(火山引擎)开源的项目冲到了第一位 —— OpenViking,单日新增 2,304 颗星。
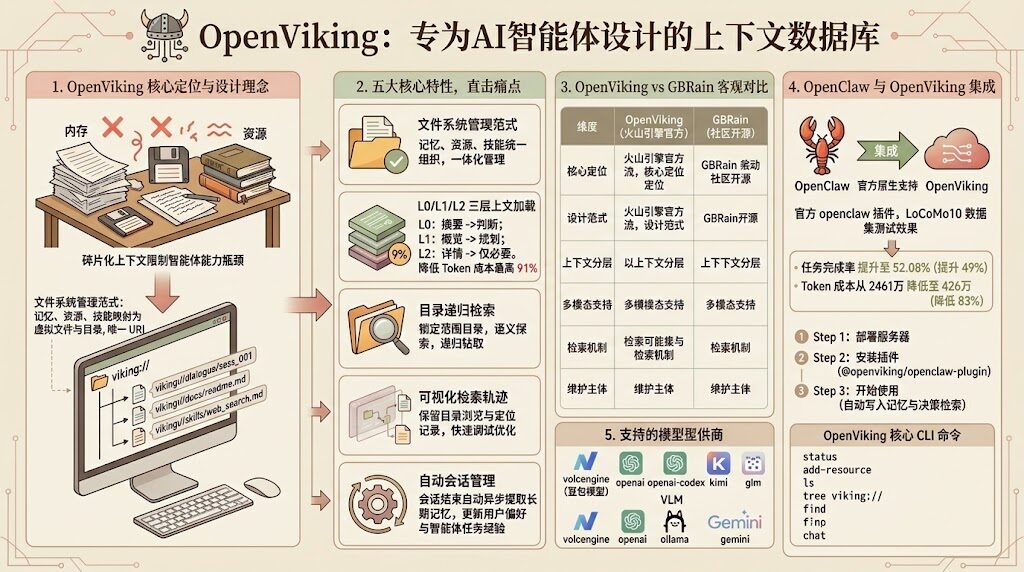
OpenViking 的核心定位是 AI Agent 上下文数据库(Context Database)。它的创新点用一个比喻就能讲清楚:
传统 AI Agent 的记忆就像「黑盒搜索」—— 你调用一个向量检索 API,它返回一堆结果,但检索过程不可见、不可控、不可调试。OpenViking 把这套机制改成了「虚拟文件系统」:所有上下文(记忆、知识、技能)都挂在
viking://协议路径下,Agent 像浏览文件一样ls、tree、find,每一步都看得见。
如果你正在搭建自己的 AI 工作台、被「Agent 总是失忆」「上下文越来越长导致 Token 爆掉」等问题困扰,这篇文章值得你花 8 分钟读完。
二、OpenViking 是什么
2.1 项目定位
OpenViking 是字节跳动(火山引擎)团队开源的 AI Agent 上下文管理框架,主要解决两个长期痛点:
- 黑盒检索:传统 RAG 用向量相似度返回 top-k 结果,但你不知道为什么是这几条
- 上下文膨胀:把所有历史对话塞进 prompt,Token 消耗爆炸,但效果不一定更好
OpenViking 的答案是把"记忆"和"知识"用虚拟文件系统统一管理 —— Agent 操作记忆的方式,就像你在终端里操作文件。
2.2 核心特性
1. 三层上下文加载(L0/L1/L2)
写入时预处理好三个层级,检索时按需加载:
- L0 抽象层:极小摘要(几十 Token),告诉 Agent「这里有什么」
- L1 概览层:中等粒度的结构化总结
- L2 细节层:完整原文,按需深入
打个比方:你查 GitHub 项目的 issue,先看标题(L0),再扫几个相关 issue 摘要(L1),最后才点进具体讨论(L2)。Token 用量按层级指数级递减。
2. viking:// 协议
所有上下文(用户偏好、项目记忆、Agent 技能、代码片段)都挂在 viking:// 路径下:
viking://user/alice/memories/preferences
viking://project/website/content/articles
viking://skills/code-review/checklist
Agent 用 viking ls、viking tree、viking find 浏览,和操作本地文件一样的语义。
3. 目录递归检索
向量搜索先定位最高分的"目录",再逐层深入到具体文件 —— 既保证召回率,又保证上下文完整性。
4. 可观测的检索轨迹
每次检索都留下完整的"目录浏览路径",你可以审计 Agent 「为什么会召回这条记忆」。
5. Session 转长期记忆
会话结束后自动异步提取用户偏好和 Agent 经验,写入长期记忆层。
6. 多模态资源
支持项目文档、代码库、网页、用户偏好、Agent 技能等多种上下文类型。
三、性能数据与项目状态
| 指标 | 数值 |
|---|---|
| 当前总星数 | 29,563(2026-08-19) |
| 今日增量 | +2,304⭐(GitHub Trending 第1) |
| 项目创建 | 2026-01-05 |
| 许可证 | AGPL-3.0(传染性开源) |
| 上下文容量 | 理论上无上限(按需加载) |
AGPL 许可证提醒:AGPL-3.0 是传染性最强的开源协议之一。如果你要基于 OpenViking 开发闭源 SaaS 服务,有合规风险 —— AGPL 要求 SaaS 也必须开源衍生作品。个人项目、本地部署、内部工具影响不大;商业产品上线前建议咨询法务。
四、安装与上手
4.1 三种安装方式
# 方式1:pip 安装(最快)
pip install openviking

# 方式2:Docker 快速体验
docker run -p 8000:8000 openviking/openviking

# 方式3:源码部署(想魔改的)
git clone https://github.com/volcengine/OpenViking
cd OpenViking
pip install -e .
4.2 Python SDK 5 行代码体验
from openviking import VikingClient

client = VikingClient()

# 写入用户偏好
client.set("viking://user/alice/memories/preferences",
           {"writing_style": "简洁直接"})

# 检索偏好
results = client.find("viking://memories/", query="用户偏好")
print(results)
启动服务:
openviking server # 默认监听 8000 端口五、与同类项目对比
| 维度 | OpenViking | ai-memory | TencentDB Agent Memory | Supermemory |
|---|---|---|---|---|
| 架构 | 虚拟文件系统 | SQLite + 文件 | 关系型数据库 | 向量数据库 |
| 检索方式 | 目录递归 | 向量相似度 | SQL 查询 | 向量搜索 |
| 上下文分层 | L0/L1/L2 三层 | 无明确分层 | 无 | 简单标签 |
| 可观测性 | 完整检索轨迹 | 有限 | 有限 | 无 |
| 协议 | viking:// | CLI 原生 | DB 原生 | API |
| 许可证 | AGPL-3.0 | Apache 2.0 | 未详 | 未详 |
| 厂商背书 | 字节跳动 | 社区 | 腾讯 | 社区 |
| 增长势头 | 🔥 今日 +2,304 | +730(昨日) | 一般 | 一般 |
OpenViking 在「可观测性」和「分层加载」两个维度上有明显优势 —— 这两点对生产环境 AI Agent 至关重要。
六、可借鉴的 3 个设计思路
即使你不直接用 OpenViking,下面 3 个设计思想也值得迁移到自己的 AI 工作台:
6.1 L0/L1/L2 分层加载
不要把所有上下文平铺塞进 prompt,而是按「摘要 → 概览 → 细节」三级组织。需要细节时再 find() 拉具体内容。
6.2 路径语义化(viking://)
用语义化路径组织不同类型的上下文(用户偏好 / 项目记忆 / 团队知识),而不是把所有数据扔进一个向量库。路径本身就是元数据。
6.3 检索轨迹可观测
每次记忆召回都记录「为什么召回这条」(命中关键词 / 向量得分 / 路径)—— 排查 Agent "幻觉" 时比单纯看结果有效得多。
七、电商场景适配点
对于电商团队来说,OpenViking 的设计思路特别适合这两个场景:
| 场景 | 应用方式 |
|---|---|
| 客服 Agent | 把「用户历史订单」「常见问题」「售后政策」挂在 viking:// 路径下,按需加载避免 prompt 膨胀 |
| 选品 Agent | 把「历史爆款 SKU」「用户评价」「竞品数据」用 L0/L1/L2 分层,按查询复杂度自动加载 |
但要提醒:AGPL 许可证是商业部署的最大门槛 —— 自营产品 + SaaS 上线前务必走法务评估。如果你只是团队内部使用,影响很小。
八、常见问题
Q1:OpenViking 跟 MemGPT / LangChain Memory 有什么不同?
A:MemGPT 偏研究、LangChain Memory 是 LLM 框架的一部分。OpenViking 更像「生产级上下文数据库」—— 有完整 API、有可观测性、有分层机制,适合做长期基础设施。
Q2:必须用 AGPL-3.0 吗?
A:是的,AGPL-3.0 是字节跳动选定的开源协议,没有商业版本。如果 AGPL 不兼容你的业务,可以借鉴它的设计思想(分层、路径化、可观测)自己实现。
Q3:能跟现有的 LangChain / LlamaIndex 集成吗?
A:OpenViking 是独立服务,通过 REST API 暴露能力。理论上可以包装成 LangChain 的 Memory 组件或 LlamaIndex 的 Storage 层,但需要二次开发。
Q4:本地跑得动吗?
A:可以。OpenViking 本身只是个上下文管理层,不依赖大模型。Docker 一行命令就能启动,CPU 都能跑。
九、总结
OpenViking 的核心价值不是「又一个向量数据库」,而是 重新定义了 AI Agent 与记忆的交互方式:从「调 API」变成「操作文件」。这种思路无论你最终用不用 OpenViking,都值得在自己的 AI 工作台里借鉴 —— 分层加载、路径语义化、检索可观测,这三件事能让你的 prompt 更省 Token、让你的 Agent 更容易调试。
如果你是个人开发者或小团队,OpenViking 可以直接上手体验;如果你是商业产品团队,建议先把它的设计思路迁移到自己的架构里,再单独评估合规风险。
🔗 资源链接
- GitHub 仓库:https://github.com/volcengine/OpenViking