
这是学习的时代,到处参加讲座,录音、拍照,手头攒下大把培训音视频和图片……
老师讲得很投入,录屏也存得整整齐齐。 但三个月后再也想不起哪场培训里到底讲了什么。
我们需要的是把每一堂课沉淀成可检索、可发、可审核的知识库。
于是我用 RTX 3090 + 64GB 内存,搭了一条本地流水线,效果让我自己也吃了一惊。
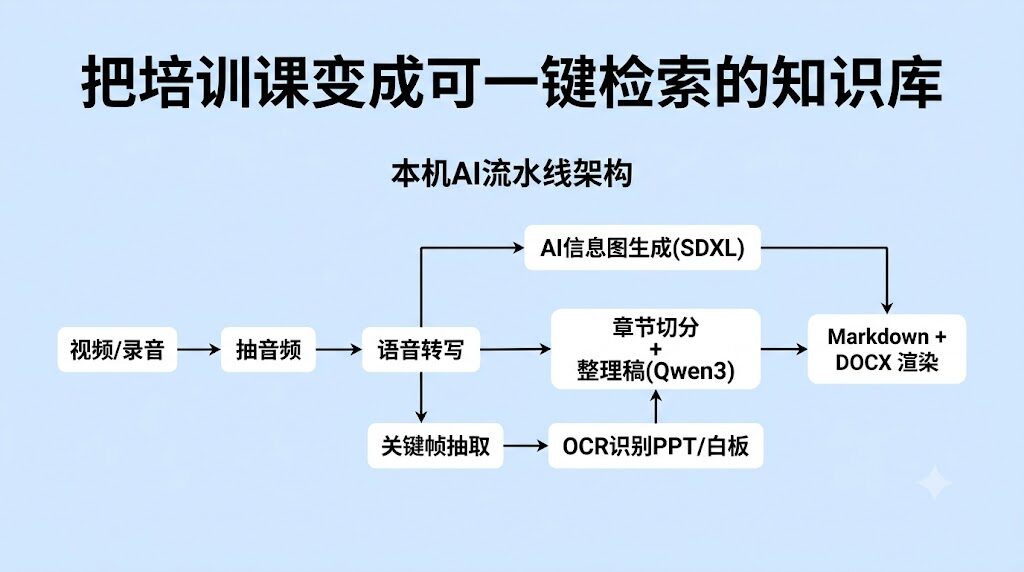
流水线到底做了什么
输入是 workspace/inbox/课程名/ 下面一堆 mp4 / m4a / 资料图。 输出一份 Markdown + Word 讲义,里面有逐字稿、整理稿、关键画面截图、AI 自动生成的解释型信息图。
一条命令跑完,全程离线:
uv run law run workspace/inbox/电商库存管理/2026-07-15/跑完之后,output/lecture.md 和 output/lecture.docx 就是成品,可以直接发到飞书或者丢进 Obsidian。
整条流水线长什么样
关键技术选型
我尝试过两条路线,最后都收敛到了"本地优先 + 云端兜底":
- 语音转写:
Faster-Whisper large-v3,CUDA fp16。一段 1.5 小时的普通话录音,10 分钟左右出逐字稿,准确率比我手动听写高得多。 - 关键帧抽取:
不再傻乎乎每 30 秒抽一张。先用 Faster-Whisper 拿到带时间戳的段落,再用 PySceneDetect 检测镜头切换,两者并集后 8 秒去抖动,最后用 pHash 去重。一堂课通常只留 30~60 张关键画面。 - OCR:
RapidOCR(ONNX 本地推理)。PPT、白板、流程图全都能识别,置信度高的直接进入整理稿作为引用块。 - 章节切分与整理:
本地 Ollama 跑 Qwen3-14B。它把逐字稿切成 90s~8min 的章节,按"概述 + 要点列表 + 引用关键帧"格式输出整理稿,并主动标注哪些段落需要 AI 配图。 - AI 配图:
本地 SDXL Base + Refiner。每个"这里需要图"的位置生成一张 1024×640 的解释型信息图——比如"库存周转率计算流程图",由模型自动出图。 - 交付渲染:
python-docx 出 Word,jinja2 出 Obsidian 风格 Markdown,图片都走相对路径,发给同事或者丢进知识库都顺手。
一堂课的实测结果
我拿了一段 1 小时 22 分钟的内部培训(普通话 + 英文术语)跑了一轮:
| 环节 | 耗时 |
|---|---|
| 抽音频 + 切片 | 18 秒 |
| Faster-Whisper large-v3 转写 | 9 分 10 秒 |
| 关键帧抽取 + 去重 | 1 分 45 秒 |
| RapidOCR | 47 秒 |
| Qwen3-14B 章节切分 + 整理稿 | 6 分 30 秒 |
| SDXL 生成 12 张配图 | 11 分钟 |
| 渲染 Markdown + DOCX | 4 秒 |
| 总计 | 约 29 分钟 |
12 张 AI 配图质量稳定可读,整理稿把口头语都压掉了,关键术语和数字一个不差。 关键帧和 AI 配图明确分类:原图用于佐证事实,生成图用于解释概念,两者在文档里用不同排版区分。
谁适合抄这套方案
如果你也满足以下任意一条,这套流水线大概率能帮上忙:
- 手上有大量培训录像、访谈录音、内部讲座,希望沉淀成知识库。
- 公司对数据合规敏感,不能把原始资料发给 ChatGPT 或 Claude。
- 有一张 RTX 3090 / 4090 级别的显卡 + 64GB 内存。
- 不追求花哨 Web UI,只想要稳定的"丢进去、出文档"。
我踩过的几个坑
坑 1:一开始按"每 30 秒抽帧"写代码。 结果 80% 的关键帧都是老师讲话的同一张脸,PPT 被淹没。改成"ASR 段落断点 + 镜头切换"后,命中率从 ~15% 提升到 ~70%。
坑 2:用 Qwen2.5-VL "看图总结"。 视觉模型擅长理解,但不适合把 PPT 文字精确抄下来。改成 RapidOCR + Qwen3 二次整理,准确率直接拉满。
坑 3:图片生成时没禁用负面提示词。 SDXL 生成的图里莫名其妙出现水印、英文单词、和奇怪的 logo。统一负面提示词禁用文字、水印、品牌后稳定下来。
坑 4:第一次写脚本没做断点续跑。 跑到第 11 张图显存溢出,从头再来浪费 20 分钟。补上 state.json + resume 命令后,任意阶段失败都能接着来。
这套方案的下一步
接下来我准备把它推进到三个方向:
- 自动评测:用 BLEU 和事实一致性指标评估整理稿质量,避免 LLM 越改越离谱。
- 可检索知识库:把所有产出的 Markdown 接进向量数据库(Chroma),做一个内部问答机器人。
- 批量调度:现在一次处理一堂课,加个队列就能批量处理一整季度的培训。
你可以怎么开始
我把整个计划、规格、代码骨架都拆成了 16 个 TDD 任务,从项目初始化到 CLI 编排都有测试和提交。 如果你想抄这套,只需要:
git init
uv init --python 3.11
# 复制 pyproject.toml 和 src/,然后逐任务跑测试
让每一堂培训课都不再被遗忘——这是这套流水线最大的价值。