
一个人学习最难的从来不是找到资料,而是把"问—答—练—查—思"这条链路跑通。今天要拆解的 DeepTutor,正是把这条链路串成一个永久在线的 AI 辅导老师的开源项目。
一、项目速览:DeepTutor 是什么
DeepTutor(全称 DeepTutor: Lifelong Personalized Tutoring)由港大数据智能与系统实验室 HKUDS Group 主导开发,最新版本 v1.5.1,Apache 2.0 协议,技术论文已发布到 arXiv(编号 2604.26962)。
它不是又一款 ChatGPT 套壳,而是一个 "agent-native"(智能体原生)的学习工作空间。把辅导、问答、测验生成、研究、可视化、掌握度训练全部装进同一个 Agent 循环,再配合可扩展的知识库与可审计的记忆系统,做到"越用越懂你"。
一句话总结:装上 DeepTutor,等于给自己请了一个不会下班、不会发脾气的全科辅导老师。
二、核心能力:它能帮你做什么
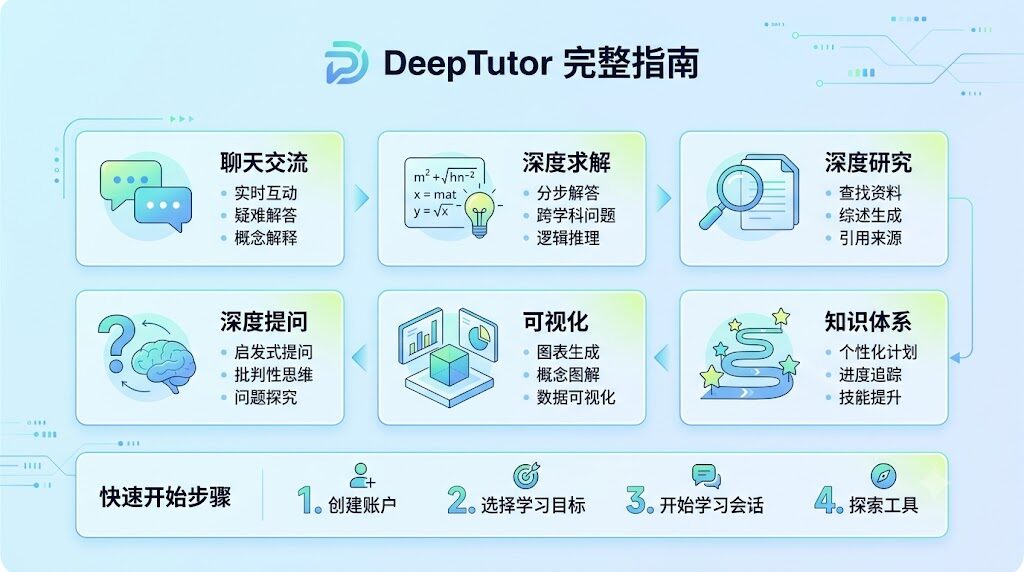
DeepTutor 把学习拆成 6 大能力,全部由同一个 Agent 循环驱动:
| 能力 | 作用 |
|---|---|
| Chat | 普通对话,可挂载知识库、笔记本、问题库做精准问答 |
| Deep Solve | 深度解题,逐步拆解数学/逻辑/代码难题 |
| Deep Research | 自动调研一个主题,输出报告式综述 |
| Deep Question | 根据上下文出题、做练习、生成测验 |
| Visualize | 把抽象概念转换成图表/动画/交互 HTML |
| Mastery Path | 根据你的掌握度规划个性化学习路径 |
- 多引擎知识库:LlamaIndex(默认)、PageIndex、GraphRAG、LightRAG、LightRAG Server、Obsidian vault 自由切换
- 三层可审计 Memory:L1 事件追踪 → L2 主题摘要 → L3 跨主题综合,每条结论都可追溯到原始对话
- Book Engine:把多份资料编译成"活的电子书",里面能嵌测验块、Manim 动画块、交互 HTML 块
- 15 个 IM 通道:飞书、Telegram、Slack、Discord、钉钉、QQ/NapCat、企业微信、WhatsApp、Zulip、Mattermost、Matrix、Mochat、Teams 等
- Subagent 调度:可拉起本地 Claude Code、Codex 或自定义 Partner 协同干活
- 技能市场:内置工具 + MCP 服务器 + 图像/视频/语音生成模型,支持从 EduHub/ClawHub 安装社区技能
三、谁最该用 DeepTutor
按"上手即赚到"的程度排序:
- 自学者 / 考研党:需要把厚书读薄、需要人出题讲解
- 研究生 / 科研人员:要快速综述某个细分方向、要管理大量论文笔记
- 程序员 / 算法工程师:想让 AI 真正理解自己的代码库再问答,而不是从通用语料瞎答
- 教师 / 培训师:要批量生成讲义、习题、可视化动画
- 企业内训负责人:要在内网部署多用户隔离的工作区,保护知识资产
如果你只是偶尔问问 ChatGPT 就能解决的小问题,DeepTutor 会显得"杀鸡用牛刀";但只要你的学习/研究链路需要长期沉淀知识,DeepTutor 的记忆系统和知识库价值就会指数级显现。
四、运行平台与硬件要求
DeepTutor 本质是一套"前端 + 后端 + Agent"的 Web 应用,本地、服务器、容器都能跑。
最低配置:
- Python 3.11+
- Node.js 20+(源码安装推荐 22 LTS)
- 4 GB 内存 + 多核 CPU(不跑本地大模型时够用)
- 10 GB 磁盘(基础运行 + 知识库索引)
跑本地大模型时:
- GPU 显存 ≥ 8 GB(7B 量化模型)或 ≥ 24 GB(14B+ 全精度)
- 硬盘 50 GB+(模型 + 缓存)
- 支持的本地推理服务:Ollama、LM Studio、llama.cpp、vLLM、Lemonade、NVIDIA NIM
操作系统:Linux / macOS 全功能支持;Windows 通过 WSL2 或 Docker 跑体验最佳(纯原生 Python 也能装,但部分依赖兼容性较差)。
五、四种安装方式详解
DeepTutor 共享同一套 data/user/settings/ 配置布局,所以任选一种装完,后面配置流程一模一样。
方式一:PyPI 一键安装(推荐新手)
适合只想用、不想折腾源码的人:
mkdir -p my-deeptutor && cd my-deeptutor
pip install -U deeptutor
deeptutor init     # 交互式向导:选端口 + LLM 提供方 + 可选 embedding
deeptutor start    # 同时启动后端和前端
启动后浏览器打开 http://127.0.0.1:3782 即可。
方式二:源码安装(开发者首选)
git clone https://github.com/HKUDS/DeepTutor.git
cd DeepTutor
python3 -m venv .venv && source .venv/bin/activate
python -m pip install --upgrade pip
python -m pip install -e .
( cd web && npm ci --legacy-peer-deps )
deeptutor init
deeptutor start
--legacy-peer-deps 是必须的,前端依赖有 peer 冲突。
方式三:Docker(最省心)
docker run --rm --name deeptutor \
  -p 127.0.0.1:3782:3782 \
  -v deeptutor-data:/app/data \
  ghcr.io/hkuds/deeptutor:latest
只需暴露 3782 一个端口,容器内 Next.js 中间件会自动把 /api/ 与 /ws/ 转发到后端。
如果你的 LLM 跑在宿主机本地(例如本机 Ollama),需要加 --add-host 让容器能访问宿主机:
docker run --rm --name deeptutor \
  -p 127.0.0.1:3782:3782 -p 127.0.0.1:8001:8001 \
  --add-host=host.docker.internal:host-gateway \
  -v deeptutor-data:/app/data \
  ghcr.io/hkuds/deeptutor:latest
方式四:仅 CLI(命令行党)
git clone https://github.com/HKUDS/DeepTutor.git
cd DeepTutor
python3 -m venv .venv-cli && source .venv-cli/bin/activate
python -m pip install --upgrade pip
python -m pip install -e ./packaging/deeptutor-cli
deeptutor init --cli
deeptutor chat
不需要浏览器,纯终端交互。
可选扩展
按需叠加:
pip install -e ".[partners]"        # IM 通道 SDK + MCP client
pip install -e ".[matrix]"          # Matrix(无 E2EE)
pip install -e ".[matrix-e2e]"      # Matrix E2EE(需 libolm)
pip install -e ".[math-animator]"   # Manim 动画插件(需 LaTeX/ffmpeg)
六、关键配置:从 0 到能用
deeptutor init 会自动在 data/user/settings/ 下生成一批 JSON/YAML 文件,改这些文件 = 改应用行为。最常用的 4 个:
| 文件 | 作用 |
|---|---|
model_catalog.json |
LLM、Embedding、搜索服务提供方 + API Key + 激活模型 |
system.json |
后端/前端端口、CORS、SSL 校验、附件目录、沙箱开关 |
interface.json |
UI 语言、主题、侧边栏偏好 |
agents.yaml |
各能力/工具的温度、token 上限 |
编辑 model_catalog.json,在 providers 里填:
{
  "providers": {
    "openai": {
      "type": "openai",
      "api_key": "sk-xxx",
      "base_url": "https://api.openai.com/v1",
      "models": ["gpt-4o", "gpt-4o-mini"]
    },
    "anthropic": {
      "type": "anthropic",
      "api_key": "sk-ant-xxx",
      "models": ["claude-sonnet-4-6", "claude-haiku-4-5"]
    }
  },
  "active": {
    "llm": "openai/gpt-4o",
    "embedding": "openai/text-embedding-3-small"
  }
}注意:不要把 API Key 写进任何 Git 仓库,建议放进 .gitignore。
6.2 接入本地 Ollama
先在宿主机跑:
ollama pull llama3.1
ollama pull nomic-embed-text
然后 model_catalog.json:
{
  "providers": {
    "ollama-llm": {
      "type": "openai",
      "base_url": "http://host.docker.internal:11434/v1",
      "api_key": "ollama",
      "models": ["llama3.1"]
    },
    "ollama-embed": {
      "type": "ollama_embed",
      "base_url": "http://host.docker.internal:11434/api/embed",
      "models": ["nomic-embed-text"]
    }
  },
  "active": {
    "llm": "ollama-llm/llama3.1",
    "embedding": "ollama-embed/nomic-embed-text"
  }
}
容器内 localhost 指的是容器自己,必须用 host.docker.internal。其他本地服务(LM Studio / llama.cpp / Lemonade)的 URL 见官方表格:
- LM Studio:
http://host.docker.internal:1234/v1 - llama.cpp:
http://host.docker.internal:8080/v1 - Lemonade:
http://host.docker.internal:13305/api/v1
6.3 鉴权与多用户
auth.json 开启鉴权后即可支持多用户隔离工作区,仅管理员可安装技能、配置全局模型,适合企业内部部署。
6.4 沙箱与安全
DeepTutor 内置的 docx/pdf/pptx/xlsx 技能会让模型生成 Python 脚本执行。system.json 里的 sandbox_allow_subprocess 控制是否允许,默认 true。生产环境建议改为 false,并通过 DEEPTUTOR_SANDBOX_RUNNER_URL 路由到最小权限的 sidecar 容器。
七、使用方法:Web UI 与 CLI 并行
7.1 Web UI 三步上手
- 打开
http://127.0.0.1:3782 - 在左侧"知识库"上传 PDF/Word/Markdown 或整个文件夹
- 顶栏切换能力:Chat → Deep Solve → Deep Research…
关键交互:
- 工具栏按
+可一次附加:文件、聊天历史、书籍、笔记本、问题库 - 切换 subagent 模型、知识库、persona、voice 后设置"粘性",所有后续对话沿用
- 每个回答右侧能看到 Memory 来源链(L1 → L2 → L3),方便回溯
7.2 CLI 交互式 REPL
deeptutor chat                                          # 进入 REPL
deeptutor run chat "解释傅里叶变换" --tool rag --kb textbook
deeptutor run deep_solve "求 d/dx[sin(x^2)]" --tool reason
deeptutor run deep_research "调研 2026 年 RAG 进展" \
  --config mode=report --config depth=standard
7.3 Agent 流式编程(高级玩法)
任何 run 命令加 --format json 输出 NDJSON 事件流:
deeptutor run deep_solve "Find d/dx[sin(x^2)]" --tool reason --format json每行带 session_id,事件类型包括 content / tool_call / tool_result / done。这意味着你可以把 DeepTutor 当成 Agent 后端,嵌进自己的脚本或工作流:
SID=$(deeptutor run deep_research "Survey 2026 papers on RAG" \
  --config mode=report --config depth=standard --format json \
  | jq -r 'select(.type=="done").session_id')

deeptutor run deep_question "Quiz me on that survey" \
  --session "$SID" --format json
7.4 完整命令速查
| 命令 | 用途 |
|---|---|
deeptutor init |
初始化/更新工作区配置 |
deeptutor start |
启动后端 + 前端 |
deeptutor serve --port 8001 |
只启动后端 |
deeptutor run |
单次能力执行 |
deeptutor chat |
交互式 REPL |
deeptutor partner list/start |
管理 IM 通道 Partner |
deeptutor kb list/info/create/add/search |
管理知识库 |
deeptutor skill search/install/list/remove |
技能管理(支持 eduhub:) |
deeptutor memory show/clear |
查看/清理 L1-L3 记忆 |
deeptutor session list/show/open |
共享会话管理 |
deeptutor notebook list/create/add-md |
笔记本管理 |
deeptutor book list/health |
检查 Book Engine |
deeptutor config show |
打印配置摘要 |
deeptutor provider login |
OAuth 登录(Codex、GitHub Copilot) |
八、进阶集成:让 Claude Code 调 DeepTutor
如果你已经在用 Anthropic 官方的 Claude Code(CLI),可以把 DeepTutor 当作"知识后端"接进来——Claude Code 负责自然语言理解和写代码,DeepTutor 负责查知识库、出题、深度调研。两者结合,相当于给你的 Claude Code 装上了一个永远不下班的私人家教。
8.1 准备工作
先确保 DeepTutor 已装好并能跑通 CLI:
# 安装 DeepTutor(任选一种方式)
pip install -U deeptutor
deeptutor init
deeptutor serve &        # 后台起后端,监听 8001 端口
deeptutor --version      # 确认 CLI 可用
然后在 Claude Code 里执行 deeptutor --help,能看到命令列表就说明通了。
8.2 零配置自动识别(SKILL.md 机制)
DeepTutor 仓库根目录自带一份 SKILL.md(约 150 行),相当于写给 AI Agent 的"交接手册"。只要你在 DeepTutor 仓库目录下启动 Claude Code,它会自动加载这份文件——不需要任何额外配置,Claude Code 就会知道有哪些命令、能力、参数。
cd /path/to/DeepTutor
claude                   # 启动 Claude Code,自动识别 SKILL.md
# 直接用自然语言:"帮我用 deep_research 调研一下 2026 年的 RAG 进展"
Claude Code 会自己解析意图,调用对应的 deeptutor run deep_research ... 命令。
8.3 在任意项目里调 DeepTutor(推荐姿势)
实际学习/开发时,你大概率不在 DeepTutor 仓库根目录。解决方案:在你自己项目里加一个 CLAUDE.md,告诉 Claude Code 怎么用 DeepTutor:
# CLAUDE.md(放到你项目根目录)

## 工具:DeepTutor
当需要查资料、出题、深度调研时,调用本地 DeepTutor CLI:
- `deeptutor kb list` 先确认默认知识库
- `deeptutor run deep_research "<问题>" --config mode=report --format json`
- `deeptutor run deep_question "<题目>" --session "$SID" --format json`
- 长任务用 `--session` 串联多轮

默认知识库名:my-textbook
输出格式:始终加 `--format json`,用 jq 提取关键字段。
这样在任意项目下启动 Claude Code,它都"知道"该用 DeepTutor 做什么。
8.4 进阶:自定义 Slash Command
把常用工作流封装成 /study、/quiz 这种斜杠命令,放到 ~/.claude/commands/:
<!-- ~/.claude/commands/study.md -->
---
description: 用 DeepTutor 深度研究一个主题
---

用户给的参数是研究主题。请按以下步骤调用 DeepTutor:

1. `deeptutor kb info my-textbook` 确认默认知识库
2. `deeptutor run deep_research "$ARGUMENTS" --config mode=report --config depth=standard --format json` 输出 NDJSON
3. 用 `jq` 解析每个事件:`.type=="content"` 取 `.text`、`.type=="done"` 取 `.session_id`
4. 拿 session_id 续一个 `deeptutor run deep_question "Quiz me on that research" --session "$SID" --format json`
5. 把研究结果和测验题整理成结构化 Markdown 报告
之后在 Claude Code 里直接:
/study 2026 年 RAG 技术最新进展
就自动跑完"调研 + 出题"全流程。
8.5 实操案例:用 Claude Code 当 DeepTutor 的自然语言前端
假设你在读一本机器学习教材,想让 Claude Code 帮你拆解并出题:
你:帮我用 DeepTutor 处理一下 ./pdfs/ml-book/ 这本书
Claude Code:
  → deeptutor kb create ml-book
  → deeptutor kb add ml-book ./pdfs/ml-book/
  → deeptutor kb set-default ml-book
  → deeptutor book list  # 确认 Book Engine 识别成功
你:跑一下 Mastery Path,生成第 3-5 章的学习路径
Claude Code:
  → deeptutor run mastery_path "ch3-5 learning path" --kb ml-book --format json
你:根据刚才的调研出 10 道选择题
Claude Code:
  → SID=$(... 提取 session_id ...)
  → deeptutor run deep_question "Generate 10 MCQs on chapter 3-5" --session "$SID" --format json
你:把第 7 题详细讲一下
Claude Code:
  → deeptutor run deep_solve "Explain Q7 in detail" --session "$SID" --format json
整个过程你只用自然语言,命令拼接、session 串联、JSON 解析全部由 Claude Code 完成。
8.6 注意事项
- CLI 和 Web UI 可同时跑:
deeptutor serve起后端,Web UI 用deeptutor start起,互不冲突 - Session 持久化:用
--session串联后,AI 始终带着上下文,token 利用率比单次调用高得多 - 错误处理:NDJSON 流里
type=="error"的事件要单独捕获,避免 jq 解析中断 - 安全:CLI 调用同样受
data/user/settings/配置控制,包括 API Key 鉴权和沙箱开关 - 不要与"技巧 6″混淆:那个是 DeepTutor 内部调 Claude Code(subagent 反向调用),这个是 Claude Code 调 DeepTutor(正向作为客户端)。两者可以同时开启,形成双向协作。
九、实战技巧:把 DeepTutor 用到极致
技巧 1:先建知识库,再开 Chat
新人常犯的错是直接 Chat,结果 AI 拿通用语料瞎答。正确姿势:
deeptutor kb create my-textbook
deeptutor kb add my-textbook ./pdfs/
deeptutor kb set-default my-textbook
之后再问问题,所有回答都会先召回知识库内容,引用一目了然。
技巧 2:把 Notebook 当长期记忆
每学完一章,往笔记本追加 Markdown:
deeptutor notebook create math-ch3
deeptutor notebook add-md math-ch3 ./notes/ch3.md
Chat 时通过 + 菜单挂载,AI 就能基于你自己的笔记回答,而不是通用知识。
技巧 3:Mastery Path 拆解一本书
把整本教材扔进 Book Engine,跑一次 Mastery Path:
- 系统自动拆章节、生成测验块、Manim 动画块、交互 HTML
- 根据你的答题情况动态调整后续章节难度
- 三层 Memory 自动记录薄弱点,下次开聊直接续上
技巧 4:组合能力形成流水线
Deep Research(综述)→ Deep Question(出题)→ Deep Solve(讲解)→ Mastery Path(规划复习)通过 --session 把同一会话串起来,AI 始终记得上下文,比每次重新提问省 80% token。
技巧 5:飞书/Telegram 联动
装好 partners 扩展后:
pip install -e ".[partners]"
deeptutor partner create study-bot --platform feishu
deeptutor partner start study-bot
扫码绑定后,在手机上就能随时问问题,所有记录自动同步到工作区。
技巧 6:用 Codex/Claude Code 做 Subagent
DeepTutor 可以在解题时自动拉起本地的 Codex 或 Claude Code 子智能体协同:
// agents.yaml
subagents:
  coder:
    type: claude_code
    path: /usr/local/bin/claude
    model: opus
这样涉及复杂编程的题目,会由专业编程 Agent 接手,再把结果回写到 DeepTutor 主循环。
十、常见踩坑与注意事项
- Windows 原生装容易卡:优先用 WSL2 或 Docker,避免 PyMuPDF / MinerU 的原生编译问题
- 前端依赖必须
--legacy-peer-deps:Next.js 16 + React 19 的 peer 还没全适配 - 容器内访问宿主机:
localhost在 Docker 里是容器自己,用host.docker.internal或--network host - API Key 不进 Git:
data/user/settings/*.json默认在.gitignore,但多人协作时仍建议改环境变量注入 - 重建知识库别删老索引:系统会自动写入新
version-N目录,旧版本保留可回滚 - 多人部署必须开鉴权:否则用户工作区会互相串数据
- Skill 安装要小心:从 EduHub 安装第三方 Skill 时,确认来源可信,多用户部署仅管理员可装
- 长会话定期
/compact:DeepTutor 的 Memory 会随使用增长,CLI 长会话记得清理 L1 事件层
十一、写在最后
DeepTutor 的设计哲学很清晰:让 AI 不只是回答一次问题,而是真正陪伴一个人长期学习。
它的杀手锏不是某一个炫酷功能,而是把"知识库 + 记忆 + Agent 循环 + 可审计 + 可扩展"这五件事同时做扎实。对于学习者来说,这意味着:
- 不用每次都从头解释背景
- 不用把资料散落在各种 ChatGPT 对话里
- 不用担心 AI 编造引用,因为有 Memory 来源链
- 不用担心被供应商锁定,因为数据全在自己机器上
如果你是认真想长期学一门知识、做一项研究,把它装起来,用一个月,你会明显感觉到"AI 越来越懂我"。
现在,去 pip install -U deeptutor 吧。