
面向初学者的 PostgreSQL 实战入门,所有示例均可在 PostgreSQL 18 上顺序执行。
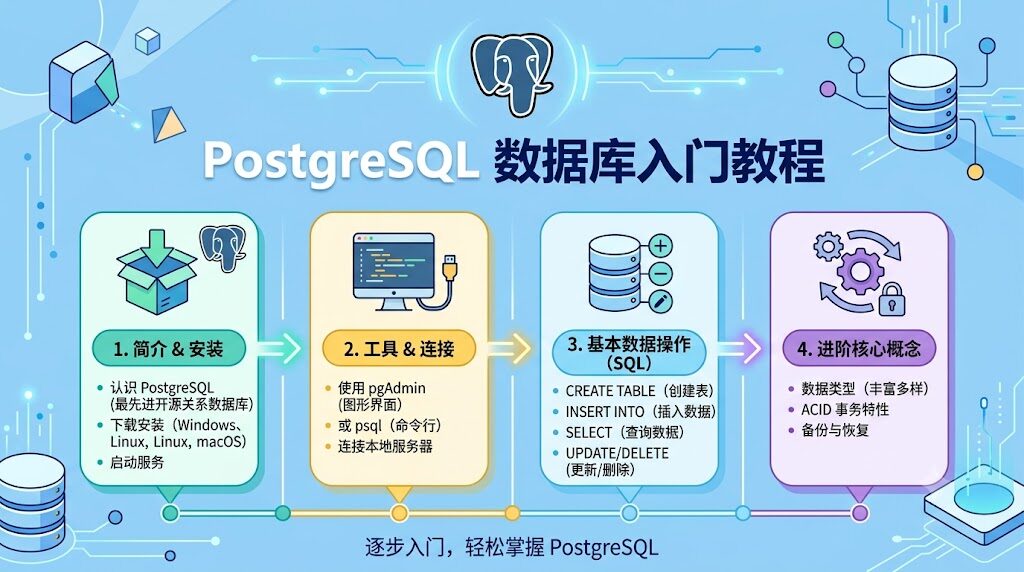
一、PostgreSQL 简介
PostgreSQL(社区通常简称 PG)是一款开源的对象-关系型数据库。 它的特点是稳定、标准兼容、扩展能力强。 对于初学者来说,先记住三点:
- 它支持完整的 SQL 标准,做数据迁移和学习成本相对友好
- 它采用 MVCC 机制,并发读写时不会相互阻塞
- 它有丰富的扩展(JSON、全文检索、地理信息等),几乎"开箱即用"
1.1 主要特点
- 开源免费:基于 PostgreSQL 许可证,可自由使用、修改和分发
- 标准兼容:高度支持 SQL 标准,覆盖大部分 SQL:2016 核心功能
- 数据类型丰富:支持 JSON、JSONB、数组、几何类型、全文检索等
- 扩展性强:支持自定义数据类型、函数、操作符、索引方法
- 事务安全:完整支持 ACID 特性,使用 MVCC 实现高并发
- 高可用:支持流复制、逻辑复制、热备等多种方案
1.2 版本与安装
截至 2026 年 7 月,官方仍在支持的稳定主版本为:
| 主版本 | 状态 | 终支持日期 |
|---|---|---|
| 18 | 当前最新 | 2030-11-14 |
| 17 | 支持中 | 2029-11-08 |
| 16 | 支持中 | 2028-11-09 |
| 15 | 支持中 | 2027-11-11 |
| 14 | 支持中,临近 EOL | 2026-11-12 |
不同系统的安装方式:
- Ubuntu/Debian:
apt install postgresql postgresql-contrib - CentOS/RHEL:
yum install postgresql-server postgresql-contrib - macOS:
brew install postgresql - Windows:从官网下载安装包或使用 Chocolatey
- Docker(推荐本地学习使用):
docker run -d \
  --name pg \
  -e POSTGRES_PASSWORD='ChangeMe_Please_2026!' \
  -p 127.0.0.1:5432:5432 \
  -v pg_data:/var/lib/postgresql/data \
  postgres:18
PostgreSQL 默认端口 5432,默认超级用户 postgres。
二、连接 PostgreSQL 数据库
2.1 psql 命令行工具
psql 是 PostgreSQL 自带的交互式客户端,是最常用的管理工具。
基本连接命令
# 本地连接(默认用户 postgres,默认数据库 postgres)
psql -U postgres

# 指定数据库连接
psql -U postgres -d mydb

# 连接远程数据库
psql -h 192.168.1.100 -p 5432 -U username -d dbname

# 强制提示输入密码
psql -h localhost -U postgres -d postgres -W
连接参数说明
| 参数 | 说明 | 示例 |
|---|---|---|
| -h | 数据库主机地址 | -h localhost |
| -p | 端口号,默认 5432 | -p 5432 |
| -U | 用户名 | -U postgres |
| -d | 数据库名 | -d mydb |
| -W | 强制提示输入密码 | -W |
退出 psql
\q
-- 也可以用
\quit
2.2 psql 常用元命令
\ 开头的命令叫元命令,可以快速查看数据库对象。
| 命令 | 功能 |
|---|---|
| \l | 列出所有数据库 |
| \c 数据库名 | 切换到指定数据库 |
| \dt | 列出当前 search_path 中可见的表 |
| \dt public.* | 列出 public 模式下的表 |
| \dt . | 列出所有 schema 中的表 |
| \d 表名 | 查看表结构 |
| \du | 列出所有用户/角色 |
| \dv | 列出所有视图 |
| \di | 列出当前 search_path 中可见的索引 |
| \dn | 列出所有 schema |
| \df | 列出所有函数 |
| \timing | 开启/关闭 SQL 执行耗时显示 |
| \e | 用编辑器编辑当前 query buffer;buffer 为空时编辑最近执行的查询 |
| \s | 查看命令历史 |
| \? | 查看所有元命令帮助 |
| \h 命令名 | 查看 SQL 命令语法帮助 |
小技巧:在 psql 中按 Tab 键 可以自动补全关键字和对象名。
三、查看数据库和表
3.1 查看所有数据库
-- 元命令
\l
-- 详细信息
\l+
-- SQL 方式
SELECT datname FROM pg_database;
-- 查看每个数据库大小
SELECT
datname AS database_name,
pg_size_pretty(pg_database_size(datname)) AS size
FROM pg_database
ORDER BY pg_database_size(datname) DESC;3.2 切换数据库
\c database_name
-- 示例:切换到 test 数据库
\c test
3.3 查看数据表
-- 列出当前 search_path 中可见的表
\dt

-- 列出所有 schema 中的表
\dt *.*

-- 列出指定 schema 的表
\dt public.*

-- 详细信息
\dt+
-- SQL 方式
SELECT table_name
FROM information_schema.tables
WHERE table_schema = 'public'
ORDER BY table_name;注意:
information_schema.tables也会返回视图;如果只想看表,请再加上table_type = 'BASE TABLE'。
3.4 查看表结构
\d users
-- 详细信息
\d+ users
SELECT
column_name,
data_type,
is_nullable,
column_default
FROM information_schema.columns
WHERE table_name = 'users'
AND table_schema = 'public'
ORDER BY ordinal_position;3.5 查看索引
-- 列出当前 search_path 中的索引
\di

-- 查看某张表的索引
\d users  -- 表结构中会显示索引

-- SQL 方式
SELECT
  indexname,
  indexdef
FROM pg_indexes
WHERE schemaname = 'public' AND tablename = 'users';
3.6 查看表数据量
-- 表大小(不含索引)
SELECT pg_size_pretty(pg_relation_size('public.users'));

-- 表总大小(含索引)
SELECT pg_size_pretty(pg_total_relation_size('public.users'));

-- 估算行数(快速,统计值)
SELECT reltuples AS estimated_rows
FROM pg_class
WHERE relname = 'users';

-- 精确行数(慢,全表扫描)
SELECT COUNT(*) FROM public.users;
pg_relation_size和pg_total_relation_size要求参数是regclass。 直接传'public.users'是可行的;如果你的表名来自拼接,请用format('%I.%I', schema, table)::regclass。
四、数据库管理
4.1 创建数据库
CREATE DATABASE dbname;-- 指定字符集和所有者
CREATE DATABASE mydb
WITH OWNER = postgres
ENCODING = 'UTF8'
LC_COLLATE = 'en_US.UTF-8'
LC_CTYPE = 'en_US.UTF-8'
TEMPLATE = template0;上面示例中的
en_US.UTF-8是 Linux/macOS 常见名称。Windows 上可用的 locale 名称不同,建议先在系统上用locale -a或locale命令确认后再填写。 如果新库的编码或 locale 与template1不同,就必须用TEMPLATE template0,避免template1中已有数据引发冲突。
# 命令行创建(不进入 psql)
createdb -U postgres mydb
4.2 删除数据库
DROP DATABASE dbname;

-- 不存在不报错
DROP DATABASE IF EXISTS dbname;
dropdb -U postgres mydb删除数据库是不可逆操作。不能连接到目标数据库后再执行 DROP DATABASE,请先
\c postgres切到其他数据库。 如果数据库上还有连接,可以使用DROP DATABASE mydb WITH (FORCE);让 PostgreSQL 主动断开连接;但当存在 prepared transaction、活动逻辑复制槽或订阅时仍会失败。 PostgreSQL 13 起支持WITH (FORCE),老版本需要先手动结束连接。
4.3 重命名数据库
ALTER DATABASE old_name RENAME TO new_name;4.4 修改数据库配置
-- 修改数据库连接数限制
ALTER DATABASE mydb CONNECTION LIMIT 100;

-- 设置数据库级别的参数
ALTER DATABASE mydb SET search_path TO public, myschema;
-- 查看数据库级 GUC 设置
SELECT
d.datname,
s.setconfig
FROM pg_db_role_setting AS s
JOIN pg_database AS d ON d.oid = s.setdatabase
WHERE d.datname = 'mydb' AND s.setrole = 0;
ALTER DATABASE ... SET的设置存放在pg_db_role_setting,不能通过SELECT * FROM pg_database查到。
4.5 数据库备份与恢复
备份数据库
# 备份为 SQL 脚本
pg_dump -U postgres -d mydb > mydb_backup.sql

# 备份为自定义压缩格式(推荐,体积小、恢复快)
pg_dump -U postgres -Fc mydb > mydb_backup.dump

# 只备份表结构
pg_dump -U postgres -s mydb > mydb_schema.sql

# 备份指定的表
pg_dump -U postgres -t public.users -t public.orders mydb > tables_backup.sql
恢复数据库
# 从 SQL 脚本恢复
psql -U postgres -d newdb < mydb_backup.sql

# 从自定义格式恢复(并行恢复更快)
pg_restore -U postgres -d newdb -j 4 mydb_backup.dump

# 先创建空库再恢复
createdb -U postgres newdb
pg_restore -U postgres -d newdb mydb_backup.dump
备份整个实例
pg_dumpall -U postgres > all_databases.sql
psql -U postgres -f all_databases.sql postgres
五、数据表管理
本章会建立贯穿整本教程的示例表:
users、orders、accounts。 后续章节的 INSERT/SELECT/JOIN 等示例都基于这套表。
5.1 创建数据表
-- 用户表
CREATE TABLE users (
  id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  username VARCHAR(50) NOT NULL UNIQUE,
  email VARCHAR(100) NOT NULL,
  age INTEGER CHECK (age >= 0),
  status VARCHAR(20) DEFAULT 'active',
  meta_data JSONB,
  created_at TIMESTAMPTZ DEFAULT CURRENT_TIMESTAMP,
  updated_at TIMESTAMPTZ
);

-- 订单表
CREATE TABLE orders (
  id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  user_id BIGINT NOT NULL REFERENCES users(id),
  order_no TEXT NOT NULL UNIQUE,
  amount NUMERIC(12, 2) NOT NULL,
  created_at TIMESTAMPTZ DEFAULT CURRENT_TIMESTAMP
);

-- 账户余额表(用于事务示例)
CREATE TABLE accounts (
  id BIGINT GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  balance NUMERIC(12, 2) NOT NULL DEFAULT 0
);
常用数据类型速查
| 分类 | 类型 | 说明 |
|---|---|---|
| 数值 | INTEGER | 整数,约 ±21 亿 |
| 数值 | BIGINT | 大整数,约 ±9.22 × 10¹⁸ |
| 数值 | NUMERIC(p, s) | 精确小数,适合金额 |
| 字符串 | VARCHAR(n) | 变长字符串,n 是声明长度上限 |
| 字符串 | TEXT | 变长字符串,没有声明长度(实际仍受 1 GB TOAST 限制) |
| 字符串 | CHAR(n) | 定长字符串,尾部空格按规则填充 |
| 时间 | DATE | 仅日期 |
| 时间 | TIMESTAMPTZ | 日期 + 时间 + 时区(推荐用于审计时间) |
| 布尔 | BOOLEAN | TRUE / FALSE |
| JSON | JSON / JSONB | JSONB 二进制存储且支持索引 |
| 数组 | TEXT[]、INTEGER[] | 一维数组,可建 GIN 索引 |
| 范围 | INT4RANGE、TSRANGE | 范围类型 |
| UUID | UUID | 全局唯一标识 |
常用约束
- PRIMARY KEY:主键,非空且唯一
- NOT NULL:不允许为空
- UNIQUE:值唯一
- DEFAULT value:默认值
- CHECK (条件):检查约束
- REFERENCES 表(字段):外键约束
5.2 修改表结构
-- 添加字段
ALTER TABLE users ADD COLUMN phone VARCHAR(20);

-- 带默认值
ALTER TABLE users ADD COLUMN is_vip BOOLEAN DEFAULT false;

-- 删除字段
ALTER TABLE users DROP COLUMN phone;

-- 修改字段类型
ALTER TABLE users ALTER COLUMN username TYPE VARCHAR(100);

-- 重命名字段
ALTER TABLE users RENAME COLUMN age TO user_age;

-- 设置/移除默认值
ALTER TABLE users ALTER COLUMN status SET DEFAULT 'inactive';
ALTER TABLE users ALTER COLUMN status DROP DEFAULT;

-- 添加唯一约束
ALTER TABLE users ADD CONSTRAINT unique_email UNIQUE (email);

-- 添加外键
ALTER TABLE orders ADD CONSTRAINT fk_orders_user
  FOREIGN KEY (user_id) REFERENCES users(id);

-- 删除约束
ALTER TABLE users DROP CONSTRAINT unique_email;
5.3 删除表
DROP TABLE table_name;
DROP TABLE IF EXISTS table_name;
-- 级联删除(同时删除依赖该表的对象)
DROP TABLE users CASCADE;
5.4 清空表数据
-- 快速清空表
TRUNCATE TABLE users;

-- 级联清空关联表
TRUNCATE TABLE users, orders CASCADE;
TRUNCATE 与 DELETE 的关键区别: –
TRUNCATE不逐行扫描表,速度比无条件DELETE快得多 –TRUNCATE会立即把磁盘空间还给操作系统,DELETE需要后续VACUUM才回收 –TRUNCATE是事务安全的,可以被ROLLBACK回滚 –TRUNCATE会获取ACCESS EXCLUSIVE锁,阻塞所有并发读写 –TRUNCATE不触发ON DELETE触发器,只触发ON TRUNCATE触发器 –TRUNCATE不是 MVCC-safe,并发事务在 TRUNCATE 之前建立的快照仍可能看到旧数据
-- 逐行删除(可回滚,可带 WHERE)
DELETE FROM users;
5.5 索引管理
-- 普通索引
CREATE INDEX idx_users_email ON users(email);

-- 唯一索引
CREATE UNIQUE INDEX idx_users_username ON users(username);

-- 多列索引
CREATE INDEX idx_orders_user_date ON orders(user_id, created_at);

-- 部分索引(只索引满足条件的行)
CREATE INDEX idx_active_users ON users(username) WHERE status = 'active';

-- JSONB 字段索引
CREATE INDEX idx_users_meta ON users USING gin (meta_data);
-- 查看表的索引
\d users
-- 删除索引
DROP INDEX idx_users_email;
BIGINT GENERATED ALWAYS AS IDENTITY是 PostgreSQL 10+ 的标准身份列写法,比老的SERIAL更明确。如果不想破坏主键对应的序列赋值,优先使用这种写法。
六、数据操作(增删改查)
6.1 插入数据
-- 插入单行
INSERT INTO users (username, email, age)
VALUES ('zhangsan', '[email protected]', 25);

-- 插入多行
INSERT INTO users (username, email, age) VALUES
  ('lisi',    '[email protected]',    30),
  ('wangwu',  '[email protected]',  28),
  ('zhaoliu', '[email protected]', 35);

-- 插入并返回数据
INSERT INTO users (username, email)
VALUES ('newuser', '[email protected]')
RETURNING id, created_at;
6.2 查询数据
-- 查询所有字段
SELECT * FROM users;

-- 查询指定字段
SELECT id, username, email FROM users;

-- 字段别名
SELECT username AS name, email AS contact FROM users;
条件查询
SELECT * FROM users WHERE id = 1;
SELECT * FROM users WHERE status <> 'active';
SELECT * FROM users WHERE age > 25;
SELECT * FROM users WHERE age BETWEEN 20 AND 30;
SELECT * FROM users WHERE username LIKE 'zhang%';
SELECT * FROM users WHERE email LIKE '%@example.com';
SELECT * FROM users WHERE status IN ('active', 'pending');
SELECT * FROM users WHERE updated_at IS NULL;
SELECT * FROM users WHERE updated_at IS NOT NULL;
SELECT * FROM users
WHERE status = 'active' AND age > 20 AND email IS NOT NULL;
排序与分页
SELECT * FROM users ORDER BY created_at ASC;
SELECT * FROM users ORDER BY age DESC;
SELECT * FROM users ORDER BY status ASC, age DESC;
SELECT * FROM users ORDER BY id LIMIT 10 OFFSET 20;
聚合与分组
SELECT COUNT(*) FROM users;
SELECT COUNT(*) FROM users WHERE status = 'active';

SELECT
  COUNT(*) AS total,
  AVG(age) AS avg_age,
  MAX(age) AS max_age,
  MIN(age) AS min_age,
  SUM(age) AS sum_age
FROM users;

SELECT status, COUNT(*) AS count
FROM users
GROUP BY status;

SELECT status, COUNT(*) AS count
FROM users
GROUP BY status
HAVING COUNT(*) > 0;
去重
SELECT DISTINCT status FROM users;6.3 更新数据
-- 更新单条记录
UPDATE users
SET email = '[email protected]', updated_at = NOW()
WHERE id = 1;

-- 批量更新
UPDATE users
SET status = 'inactive'
WHERE age > 60;

-- 更新并返回结果
UPDATE users
SET status = 'active'
WHERE id = 1
RETURNING *;
UPDATE 一定要带 WHERE 条件,否则会更新整张表。
6.4 删除数据
DELETE FROM users WHERE id = 1;
DELETE FROM users WHERE status = 'inactive';
DELETE FROM users WHERE id = 1 RETURNING *;
DELETE 不带 WHERE 会清空整张表。大表批量删除前建议先 SELECT 验证范围,并配合
VACUUM (ANALYZE)回收空间与更新统计。
6.5 联表查询
-- 内连接
SELECT u.username, o.order_no, o.amount
FROM users AS u
INNER JOIN orders AS o ON u.id = o.user_id;

-- 左连接:左表全部返回,右表无匹配为 NULL
SELECT u.username, o.order_no
FROM users AS u
LEFT JOIN orders AS o ON u.id = o.user_id;

-- 右连接
SELECT u.username, o.order_no
FROM users AS u
RIGHT JOIN orders AS o ON u.id = o.user_id;

-- 全连接
SELECT u.username, o.order_no
FROM users AS u
FULL OUTER JOIN orders AS o ON u.id = o.user_id;
6.6 事务
BEGIN;

UPDATE accounts SET balance = balance - 100 WHERE id = 1;
UPDATE accounts SET balance = balance + 100 WHERE id = 2;

-- 全部成功再提交
COMMIT;

-- 出错时回滚
-- ROLLBACK;
PostgreSQL 默认自动提交(autocommit),每条独立 SQL 都是一个事务。 用
BEGIN显式开启后,多条 SQL 会作为一个原子操作,要么全部成功,要么全部回滚。 上一节的TRUNCATE也能在事务中回滚,并不会绕过事务机制。
七、用户与权限管理
7.1 用户(角色)管理
PostgreSQL 中"用户"和"角色"本质是同一概念。 CREATE USER 是 CREATE ROLE ... LOGIN 的简写,因此 CREATE USER 创建的角色默认带 LOGIN 权限。
-- 创建可登录的用户
CREATE USER myuser WITH PASSWORD 'ChangeMe_Please_2026!';

-- 创建角色(默认不可登录)
CREATE ROLE readonly;

-- 完整创建示例
CREATE USER app_user
WITH PASSWORD 'ChangeMe_Please_2026!'
     LOGIN
     NOSUPERUSER
     NOCREATEDB
     NOCREATEROLE
     CONNECTION LIMIT 10
     VALID UNTIL '2026-12-31';
-- 查看用户列表
\du
-- SQL 方式
SELECT rolname, rolsuper, rolcanlogin, rolcreaterole, rolcreatedb
FROM pg_roles
ORDER BY rolname;-- 修改密码
ALTER USER myuser WITH PASSWORD 'ChangeMe_Please_2026!';
-- 重命名
ALTER USER oldname RENAME TO newname;
-- 授予/撤销创建数据库权限
ALTER USER myuser CREATEDB;
ALTER USER myuser NOCREATEDB;
-- 设置用户级参数
ALTER USER myuser SET search_path TO myschema, public;-- 删除用户
DROP USER myuser;
DROP USER IF EXISTS myuser;删除用户前需要先回收其权限并转移其拥有的对象,否则会报错。 PostgreSQL 16 之前,
CREATE USER创建的角色默认带INHERIT;从 16 开始可以通过NOINHERIT显式控制继承行为。
7.2 权限管理
权限类型
| 权限 | 说明 | 适用对象 |
|---|---|---|
| SELECT | 读取数据 | 表、视图、序列 |
| INSERT | 插入数据 | 表、视图 |
| UPDATE | 更新数据 | 表、视图 |
| DELETE | 删除数据 | 表、视图 |
| TRUNCATE | 清空表 | 表 |
| REFERENCES | 创建外键 | 表 |
| TRIGGER | 创建触发器 | 表 |
| CREATE | 创建对象 | 数据库、schema |
| CONNECT | 连接数据库 | 数据库 |
| USAGE | 使用 schema/序列 | schema、序列 |
| ALL PRIVILEGES | 所有权限 | — |
授予权限
GRANT SELECT ON users TO readonly;
GRANT SELECT, INSERT, UPDATE ON users, orders TO app_user;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO readonly;
GRANT USAGE ON SCHEMA public TO readonly;
GRANT CONNECT ON DATABASE mydb TO myuser;
GRANT CREATE ON SCHEMA public TO app_user;
GRANT ALL PRIVILEGES ON users TO myuser;
设置默认权限
-- 当前角色以后在 public 中创建的对象,自动向 readonly 授予 SELECT
ALTER DEFAULT PRIVILEGES IN SCHEMA public
GRANT SELECT ON TABLES TO readonly;
上面这条只影响"当前角色"以后创建的对象。 如果表由其他角色创建,需要加
FOR ROLE <创建者>子句,否则新建表不会自动授权。
撤销权限
REVOKE SELECT ON users FROM readonly;
REVOKE ALL PRIVILEGES ON users FROM myuser;
REVOKE SELECT ON ALL TABLES IN SCHEMA public FROM readonly;
查看权限
\dp usersSELECT grantee, privilege_type
FROM information_schema.role_table_grants
WHERE table_name = 'users';7.3 角色组与继承
-- 创建角色组
CREATE ROLE dev_team;

-- 给角色组授权
GRANT SELECT, INSERT ON ALL TABLES IN SCHEMA public TO dev_team;

-- 把用户加入角色组
GRANT dev_team TO alice;
GRANT dev_team TO bob;

-- 从组中移除用户
REVOKE dev_team FROM alice;
加入角色组的用户默认通过
INHERIT自动继承组的权限。 PostgreSQL 16 之前默认开启INHERIT;从 16 起可以通过NOINHERIT显式关闭。 关闭继承后,需要SET ROLE dev_team才能临时使用 dev_team 的权限。
7.4 Schema 管理
-- 创建 schema
CREATE SCHEMA myschema;

-- 指定所有者
CREATE SCHEMA myschema AUTHORIZATION myuser;

-- 切换搜索路径
SET search_path TO myschema, public;

-- 删除 schema
DROP SCHEMA myschema;
DROP SCHEMA myschema CASCADE;  -- 级联删除里面的所有对象
八、常用运维命令
8.1 查看数据库运行状态
-- 查看活跃连接
SELECT
  pid,
  usename AS username,
  datname AS database,
  client_addr AS client_ip,
  application_name,
  state,
  query_start,
  query
FROM pg_stat_activity
WHERE state = 'active'
ORDER BY query_start DESC;

-- 按数据库统计连接数
SELECT datname, COUNT(*) AS connections
FROM pg_stat_activity
GROUP BY datname
ORDER BY connections DESC;
-- 取消正在执行的查询
SELECT pg_cancel_backend(pid);
-- 强制断开连接
SELECT pg_terminate_backend(pid);
pg_terminate_backend的权限边界是"被终止端是否为超级用户"。 终止普通用户后端需要调用方是超级用户、或调用方是该角色成员、或拥有pg_signal_backend权限; 超级用户后端只能由其他超级用户终止。
-- 断开某个数据库上所有非超级用户连接
SELECT pg_terminate_backend(a.pid)
FROM pg_stat_activity AS a
JOIN pg_roles AS r ON r.oid = a.usesysid
WHERE a.datname = 'mydb'
  AND a.pid <> pg_backend_pid()
  AND NOT r.rolsuper;
8.2 查看数据库大小
-- 单个数据库大小
SELECT pg_size_pretty(pg_database_size('mydb'));

-- 所有数据库大小
SELECT
  datname AS database,
  pg_size_pretty(pg_database_size(datname)) AS size
FROM pg_database
ORDER BY pg_database_size(datname) DESC;
-- 表大小排行(按 schema 限定,避免命中系统表)
SELECT
schemaname || '.' || tablename AS table_name,
pg_size_pretty(
pg_total_relation_size(
format('%I.%I', schemaname, tablename)::regclass
)
) AS total_size,
pg_size_pretty(
pg_relation_size(
format('%I.%I', schemaname, tablename)::regclass
)
) AS table_size
FROM pg_tables
WHERE schemaname = 'public'
ORDER BY pg_total_relation_size(
format('%I.%I', schemaname, tablename)::regclass
) DESC
LIMIT 10;
pg_total_relation_size/pg_relation_size的参数是regclass。 当参数来自字符串拼接时,必须显式::regclass,否则会报"没有匹配函数"的错误。 拼接时使用format('%I.%I', ...)可以安全处理大小写、特殊字符和保留字。
8.3 慢查询与执行计划
-- 基本执行计划
EXPLAIN SELECT * FROM users WHERE id = 1;

-- 实际执行(带真实耗时和行数)
EXPLAIN ANALYZE SELECT * FROM users WHERE status = 'active';

-- 更详细的信息
EXPLAIN (ANALYZE, BUFFERS, VERBOSE)
SELECT * FROM users WHERE age > 25;
索引使用情况
SELECT
  relname AS table_name,
  idx_scan AS index_scans,
  seq_scan AS sequential_scans,
  n_live_tup AS live_rows
FROM pg_stat_user_tables
WHERE schemaname = 'public'
ORDER BY idx_scan DESC;

-- 单个索引的统计
SELECT
  indexrelname AS index_name,
  idx_scan AS times_used,
  idx_tup_read,
  idx_tup_fetch
FROM pg_stat_user_indexes
WHERE relname = 'users';
查找自上次统计重置以来未被使用的索引
SELECT
  schemaname || '.' || relname AS table_name,
  indexrelname AS index_name,
  pg_size_pretty(pg_relation_size(indexrelid)) AS index_size
FROM pg_stat_user_indexes
WHERE idx_scan = 0
  AND schemaname = 'public'
ORDER BY pg_relation_size(indexrelid) DESC;
idx_scan = 0仅表示"自上次统计重置以来没有扫描过这个索引"。 统计可能因为服务器崩溃、pg_stat_reset()、PITR 等被重置; 删除索引前还要排除主键/唯一约束、外键、低频任务(如月末报表)等场景。
8.4 VACUUM 与空间回收
-- 回收死元组空间
VACUUM users;

-- 整库回收
VACUUM;

-- 完全清理(把空间还给操作系统,会锁表)
VACUUM FULL users;

-- 回收空间 + 更新统计信息(推荐写法)
VACUUM (ANALYZE) users;

-- 只更新统计信息
ANALYZE users;
-- 查看死元组情况
SELECT
relname AS table_name,
n_live_tup AS live_rows,
n_dead_tup AS dead_rows,
ROUND(
n_dead_tup::numeric / NULLIF(n_live_tup + n_dead_tup, 0) * 100,
2
) AS dead_ratio_pct
FROM pg_stat_user_tables
WHERE schemaname = 'public'
ORDER BY n_dead_tup DESC;PostgreSQL 默认开启 autovacuum,通常无需手动执行。 大批量
DELETE/UPDATE后建议手动VACUUM (ANALYZE) <table>,一次完成空间回收和统计更新。ANALYZE不会回收空间,只更新pg_statistic,由它驱动规划器选择执行计划。
8.5 查看锁信息
-- 查看当前所有锁
SELECT
  pid,
  datname,
  relation::regclass AS table_name,
  mode,
  granted,
  query_start,
  query
FROM pg_locks l
JOIN pg_stat_activity a ON l.pid = a.pid
WHERE relation IS NOT NULL
ORDER BY query_start;
-- 查找被阻塞的查询
SELECT
blocked.pid AS blocked_pid,
blocked.query AS blocked_query,
blocking.pid AS blocking_pid,
blocking.query AS blocking_query
FROM pg_stat_activity AS blocked
JOIN pg_stat_activity AS blocking
ON blocking.pid = ANY(pg_blocking_pids(blocked.pid))
WHERE blocked.wait_event_type = 'Lock';直接自连接
pg_locks推断阻塞关系很容易出错:它不会反映锁模式冲突、等待队列顺序、并行 worker 等。 推荐用pg_blocking_pids(),它内部已封装好这些信息。
8.6 查看配置参数
-- 查看所有配置
SHOW ALL;

-- 查看单个参数
SHOW shared_buffers;
SHOW work_mem;
SHOW max_connections;
SHOW effective_cache_size;
-- SQL 方式
SELECT name, setting, unit, description
FROM pg_settings
WHERE name = 'shared_buffers';想让常用设置自动生效,可以把
\set/SET等命令写入~/.psqlrc,登录时自动加载。
九、图形化管理工具推荐
不同工具适合的场景不一样,下表给一个直观的对比。
| 工具 | 是否免费 | 跨平台 | 推荐场景 |
|---|---|---|---|
| pgAdmin | 完全免费 | 全平台 + Web | PG 专属运维、服务器端部署 |
| DBeaver | 社区版免费 | 全平台 | 多数据库统一管理 |
| DataGrip | 付费(学生/开源免费) | 全平台 | 专业开发、JetBrains 用户 |
| Navicat | 付费 | Win/Mac | 图形化偏好、数据同步 |
| TablePlus | 基础免费 | 全平台 | 轻量日常查询 |
新手建议从 DBeaver 社区版 或 pgAdmin 入手,二者免费且功能足够日常使用。
9.1 pgAdmin
PostgreSQL 官方推荐的图形化工具,适合在服务器上以 Web 方式部署后远程管理。
- 可视化管理数据库对象、用户权限、服务端配置
- 自带 SQL 编辑器,带语法高亮和 EXPLAIN 可视化
- 提供备份恢复、导入导出
9.2 DBeaver
通用数据库客户端,支持 PostgreSQL、MySQL、Oracle 等主流数据库。
- 统一的界面管理多种数据库
- 数据编辑器、ER 图、SQL 脚本批量执行
- 适合需要同时管理多套数据库的开发者
9.3 DataGrip
JetBrains 出品的专业数据库 IDE,付费软件(学生与开源项目可免费)。
- 业界较强的 SQL 智能补全和重构
- 与 JetBrains 全家桶(IDEA、PyCharm 等)无缝集成
- 适合已经在用 JetBrains 工具链的团队
9.4 Navicat for PostgreSQL
老牌商业数据库管理工具,界面友好。
- 直观的图形化操作,学习成本低
- 数据同步、结构同步向导完善
- 适合预算充足、偏好图形化的团队
9.5 TablePlus
轻量、原生设计的数据库客户端。
- 启动快、占用资源少
- 简洁的界面,多标签页与内联编辑
- 适合 macOS 用户的日常查询
附:快速上手检查清单
- [ ] 安装 PostgreSQL 18 并启动服务
- [ ] 使用 psql 连接(psql -U postgres)
- [ ] 创建第一个数据库(CREATE DATABASE mydb;)
- [ ] 切换数据库(\c mydb)
- [ ] 创建数据表(按 §5 的示例表)
- [ ] 插入测试数据(INSERT INTO users …)
- [ ] 练习增删改查(SELECT/UPDATE/DELETE)
- [ ] 创建普通用户并授予权限
- [ ] 用 \dt、\di、\d+ 查看对象
- [ ] 用 EXPLAIN ANALYZE 看一次执行计划
- [ ] 安装图形化工具连接验证
- [ ] 用 pg_dump 备份,再 pg_restore 恢复一次