
关于Lilian Weng
Lilian Weng(中文名翁荔)本科毕业于北京大学,之后在印第安纳大学获得博士学位;2017 年加入 OpenAI,在那里工作了整整 7 年。她在 OpenAI 内部一手创立了 Applied AI Research Team 和 AI Safety Team 两个团队——前者在业界做了很多关于"AI 学会解决复杂任务"的研究(比如让机械手解开魔方),后者则系统性地构建了 ChatGPT 用户今天仍在受益的行业安全标准。
在 OpenAI 的最后两年,她是研究与安全副总裁(VP of Research & Safety)。2024 年 11 月 15 日,她从 OpenAI 离开,目前是 Thinking Machines 的联合创始人。
但在所有这些身份之外,她还有一个不太起眼却影响深远的"小动作":她把过去十几年的研究心得,写成了叫 Lil'Log 的个人博客(lilianweng.github.io)。这个博客在 AI 圈被反复引用——不是因为她在里面讲了什么新颖的理论,而是因为她把很多论文里含糊带过的概念,用工程师能看懂的语言重新讲了一遍。
2026 年 7 月 4 日,她发表了新一篇长文《Harness Engineering for Self-Improvement》。我读完之后,第一反应是:这不是给科研工作者写的论文,而是给"每天都在被 AI 工程化拖下水"的工程师写的一份避坑指南。【查看全文译文 >>>】
短评
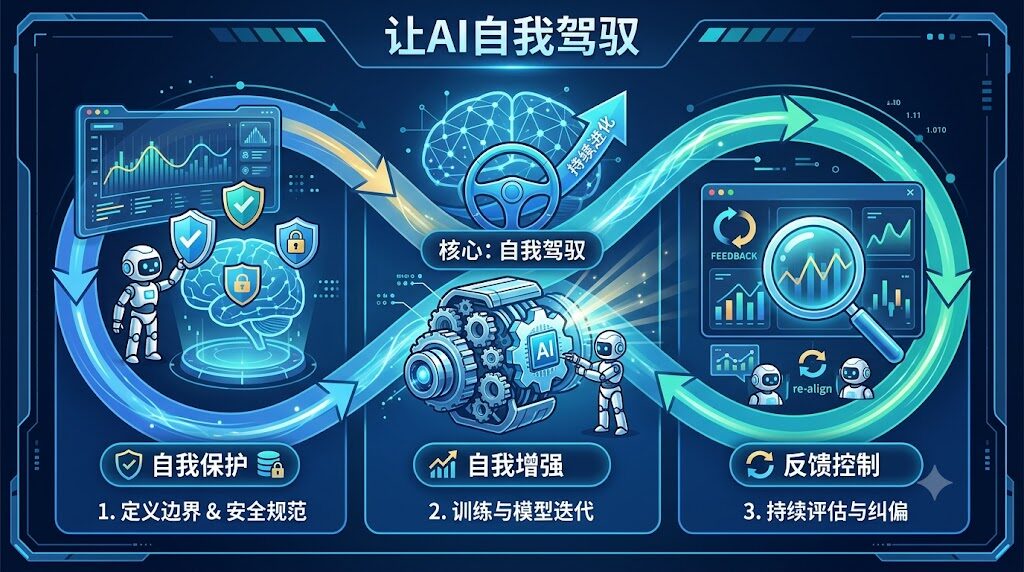
如果你只想记住一句话,请记住这句:"模型本身的智能是核心,但包裹模型的 harness 才是真正能让 AI 长期跑下去的东西。"
这句话并不新颖。但真正让我服气的是,Lilian 在一篇论文里把这件事拆解成了可执行的设计模式:文件系统作为记忆、失败模式聚类、有界变更、灰度发布、双层治理、演化搜索——每一种模式都有对应的开源实现、benchmark 数据和已知的失败陷阱。
我的整体评价:这是 2026 年 AI 工程化领域最值得反复精读的三篇长文之一(另外两篇分别是 Karpathy 的 autoresearch 和 Anthropic 的 Building Effective Agents)。它不是教你"做一个 AI",而是教你"怎么让 AI 不在凌晨 3 点把你的运维群炸了"。
下面是我读完后整理的学习笔记,按"原文洞见 → 我的工程化翻译 → OpenClaw 实战"三段式展开。
学习笔记 1:Harness 不是 prompt 工程,是运行时系统
【原文洞见】 Lilian 把 harness 定义为"包裹在基础模型之外的一整套系统——负责编排执行流程、决定模型如何思考与规划、如何调用工具、如何感知与管理上下文、如何保存工件、如何评估结果"。它更像运行时系统,而不是提示工程。
【我的翻译】 很多人以为"prompt 写得越花,AI 越聪明"。但真正让你半夜被报警叫醒的,从来不是 prompt 写得不够好——而是没有给 AI 一个合适的"运行环境"。
【OpenClaw 实战】 在 OpenClaw 里,harness 是你能直接配置的这些东西:
| Harness 概念 | OpenClaw 现实映射 |
|---|---|
| 工具接口 | toolsAllow: ["exec", "read", "write", "message", "web_fetch"] |
| 工作流 | cron 表达式 + message 模板 + bounded_propose 流程 |
| 持久化记忆 | memory/YYYY-MM-DD.md + MEMORY.md + LEARNINGS.md |
| 评估 | failure_cockpit.py + cron_canary.py 阈值告警 |
| 权限控制 | web_search provider 切换、channel 隔离 |
| 自我检查 | meta_audit.py + dgm_archive.py |
我的体会:把"AI 是否好用"从 prompt 维度切换到 harness 维度,是 OpenClaw 工程化的第一道分水岭。
学习笔记 2:把记忆放进文件系统,而不是塞进上下文
【原文洞见】 长程代理的工件(实验日志、代码 diff、错误栈、历史轨迹)规模远超上下文窗口。Harness 的关键设计之一是把这些工件保存在文件系统,而不是塞进上下文。
【我的翻译】 "上下文不够用"是大多数 AI 代理项目死亡的第一原因。原文给出的解药是反直觉的:别省着用,让 AI 自己管理文件。
【OpenClaw 实战】 OpenClaw 已经把这件事设计成了三层文件系统:
- 每日工作日志 →
memory/YYYY-MM-DD.md(不写到这里的教训,24 小时后随 session 一起被清空) - 跨会话长期知识 →
MEMORY.md的"进行中的任务"区块(团队唯一的台账) - 失败模式沉淀 →
.learnings/LEARNINGS.md(按 LRN-YYYYMMDD-NNN 编号,每条教训都能追溯)
我的体会:文件系统不是 OpenClaw 的"附件功能",而是它的"骨架"。Agent 失忆 = 文件没写。
学习笔记 3:失败模式必须分类,光看错误字符串没用
【原文洞见】 Self-Harness 的第一阶段叫"弱点挖掘"——把失败聚类为"由验证器锚定"的失败模式。两个失败的表面现象可能完全一样(如都报"超时"),但因果机制可能截然不同。
【我的翻译】 我以前看到 overloaded_error 就改 fallback,看到 timeout 就调大 timeout。这种"对症下药"是错的——你根本不知道这两个症状是不是同一个病因。
【OpenClaw 实战】 用 failure_cockpit.py(开箱即用)把 cron 失败自动分类为:
| 分类 | 含义 | 典型占比 |
|---|---|---|
model_overloaded |
模型过载(429 / 503) | 30% |
timeout |
exec 超过 60s | 20% |
model_not_found |
模型不存在 / 配置错 | 15% |
outbound_400 |
飞书投递失败 | 15% |
model_billing |
余额不足 | 5% |
unknown |
未分类 | 15% |
*我的体会:跑完 `failure_cockpit.py top5`,你的 Top-5 列表通常能覆盖 80% 的故障时间。先修高频 + 高 cons(连续失败次数),再修低频。*
学习笔记 4:每次只改一点点——Bounded Proposal
【原文洞见】 Harness 提议必须是有界的(bounded)——只针对"可被解决"的反复出错模式,通过窄而精准的修改完成。每次只改 1 个文件 / 1 个 cron,候选之间保持差异性。
【我的翻译】 这是 Lilian 这篇文章里最反直觉的一条经验。我以前看到 12 个 cron 连续报错,下意识反应是"写个脚本批量修"。Lilian 的研究告诉我:别这么做——一旦批量改坏,所有 cron 一起炸,你连"哪个改动触发了问题"都查不出来。
【OpenClaw 实战】 OpenClaw 的 bounded_propose.py 强制每次只改 1 个 cron,写一份 proposal JSON(bp-YYYYMMDD-NNN.json),字段含 id / type / target / diff / status / approved_by / validation / rollback_plan。改完用 cron_canary.py mark 标 24 小时灰度。
我的体会:把"批量修复"的诱惑挡在工具外面。机器强制你一次只改一处,比自律可靠得多。
学习笔记 5:Canary 灰度——24 小时再 promote
【原文洞见】 候选编辑必须通过回归测试——测试集 D_in(解决弱点)+ 留出集 D_out(不引入新问题)。只有两份数据都没回归,候选才会被接受。
【我的翻译】 "改完直接上线"是 2026 年 AI 工程化最大的隐患之一。原文的做法是:让改动先在受控环境里跑 24 小时,跑过了再 promote(成为新 baseline),跑挂了自动 rollback。
【OpenClaw 实战】 每个 cron 改动后用 cron_canary.py 标记为 canary:
marked_at: 2026-07-09T11:03:18
expires_at: 2026-07-10T11:03:18 # 24h 后自动 expire
threshold: 5 # 阈值从 3 放宽到 5(容忍 24h 抖动)
ready_to_promote: false # 24h 后才置 true
我的体会:AI 工程化的"凌晨 3 点恐慌",本质都是没有 24 小时灰度期。原文帮我把这件事想清楚了。
学习笔记 6:Meta-Harness——两层治理架构
【原文洞见】 优化对象是"决定并优化哪些信息该被存储、检索、呈现给模型"的代码。Meta- 意味着它是"优化 harness 的 harness"。关键设计:整个执行历史通过文件系统访问;提议出的 harness 是文件系统中的一个"字典";循环不断生成新 harness,仅保留合格者。
【我的翻译】 读到这里,我才意识到:之前我把"AI 代理改 prompt"和"管理员改 cron 配置"当成一回事,完全错了。原文把它们拆成两层——这种分层思路和我熟悉的"应用代码 vs 平台配置"非常类似。
【OpenClaw 实战】 把"代理行为规范"分成两层:
| 层级 | 改什么 | 谁改 | 风险等级 |
|---|---|---|---|
| Meta-Config Layer (MCE) | skill / cron / harness 配置 | meta-agent(需 canary + 人工) | 🔴 高 |
| Base-Context Layer (BCE) | context 注入 / prompt 调优 | 各 agent 自主 | 🟡 中 |
meta-agent 改 MCE 必须走 bounded_propose + cron_canary 流程;base agent 改 BCE 自主完成,但不得影响 meta-config。两层之间严格隔离。
我的体会:一旦你把"AI 改 AI"这件事分层,焦虑感会下降一个量级。改 BCE 出问题,顶多让一个代理的 prompt 跑偏;改 MCE 出问题,是整个团队的工具链乱套。
学习笔记 7:从教训沉淀到自动验证的闭环
【原文洞见】 上下文工程是一个持续演化的"作战手册(playbook)",由 Generator / Reflector / Curator 三组件维护。条目带标识符 + 描述,周期性精炼与去重。
【我的翻译】 这部分让我想起一句老话:"教训如果不写下来,第二次踩坑时一定还会踩。" 原文的解药不是"少犯错",而是"让每次犯错自动变成护具"。
【OpenClaw 实战】 OpenClaw 的闭环是:
错误发生 ↓
写入 .learnings/LEARNINGS.md (LRN-YYYYMMDD-NNN) ↓
稳定 1 周后晋升到 TOOLS.md / AGENTS.md / SKILL.md「已知陷阱」 ↓
下周 weekly_review.py 自动生成复盘报告 ↓
新代理 startup 时强制读 LEARNINGS.md + AGENTS.md 硬规则 ↓
下次同类错误 → 不再发生 ✅
我的体会:每踩一次坑,下一次的护具就厚一层。这种"自我加强的护具"是 harness engineering 最有魅力的设计。
我的整体读后感
读完整篇文章,我最大的收获不是某个具体的技术点,而是一种工程化心态的转变:
以前我以为——"让 AI 更聪明" = "换更大的模型"。
现在我以为——"让 AI 更聪明" = "让 AI 更可被运维"。
前者是模型团队的事,后者是每一个用 OpenClaw 的人都能做、而且应该做的事。原文用一句话点穿了这件事:"harness 改进能让模型被更好地'部署',但智能仍是核心。"——但我们大部分人,并不在改"核心"的位置上;我们能做的,是把"部署"做到极致。
原文链接:https://lilianweng.github.io/posts/2026-07-04-harness/
译文链接:>>>