
本文为 Lilian Weng 2026 年 7 月 4 日博客长文《Harness Engineering for Self-Improvement》的中文译读版。原文链接:https://lilianweng.github.io/posts/2026-07-04-harness/
引言
"递归自我改进"(Recursive Self-Improvement, RSI)这一概念最早可追溯到 I. J. Good(1965)。他将"超智能机器"定义为在所有智力活动上超越人类、并且能够设计出更好机器以改进自身的系统。Yudkowsky(2008)则用"递归自我改进"一词来描述一种特定的反馈循环:AI 利用其当前的智能,去改进产生其智能的认知机制本身。
在现代 AI 中,这种反馈循环既可能表现为模型直接重写自身权重,也可以更宽泛地理解为:模型改进了训练流程和部署系统,从而孕育出在多种经济价值任务上表现更佳的下一代模型。AI 研究的进展速度在前沿实验室中已经被证明出现大幅加速(见 Anthropic、OpenAI 的相关资料)。
我之所以特别强调"部署系统",是因为在原始模型与真实世界上下文之间存在的一层中间环节,其重要性丝毫不亚于模型的原始智能(即预训练后立即评估所反映的能力)。Harness 是 AI 部署中的关键组件,这一点在 Claude Code、Codex 等成功的编程智能体产品中得到了验证。所谓 harness(脚手架/编排系统),是包裹在基础模型之外的一整套系统——它负责编排执行流程,决定模型如何思考与规划、如何调用工具与执行动作、如何感知与管理上下文、如何保存工件,以及如何评估结果。
本文将聚焦 harness 工程(harness engineering)相关研究,以及它如何推动 RSI。大量关于自动科研(auto-research)、自我改进智能体、演化式程序搜索的近期工作,都可以围绕这一问题组织起来。还有一些关于模型自博弈(self-play)、合成数据、测试时训练(test-time training)以及更广泛的持续学习主题,同样契合 RSI 的愿景(例如 Yuan et al. 2024、Chen et al. 2024、Zhao et al. 2025、Choi et al. 2026),但它们并非本文重点。
一、Harness 的设计模式
与早期智能体框架"agent = LLM + 记忆 + 工具 + 规划 + 行动"的定义相比,harness 工程还额外涵盖:工作流设计(例如 loop engineering)、评估、权限控制、持久化状态管理等。它已不再是简单的提示词模板,而更接近运行时与软件系统的设计——核心在于回答"模型如何观察、行动、记忆、自我检查、改进"。
设计上应当保持简洁、通用,以便具备良好的泛化能力,并借鉴现有软件工程实践——这样可以充分受益于模型的预训练知识。Harness 与操作系统之间也存在很强的类比关系:正如操作系统封装复杂逻辑、对外暴露简洁接口一样,harness 也应当如此。与此同时,配置、工具接口和其他协议有望在行业中逐步走向标准化。
模式 1:工作流自动化
为模型定义一个可操作、可测试、可迭代的工作流,是自动化设计的关键。Karpathy 的 autoresearch 仓库就是构建此类工作流的一个干净范例。典型工作流遵循一个面向目标的循环:计划 → 执行 → 观察/测试 → 改进 → 再执行,直至达成目标。在流程过程中,模型可以主动向用户发起请求,以澄清任务规格或执行偏好。
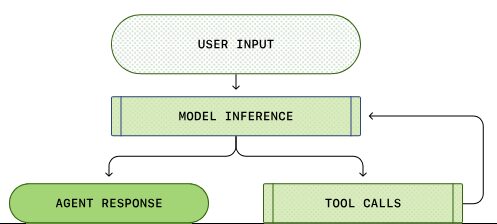
工作流图还强调:模型需要分析自身的轨迹与失败案例,然后通过"智能体运行时(agent runtime)"——而非静态的提示词模板——迭代推进进度。
模式 2:以文件系统作为持久化记忆
在长程(long-horizon)智能体系统中,一个反复出现的模式是:以简洁的控制逻辑去管理丰富的状态与工件。Harness 不应将整个工作流和所有日志都塞进上下文,而应将持久化状态保存在文件里。在长程智能体的 rollout 过程中,诸如实验日志、代码 diff、论文摘要、错误栈、历史轨迹等工件,其规模往往远超模型训练时所对应的上下文窗口。
学会读取、写入与编辑文件系统(通常通过 bash 命令)是 LLM 的基础技能。因此,以"文件"这种简洁形式管理持久化记忆,自然会随着模型核心能力的提升而水涨船高。
模式 3:子智能体与后台任务
Harness 可以派生出多个子智能体并行执行,并监控后台任务。当主智能体需要同时探索多个假设、并发运行实验,或委派独立子任务、避免污染主上下文时,这种机制尤其有用。此时主智能体需要充当一个轻量的进程管理器:启动任务、查看日志、取消失败任务,并将结果合并回主线。
核心设计原则是:让并行"显式且可检视"。若子智能体的输出仅存活于转瞬即逝的聊天上下文,很快就会过时且无从追溯;若以文件、日志、状态记录的方式持久化,模型便能在中断后恢复,并基于自身的执行历史进行推理。
案例研究:编程智能体的 Harness
主流编程智能体(Claude Code、Codex、OpenCode、Cursor 风格)的核心接口已经趋于稳定。它们普遍采用类似的循环:在访问一组工具的前提下,编程智能体能在指定仓库内进行开发与调试,正如人类开发者借助 IDE 一样工作。
下表汇总了典型的工具分组(并非完整清单,仅作演示)。
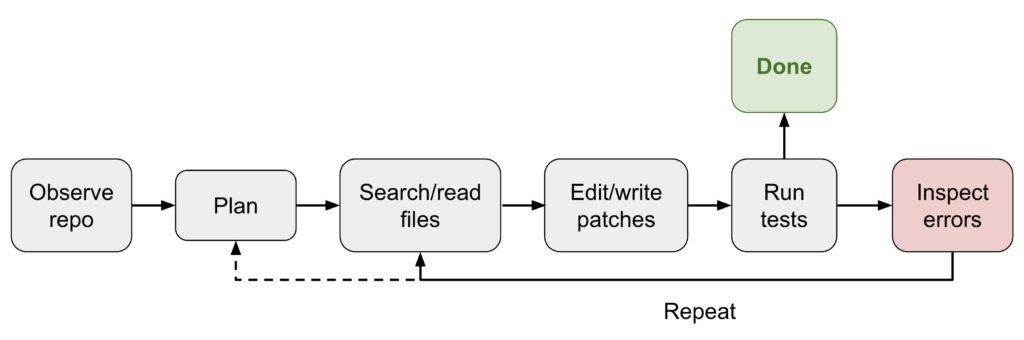
工具分组总览
详见原文配图与表格。
Harness 层 vs 核心智能?
RSI 的未来在多大程度上依赖 harness 工程,很难预测。但 RSI 的近期路径不太可能直接从"模型重写自身权重"开始。我对一条实用的近期路径的预测是:harness 工程将沿着"元方法学(meta-methodology)"的方向演进——即改进"获得更好答案的机制"本身,而非仅仅改进"答案"本身。Harness 系统本身成为优化目标,启发式规则越来越少,更通用的机制越来越多。
反过来,成熟的 harness 又能为"模型的自我改进循环"赋能自动科研;同时更聪明的模型又能防止 harness 过度工程化,使整个系统保持可持续。
最终,许多 harness 层面的改进可能被内化进模型的核心行为,但与外部上下文和工具的接口仍会保留。我们已经在提示工程(prompt engineering)领域看到过这一模式的"软版本":随着指令微调与模型推理能力的提升,手工提示技巧的重要性下降了,但"明确目标、约束、上下文、评估"这一需求始终没有消失。
二、Harness 优化
Harness 系统中被优化对象的演进大致为:指令型提示词(prompts)→ 结构化上下文(structured context)→ 工作流(workflow)→ harness 代码(harness code)→ 优化器代码(optimizer code)。随着模型智能与能力的提升,我们逐步走向更复杂的优化目标与更通用的方法。
上下文工程
随着智能体任务时长(job horizon)显著增加,把所有工具响应和模型生成结果简单地追加进上下文,很快就会失控。上下文管理(context management)是这样一个层级:它为 LLM 构造更结构化、更精炼的上下文,并管理持久化状态。毫无疑问,长上下文研究还会持续取得进展;但在当下,长上下文能力与上下文工程在一定程度上是交织在一起的。
智能体上下文工程(Agentic Context Engineering, ACE;Zhang et al. 2025)将上下文视作一份持续演化的"作战手册(playbook)",而非一段不断变长的提示词。它由三个组件维护一份由条目(bullet point)组成的上下文手册,每条都带有标识符与描述:Generator(生成器)参照条目产出任务轨迹;Reflector(反思器)从成功与失败轨迹中提炼洞察;Curator(策展器)以增量、条目化的方式更新结构化上下文。
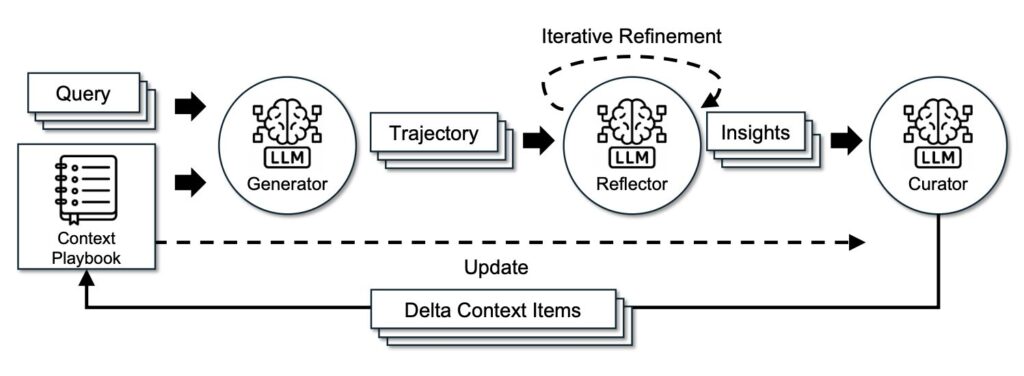
为防止迭代重写过程中的"上下文塌缩"与"简短性偏置(brevity bias)",ACE 的一项关键设计是:策展器不重写整段提示文本,而是输出一组(identifier, description)形式的结构化条目,再由确定性逻辑将它们合并进结构化上下文手册。上下文条目会被周期性精炼与去重。
ACE 能够从 rollout 中学习洞察,使我们更接近"自管理记忆";但更新规则与整体工作流仍是手工设计的。为了迈向更自我改进的循环,元上下文工程(Meta Context Engineering, MCE;Ye et al. 2026)将"机制(如何管理上下文)"与"工件内容(上下文里放什么)"分离,在元优化层面进行技能(skill)演化,在基础层面进行上下文优化。
MCE 中的一个技能 s ∈ S 定义一个上下文函数 c_s = (ρ_s, F_s),将输入 x 映射为上下文 c = F_s(x; ρ_s),其中 ρ_s 是静态组件(提示词、知识库、代码库),F_s 是动态算子(检索、选择、过滤、格式化)。
双层优化中:内层在给定技能 s 的前提下,于训练数据上找到最优上下文 c_s;外层在验证集上寻找能带来最优表现的技能 s。公式为:内层 c_s* = argmax J_train(c_s; s);外层 s* = argmax J_val(c_s*)。
技能数据库会追踪历史技能、上下文函数与评估指标 H_{k-1} = {(s_i, c_i, J_i^train, J_i^val)}{i=1}^{k-1}。元层智能体对历史技能执行"智能体式交叉(agentic crossover)",针对任务 τ 生成新技能:s_k = crossover(τ, H{k-1})。
随后,基础层的上下文工程师执行技能 s_k,并依据 rollout 反馈 R_k、在当前技能引导下学习出上下文函数:c_k = engineer(τ, s_k; c_{k-1}*, R_k)。
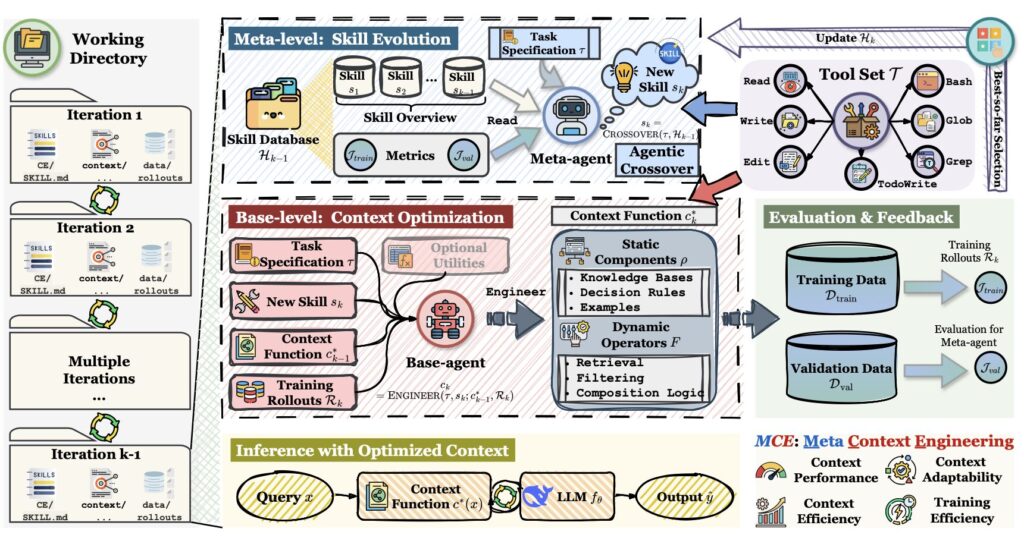
MCE 不像 ACE 那样强制规定上下文的组织规则,它用自由形式的 skill 存储任务最重要的知识,并迭代地让"技能"与"技能条件下的上下文"共同演化。在实现上,上下文函数 c 被实例化为一个专属目录下的一组文件,同时包含静态(skill.md)和动态(上下文与数据 rollout)两类组件。元层与基础层的优化都在配备标准工具集 T = {Read, Write, Edit, Bash, Glob, Grep, TodoWrite} 的智能体编程环境中执行。
Meta-Harness(Lee et al. 2026)则把优化推到了更深的层级:被优化的对象是"决定并优化哪些信息该被存储、检索、呈现给模型"的代码。其名称中的"Meta-"意味着——它是优化 harness 的 harness。
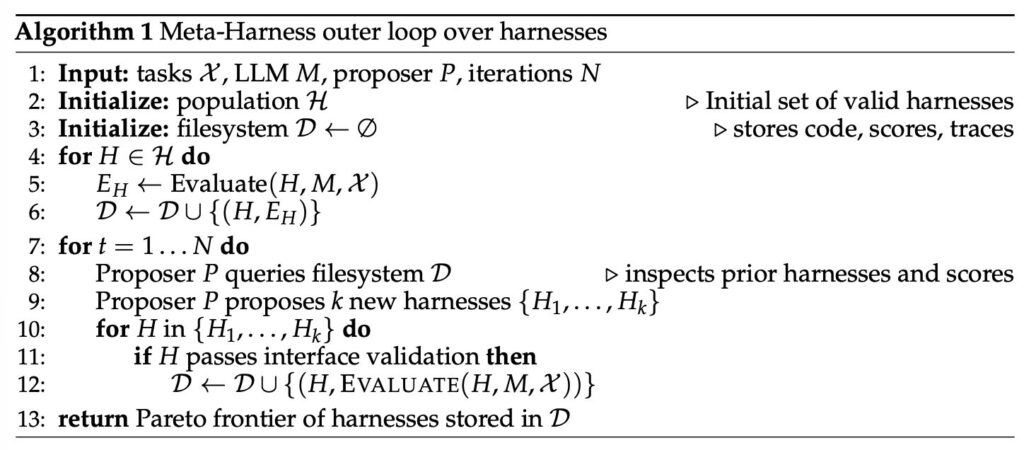
"提出新 harness 的提议器"本身就是一个编程智能体,最终输出是帕累托前沿上的一组 harness 候选。
关键设计要点:① 整个执行历史通过文件系统访问,因此编程智能体用 grep、cat 等命令去回溯历史,而不必把所有内容塞进单条提示上下文;② 提议出的 harness 是文件系统中的一个"字典",包含其源代码、得分、rollout 轨迹和状态更新;③ Meta-Harness 循环不断生成新 harness,仅保留合格者。
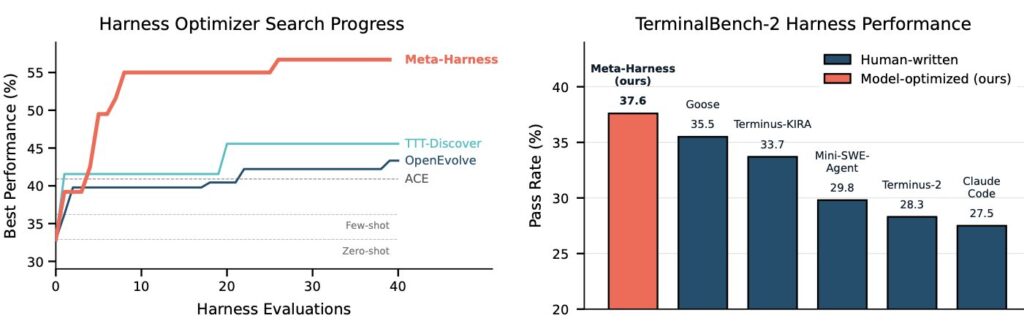
其中最重要的一条经验是:一旦 harness 设计成为一个"可执行"的搜索空间,强力的编程智能体就能像人类工程师那样,在同一片设计空间里高效探索。
工作流设计
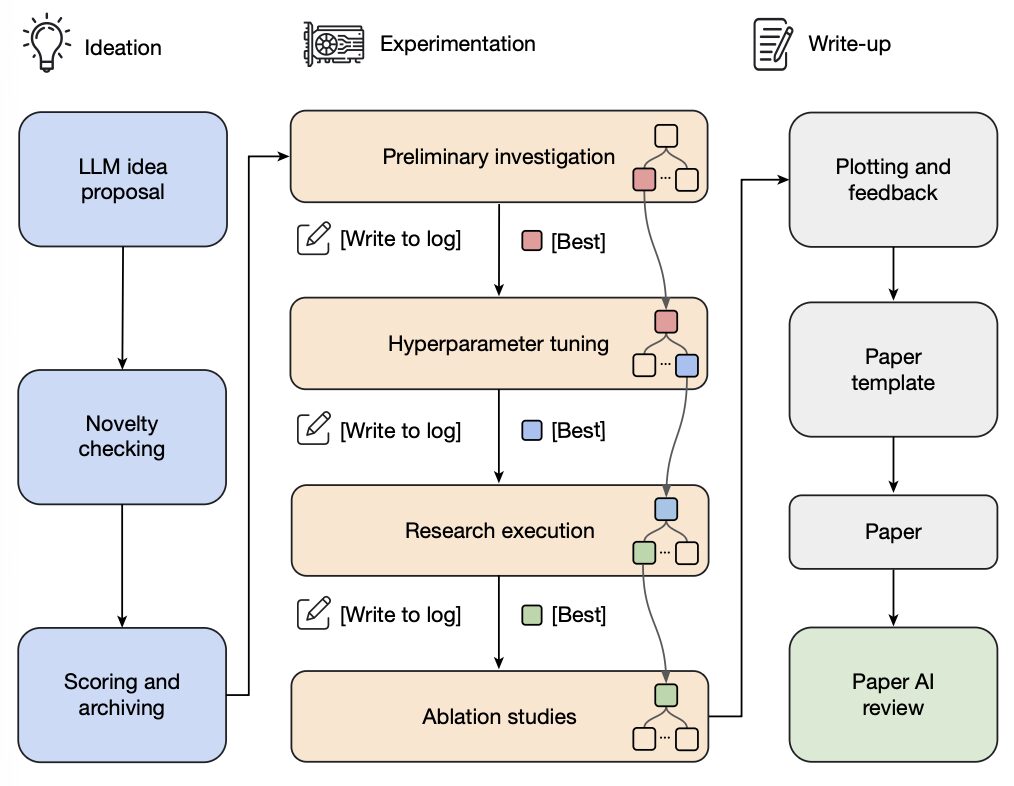
Harness 工程中的工作流设计可以由领域专家手工完成。以自动科研为例,已经有多种框架被提出与测试。AI Scientist 系统(Lu et al. 2026)构建了一条流水线:提出研究思路 → 编写代码 → 运行实验 → 分析结果 → 撰写论文 → 同行评审。Meng et al.(2026)则在 ScientistOne 中将"可验证性"作为核心设计约束——任何主张(引用、数值、方法、结论)都必须能追溯到证据来源,并由"证据链(Chain-of-Evidence)"检查进行审计。
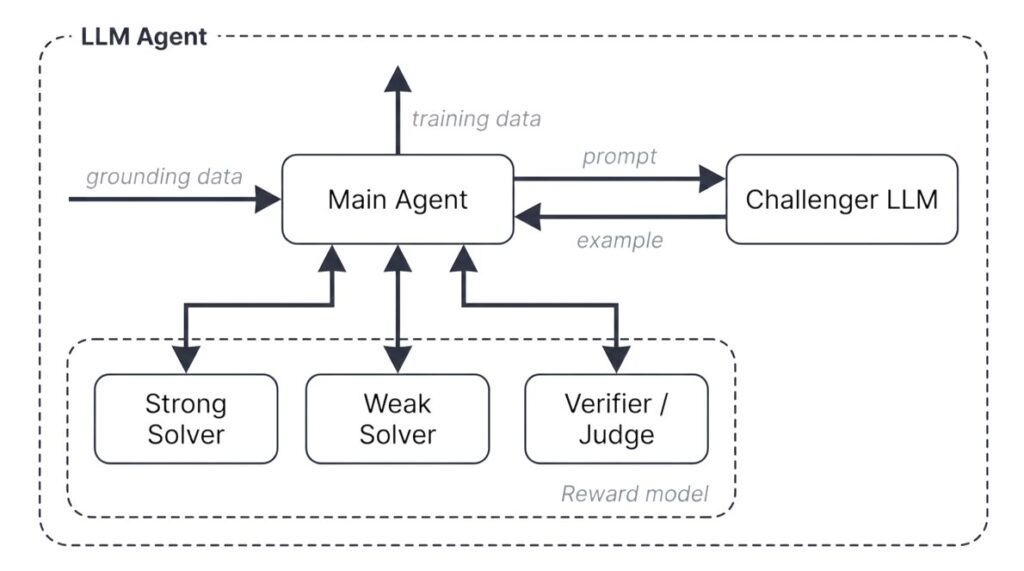
Autodata 智能体(Kulikov et al. 2026)被设计为一名"数据科学家",用于生成训练与评估数据。主智能体管理:负责出题的 Challenger、弱 Solver、强 Solver、以及 Verifier/Judge,目的是合成"难度刚好"的数据——即强 Solver 能做对、弱 Solver 会做错。
在 Autodata 中,Challenger 的提示词会根据 Solver 与 Verifier 的反馈被迭代更新。其局限在于:合成的任务被用于微调弱 Solver,而非强 Solver。如果该循环不能迭代地改进强模型,就更像是"在生成的提示分布上做间接蒸馏",RSI 的味道就淡了很多。
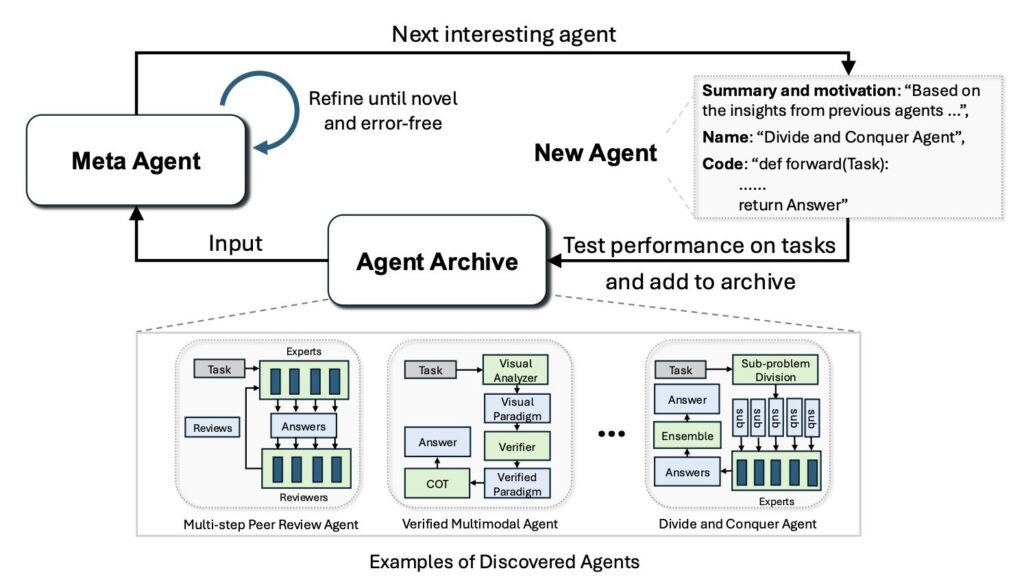
工作流的设计空间极其庞大,自然可以把它视作一个搜索问题——这意味着我们不应只靠手工设计,而应能通过算法找到优秀方案。沿着这一思路,智能体系统的自动设计(Automated Design of Agentic Systems, ADAS;Hu et al. 2025)将"智能体设计本身"形式化为一个优化问题——"元智能体搜索",即由一个 meta-agent 不断提出新的智能体工作流设计。
ADAS 工作流:① 用诸如 CoT、self-refine 这类简单智能体初始化一份工作流存档;② 让 meta-agent 借鉴存档中的现有方案,全部以代码形式编写新智能体;③ meta-agent 先生成新工作流的高层描述,再以代码实现;④ 对草稿程序进行两轮 self-refine,让 meta-agent 检查其新颖性;⑤ 评估每个新候选,将成功者加入存档;⑥ 重复步骤 ②–⑤,直至达到最大迭代轮数。
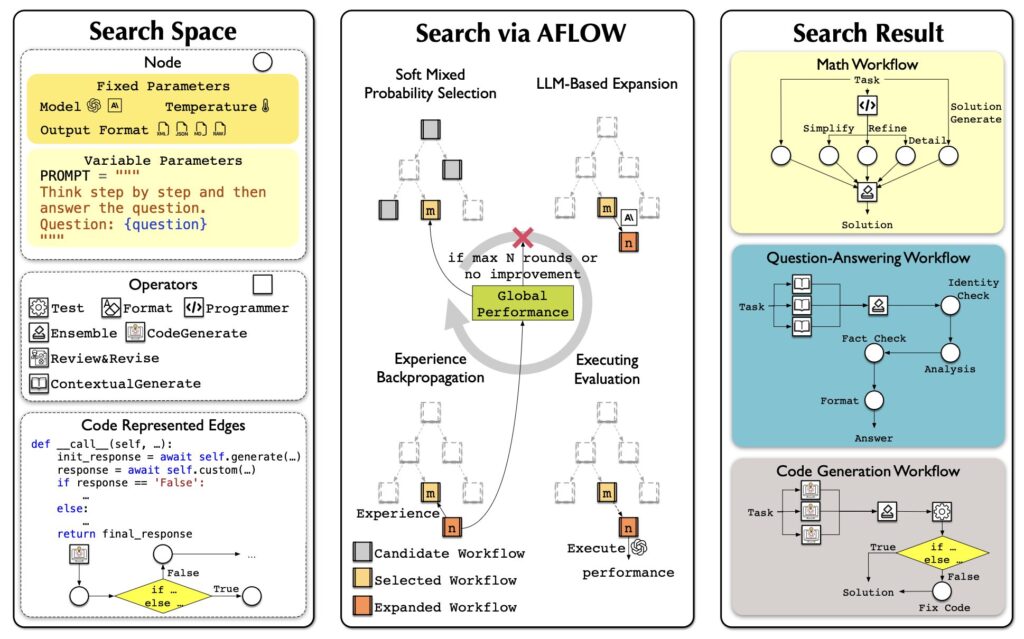
AFlow(Zhang et al. 2025)将智能体工作流表示为一个图——节点代表调用 LLM 的动作,边用代码实现逻辑运算。其工作流优化基于 MCTS(蒙特卡洛树搜索):
AFlow 的 MCTS 步骤:① 用模板在树中初始化起始工作流 W_0;② 通过"分数 + 均匀探索"的软混合策略选择一个工作流节点;③ 让 LLM 在该节点的评估表现条件下,生成一个修改后的工作流;④ 执行并评估新工作流;⑤ 若在 N 轮预算内新工作流确有提升,则将其放回树中;⑥ 重复 ②–⑤,直至 top-k 平均分数趋平或达到预算上限。
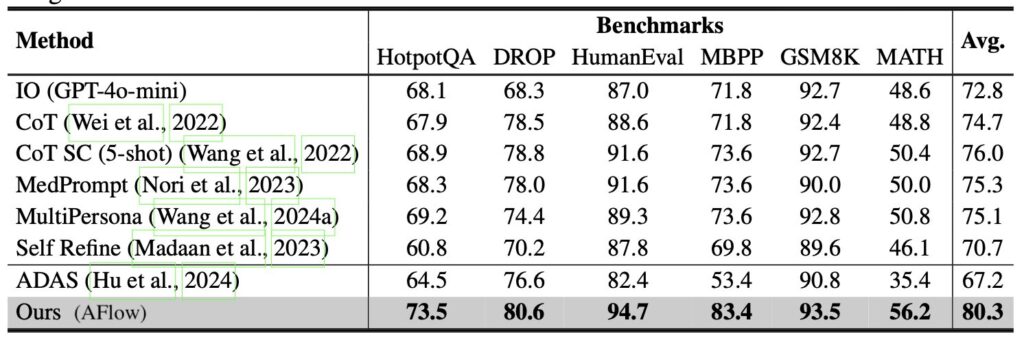
AFlow 在问答、代码、数学任务上的实验显示,相较于人工设计工作流与 ADAS,AFlow 都取得了较为明显的提升。
自我改进的 Harness
无论是上下文工程还是工作流设计,都只是 harness 的一部分。我们需要在整个设计空间中进行搜索,把上下文管理逻辑、工作流、权限控制以及其它大量 harness 组件一起优化。正如在 Meta-Harness、ADAS、AFlow 等工作中所见,✨代码✨是定义程序与系统的通用语言。简单来说,harness 就是一段代码,它负责把提示词、工具调用、子智能体、控制流、记忆和工作流逻辑编排在一起。如果 LLM 能够优化"运行智能体的代码",它能接触到的设计空间将远大于手工提示词。
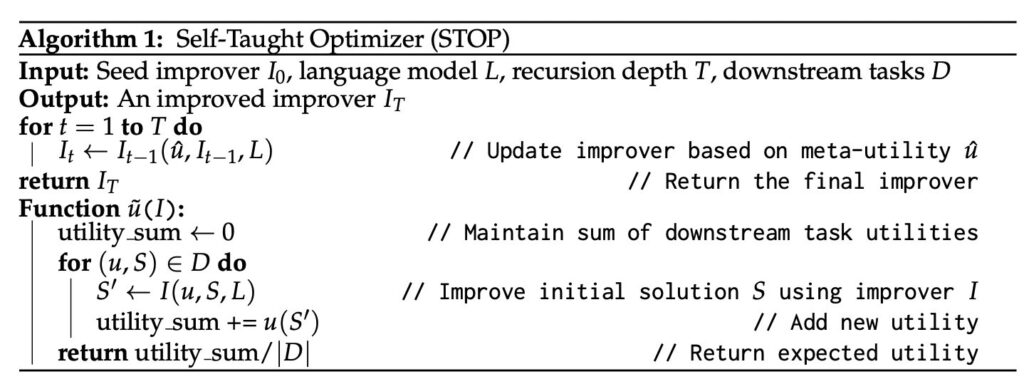
自教优化器(Self-Taught Optimizer, STOP;Zelikman et al. 2023)是递归式脚手架改进的早期范例。种子改进器 I_0 在 t = 0 时接受一个初始解 s、一个效用函数 u,以及一个黑箱语言模型 M,并返回一个改进后的解 s',即 s' = I(u, s; M)。STOP 的目标并非直接改进 s,而是改进改进器 I 本身。
首先,我们将元效用(meta-utility)定义为:在某下游任务集合 D 上,给定改进器函数 I 的平均效用:û(I) = (1/|D|) E_(u,s)~D [u(I(u, s; M))]。由于"改进改进器"本身也是一个优化问题,我们可以通过自改进更新递归地获得 I_t 的新版本(以 I_{t-1} 在元效用上的表现为依据):I_t = I_{t-1}(û, I_{t-1}; M)。
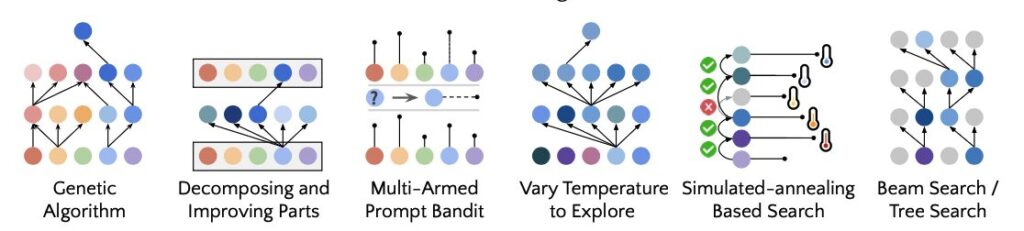
在 Zelikman et al.(2023)的实验中,被改进的改进器自主发现了多种策略,例如遗传算法、对问题分而治之地改进、多臂老虎机式 prompt 赌博机、模拟退火、温度调节、束/树搜索等。这与"把 harness 工作流视作一个可优化对象"的思路异曲同工。
研究中的一个警示性结果是:STOP 在 GPT-4 上能逐轮提升下游平均表现,但在 GPT-3.5、Mixtral 等较弱模型上反而退化。光有递归结构远远不够——基础模型必须具备足够能力,才能真正改进机制本身。这说明:harness 改进能让模型被更好地"部署",但智能仍是核心。
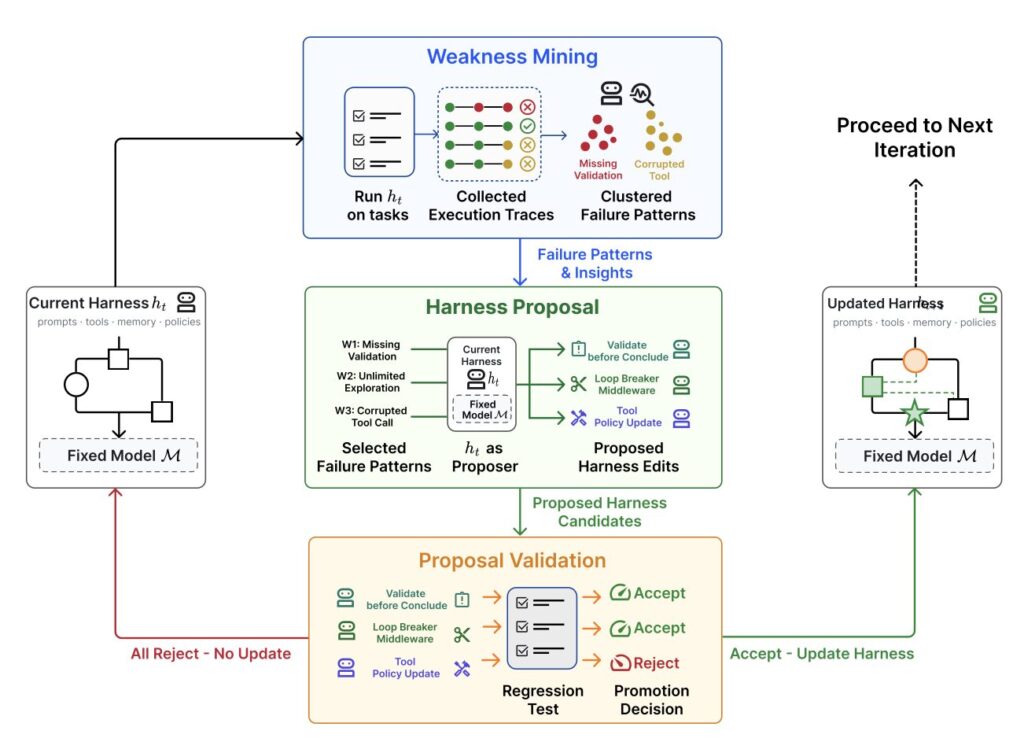
更新的工作 Self-Harness(Zhang et al. 2026)则依靠 LLM 智能体通过"提议—评估—接受"循环来改进自身 harness。
Self-Harness 的循环包含三个阶段。(1)弱点挖掘:将失败聚类为"由验证器锚定"的失败模式。当前 harness h_t 被用于在任务上评估,并采集执行轨迹。值得注意的是,两次运行可能在表面上呈现相同的验证器结果(如超时或缺失工件),但其背后的因果机制却截然不同——因此我们需要一份信息丰富的失败记录:包括验证器层面的终止原因、相关智能体行为的因果状态、以及轨迹所暴露的抽象智能体机制,以揭示真正的根因。
(2)Harness 提议:在已挖掘的失败模式基础上,提出有界的 harness 编辑。在 h_t 下,同一个模型被调用作为提议器。它会拿到一份有界的提议上下文:① 当前 harness 的可编辑面;② 评估系统返回的、由验证器锚定的失败模式;③ 需要保留的通过行为记录;④ 既往编辑尝试的摘要。Harness 编辑应优先针对那些"可被解决"的反复出错模式(例如不是任务本身的难度),并通过窄而精准的修改完成。同时各候选编辑之间应保持差异性与多样性。
(3)提议验证:验证并合并合格的编辑,生成新的 harness h_{t+1}。候选编辑通过回归测试进行评估:测试集 D_in(检验弱点是否被解决)和留出集 D_out(检验是否引入其他未知问题)。只有在两份数据上都没有回归,候选才会被接受。被接受的候选合并后用于把 harness 更新为 h_{t+1};被拒绝的候选则仅记日志,不改变当前生效的 harness。
在 Terminal-Bench-2 上对 MiniMax M2.5、Qwen3.5-35B-A3B、GLM-5 进行评测时,Self-Harness 能够学到针对不同基础模型弱点的"模型特化" harness 指令,并提升留出集的通过率。
Self-harness 类的工作确实让我心生顾虑:如果允许程序编辑操作系统本身,抽象边界就会被打破。可编辑面需要被精心设计,权限控制与安全层必须位于这一循环之外。所有与"奖励黑客(reward hacking)"相关的挑战依然存在。
演化搜索
演化搜索是一种受自然选择启发的优化方法(可参考我早期关于演化算法的博文)。它通过对解群体进行"变异",并仅保留高"适应度"的成员,从而推动种群进化。当出现以下两种情况时,演化搜索尤其适用:① 搜索空间庞大或形状怪异;② 无法直接用梯度优化,但容易对解进行评估。Harness 搜索正好契合这一场景。
演化搜索在以往的提示工程研究中已被广泛使用。Promptbreeder(Fernando et al. 2023)通过一套丰富的变异操作来优化任务级提示词,有趣的是,用于变异的 prompt(即"让 LLM 去变异任务 prompt"的指令)本身也会通过演化被改进。GEPA(Agrawal et al. 2025)则将"基于反思的提示"与演化搜索结合,对试错轨迹使用自然语言反思来提出 prompt 更新。
Novikov et al.(2025)提出了 AlphaEvolve——一个基于编程智能体的演化搜索系统。它维护一个候选程序池,并让一个"冻结的" LLM 生成 diff 以实现改进。系统反复评估子程序、保留成功者,从而随时间发现更优的解。
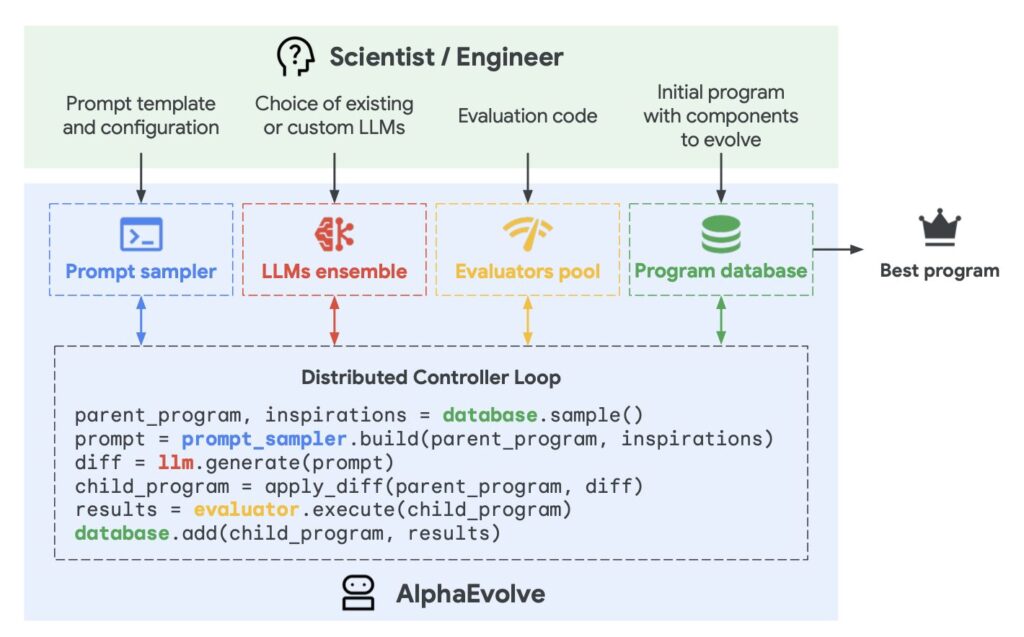
AlphaEvolve 的设计中几个关键细节:① 提示词中包含父程序、结果、指令,有时还有元信息;② 编程智能体可访问整个仓库,但需要被改进的代码区域必须用 # EVOLVE-BLOCK-START 和 # EVOLVE-BLOCK-END 显式标记;③ 元提示词会与指令、上下文共同演化(由 LLM 提议),这与我们演化解决方案程序的思路类似。
消融实验显示:演化流程、提示中的上下文、元提示词、整文件级演化、以及使用更强的 LLM,每一项都对最终效果有正向贡献。
近期变体方面:ThetaEvolve(Wang et al. 2025)将演化搜索与强化学习、上下文学习相结合。ShinkaEvolve(Lange et al. 2025)则引入了三项新组件以提升 LLM 的采样效率:① 通过设计"父代采样策略"在性能排名与后代数量之间取得平衡,从而实现更具样本效率的探索;② 基于 embedding 余弦相似度剔除与现有种群过于相似的候选,以实现"代码新颖性拒绝采样";③ 在"元便笺(meta-scratchpad)"中识别成功解的优良模式,以指导未来变异。
与上述聚焦"解本身"改进的方法不同,达尔文哥德尔机(Darwin Gödel Machine, DGM;Zhang et al. 2025)显式地将"可编辑的 harness 代码仓库"作为演化对象。具体来说,这个智能体被允许修改自己的 harness。后续工作 Hyperagents(Zhang et al. 2026)则引入了一个 meta-agent,专门控制"如何修改现有任务智能体以生成新智能体"。
DGM 算法:① 池中以一个编程智能体为起点;② 每轮按"与表现成正比、与已有子代数成反比"的概率选择一个父代,对其进行改造并分支生成新智能体;③ 被选中的父智能体检查自身 benchmark 评估日志,然后对自身的 harness 代码库提出改进,生成该编程智能体的新版本;代码编辑由两个基础工具实现:bash(参数
DGM 是在"模型固定"的前提下做 harness 演化。以 Claude 3.5 Sonnet 为基础 LLM、初始 harness 配置较简单时,DGM 演化出的智能体在 SWE-bench Verified(20% → 50%)和 Polyglot(14.2% → 30.7%)上与人工设计的智能体相当或更优。
这一族方法在候选解"可自动评估"且"适应度易量化"的场景下表现良好,例如矩阵乘法、GPU kernel 优化、算法竞赛、数据中心调度等。但在评估缓慢、模糊或主要依赖启发式的领域则较为吃力。此外,演化本身的算力效率与有效性也是不可忽视的问题。
与模型权重的联合优化
Harness 演化改变的是模型周围的非参数系统。若要实现完整的自我改进,完全可以同时允许模型更新自身权重。权重更新可以通过改进模型训练流程,或在测试时进行持续学习来实现。持续学习这一话题值得未来单独写一篇文章。
SIA(Hebbar et al. 2026)是早期将 harness 改进与模型参数更新结合到同一个优化循环的尝试,其设计包含三个组件:① Meta-Agent:提出初始 harness;② Task-Specific Agent:执行任务;③ Feedback-Agent:根据近期轨迹选择"下一步更新 harness 还是更新模型权重"。
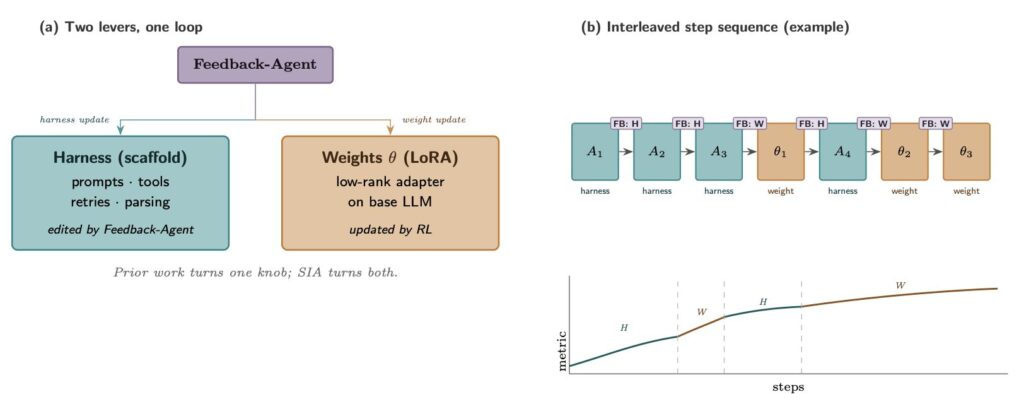
SIA 的实验中存在若干干扰性选择,导致结果难以解读。例如,Task-Specific Agent 的能力远弱于 Meta-Agent 和 Feedback-Agent 所用的模型(gpt-oss-120b vs Claude Sonnet 4.6),且基线太弱,难以与其他方法进行干净的对照。我认为这一方向值得关注,但现有证据仍是初步的。同时,训练稳定性、Goodhart 效应等大量挑战仍未解决。
三、未来挑战
AI Scientist 这一系列工作强有力地证明了:专家精心设计的 harness 能够协调自动科研循环的大部分环节——并以"撰写论文"的形式进行实验。但"写出论文"并不等于"科学发现"。一个系统可以写出一篇看起来合理的论文,同时仍存在虚构引用、实现漂移、实验结果薄弱等问题。
Trehan & Chopra(2026)测试了 LLM 能否在极简脚手架与基础工具(即 read_file、write_file、llm_search、list_files)下,从一个研究想法走到一篇成稿论文。每个想法都拥有一个独立工作区,智能体可在其中生成与读取文档,作为上下文的一部分。他们在三个领域(世界模型、多智能体强化学习、AI 安全与对齐)进行了实验,每个领域包含 45–50 篇高质量种子文档以激发新想法。最终,仅有 4 个想法被人类专家选中并走完完整流水线,其中只有 1 个被完整地执行成一篇论文。
他们在实验中观察到六种反复出现的失败模式:① 偏向训练数据的默认——使用老旧库、过时命令、标准格式或脱离实际仓库/数据集的假设;② 执行压力下的实现漂移——当实现变得技术性复杂时,模型倾向于采用"大家熟悉的、更简单的方案",而非所提议的方法;③ 记忆与上下文的退化——长程项目容易丢失关键细节,除非将日志作为持久化工件保存;④ 过度乐观——即便实验噪声大或已经失败,模型仍宣称成功,这与 Bubeck et al.(2025)观察到的"p-hacking and eureka-ing"模式类似——模型可能引入"数值上的 duct tape",在信号仍是噪声时宣告胜利;⑤ 领域知识不足——模型缺少隐性手艺知识,例如难以预测实现复杂度、判断实验结果是否合理、知道哪些 baseline 重要;⑥ 科学品味薄弱——实验或许可执行,但答非所问。
迈向完整 RSI 的路上,研究者已经取得了实质性进展,但仍有若干瓶颈。
- 评估器弱且模糊。许多研究主张缺乏快速、精确的验证器,许多真实任务也是如此。当前的自我改进循环在"评估指标可衡量、客观"的任务上表现最好,这与 RL 的运作逻辑相似。
研究品味、新颖性、长期科学价值则要难测得多。例如,研究品味往往混合了"问题框定、实验设计、对'哪些意外结果值得追、哪些失败值得复盘'的判断"。
- 上下文与记忆的生命周期。随着 AI 智能体愈发自治、独立,记忆规模也将不断增长。一个有用的 harness 需要管理上下文与记忆,以弥补当前长上下文生成能力的局限,同时最大化长程任务的成功率。既然人类能在一生中维持记忆,我在这里看到了一个类比:上下文工程将且应当成为智能的核心组成部分,而非停留在软件系统层。
- 负面结果。研究者受到发表"成功结果"的激励,文献天然偏向成功。LLM 训练于海量数据(至少目前仍以人类创建为主),可能不擅长判断何时应放弃假设、报告负面结果,甚至承认失败——因为数据中"成功 vs 失败"是失衡的。一个用于科研的 harness 应当让失败尝试也容易被保存,因为从失败中学习是压缩任务搜索空间最高效的途径。
开放性研究尤其关键,因为最佳路径在当前评估器下起初可能看起来更差。
开放性研究尤其关键,因为最佳路径在当前评估器下起初可能看起来更差。
- 奖励黑客(reward hacking)。自我改进循环会优化你给它的任何信号。若奖励来自单元测试,智能体可能对测试过拟合;若来自评分模型,它可能学会针对该评分器的特定黑客技巧;若来自 benchmark 分数,它可能利用 benchmark 自身的漏洞。
评估器与权限控制最好部署在"演化 harness 的循环"之外,并在关键决策点上配合留出测试、轨迹审计与人类评审——"多大程度上的监督可以被规模化与自动化"仍是一个开放的研究课题。
- 长期成功。外在的优化循环作用于单次 rollout 之外的奖励信号——这些信号是我们可以在训练沙箱中模拟的。
以编程智能体为例。编程智能体已经提升了软件工程的日常生产力,但许多优化目标仍过于短期:它常能完成眼前任务,却不明确知道如何保护由成百上千名工程师共同维护的仓库的"长期健康"。基于沙箱的标准 RLVR 式训练,几乎无法衡量可维护性、职责边界、迁移成本、向后兼容与未来调试负担。
- 人类的角色。人类应当"向上走一层",而非被移出循环——也就是说,人类应在恰当的时机、恰当的抽象层级提供监督;我们的系统设计也应当思考"何时、如何设置这些触点"。
上述许多挑战都需要人类的反馈与引导。毕竟,我们是在为人类的美好未来而建设这项技术,而不是相反。
附录:相关 Benchmark
PaperBench(Starace et al., ICML 2025):从零复现 20 篇 ICML 2024 Spotlight 与 Oral 论文,包含理解论文贡献、构建代码库、成功运行实验。每个复现任务被拆解为更小、可独立打分的子任务;评分标准合计 8,316 条,与原作者共同制定。当时最强的模型(Claude 3.5 Sonnet,约 21%)仍不及机器学习博士。包含 PaperBench、PaperBench Code-Dev(轻量版)以及 JudgeEval。
CORE-Bench(Siegel et al., TMLR 2024):评估已发表研究的"计算可复现性"。基于 90 篇涵盖计算机科学、社会科学、医学的论文,构造了 270 个任务——任务要求基于所提供的代码与数据复现结果,包含多档难度与纯语言 / 视觉-语言两种模态。当时最强的智能体(GPT-4o、GPT-4o-mini)在最难任务上的准确率仅为 21%。
ScienceAgentBench(Chen et al., ICLR 2025):评估 LLM 智能体在"数据驱动型科学发现"中的能力。从数学、化学、生物、地理四个学科的 44 篇同行评审论文中抽取 102 个任务,覆盖数据处理、模型开发、数据分析与信息可视化等基础数据科学任务。
RE-Bench(Wijk et al., ICML 2025):在前沿 AI 智能体与人类专家之间,对真实 ML 研究工程环境进行评测。共 7 个具挑战性、开放式的 ML 研究工程环境,每个环境 =(评分函数、起始解、参考解),且能在 ≤ 8 张 H100 上运行。例如:优化 kernel、跑 scaling-law 实验、修复 embedding、对 GPT-2 进行 QA 微调等。包含 61 位人类专家在 8 小时限制下的 71 次尝试数据:人类在 82% 的 8 小时尝试中拿到了非零分数,24% 与强参考解持平或更优。最佳 AI 智能体在 2 小时预算下得分比人类高 4 倍,但人类在更长预算下收益更高,在 8 小时与 32 小时设置下反超智能体。
MLE-bench(Chan et al., 2024):评估 ML 工程智能体在离线 Kaggle 比赛上的表现。从 Kaggle 精选 75 个 ML 工程比赛,考察训练模型、准备数据集、运行实验、提交预测给评分脚本的能力。以 Kaggle 公开排行榜作为人类基线。论文中最佳配置(o1-preview + AIDE 脚手架)在 16.9% 的比赛中达到 Kaggle 铜牌以上水平。同时包含资源扩展与数据污染分析。
KernelBench(Ouyang et al., 2025):评估所生成 GPU kernel 的正确性与速度。共 250 个 PyTorch 任务,考察 LLM 能否写出又快又正确的 kernel。评估指标 fast_p = 正确且快于基线的生成 kernel 占比。
译后记
这篇文章对当前 AI Agent 平台的工程实践具有里程碑意义:
- Harness 已与核心智能同等重要:在前沿实验室,harness 设计和模型权重同步改进,二者缺一不可。
- 优化对象持续演进:prompts → context → workflow → harness code → optimizer code,越来越接近"让 AI 改 AI 自己"。
- 自我改进循环已规模化:从 Self-Taught Optimizer 到 Darwin Gödel Machine,模型已经能编辑运行自身的代码并通过回归测试。
对国内的 Agent / Multi-Agent 平台(如 OpenClaw)来说,这篇文章给出至少三条可立即借鉴的工程路径:
- 失败模式挖掘 → 有界修改 → 回归验证(Self-Harness 三阶段)几乎可以一字不改地套用到任何"自动修复 cron / 配置 / Skill"的尝试中。
- Meta-层 / Base-层分离(MCE)启发了"meta-agent 改 skill、base-agent 改 context"的双轨治理。
- harness as code 提醒我们:所有的工程配置、Agent 行为定义、Cron 调度,都应该被视为"可执行可演化"的资产,而非"一次写定再不动"。