
百度开源 Unlimited-OCR:用「一次提示」解析 32K tokens 的超长文档,突破传统 OCR 的多阶段流水线。开源 15 天破万星,本文带你拆解它的核心能力、部署方法与适用边界。
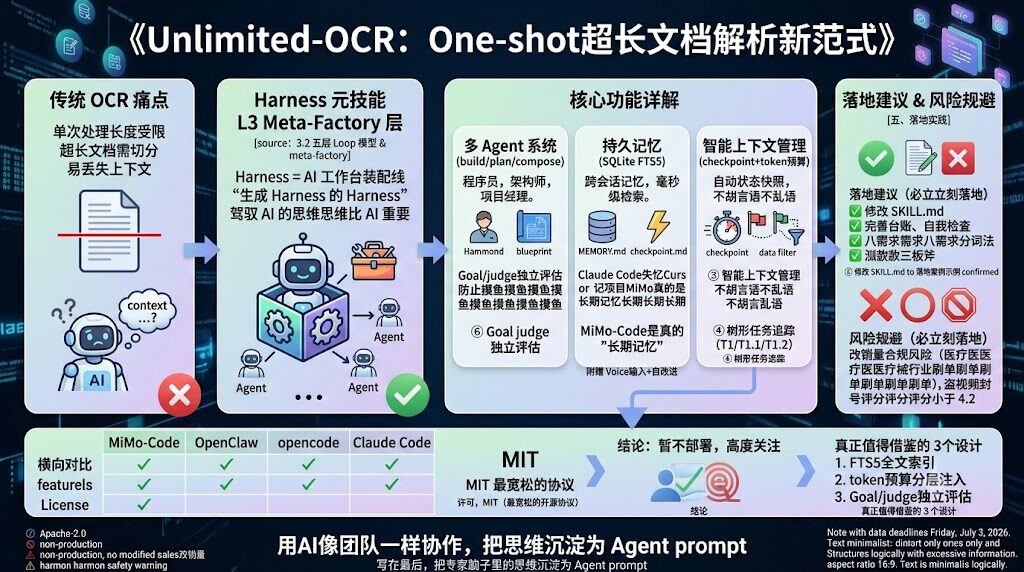
2026 年 6 月 18 日,百度在 GitHub 上线了一个新项目 baidu/Unlimited-OCR,自我定位是「下一代文档解析基础设施」。截至 2026-07-03,它已经拿下 13,065 颗星标,从发布到破万只用了不到半个月——这种速度在 OCR 工具里相当罕见。它到底解决了什么问题?值不值得你立刻上手试?下面我们拆开看。
一、这个项目到底是什么?
先说背景:传统的 OCR(Optical Character Recognition,光学字符识别)工具,往往是「流水线式」工作的——先把整张图切成小区域,识别文字;再单独识别表格;再单独识别公式;最后把结果拼起来。这种方式在面对几十页、上百页的长文档时,要么速度慢,要么识别错误率高。
Unlimited-OCR 走了一条不一样的路:统一 One-shot 范式。简单说就是「一次学习、终身使用」——你给它一张图、一句话提示(比如「<image>document parsing.」),它就能一次性把整张图里的所有内容(文字、表格、公式、票据、版面关系)都解析出来,不用拆步骤。
这种范式的关键突破在于:上下文窗口达到了 32,768 tokens,足以装下几十页文档的所有视觉信息。这意味着模型可以「看全」整份文档再下结论,避免了传统流水线在切分边界处丢失上下文的问题。
二、核心功能拆解
| 能力 | 它能做什么 | 对运营/电商的实际价值 |
|---|---|---|
| One-shot Long-horizon Parsing | 单次提示解析超长文档(最多 32,768 tokens),不需要多阶段 pipeline | 一份几十页的产品说明书,一次喂进去就能拿到结构化结果,省去分段拼接 |
| 多格式支持 | 单图像、多图像批量、PDF(含原生文字 PDF 和扫描件) | 既能处理手机拍的快递单照片,也能批量处理供应商发来的注册证扫描件 |
| 多推理后端 | HuggingFace Transformers、vLLM(支持 speculative decoding 加速)、SGLang | 小流量用 Transformers 跑测试,大流量用 vLLM 上生产,灵活切换 |
| 高精度布局理解 | 文档、表格、公式、票据等复杂布局的端到端解析 | 采购合同、检测报告、增值税发票这些版式复杂的文件,能直接读出表格结构和字段 |
| 开放 API | OpenAI 兼容接口,便于集成到现有 Agent 工作流 | 原本就在用 GPT 接口的 AI 工具,几乎零成本把识别模块换过来 |
| 中文友好 | 百度出品对中文文档有针对性优化 | 国内电商场景常见的简体字、繁体字混排文档,准确率更高 |
这里需要解释两个术语:
- vLLM:一种高性能的 LLM(大语言模型)推理引擎,特点是吞吐量大、延迟低,相当于给模型装了一个「高速公路」。它支持 speculative decoding(推测式解码),可以提前预判下一个 token 来加速生成。
- SGLang:另一种推理框架,主打结构化输出,适合需要严格 JSON 格式的场景。
三、性能数据
| 指标 | 数据 |
|---|---|
| 总星标 | 13,065 ⭐ |
| Fork 数 | 1,053 |
| 创建时间 | 2026-06-18 |
| 最新推送 | 2026-06-28(项目仍在非常活跃地迭代) |
| License | MIT(可商用) |
| Open Issues | 47(社区反馈多,说明使用者在快速增加) |
| 上下文长度 | 32,768 tokens |
| 推理后端 | Transformers / vLLM / SGLang |
需要特别说明:MIT 许可证意味着你可以免费商用、修改、私有化部署,这对企业用户来说是个关键加分项。
四、安装与部署
4.1 基础安装(Transformers 后端,适合测试)
pip install torch==2.10.0 torchvision==0.25.0 transformers==4.57.1
pip install Pillow==12.1.1 matplotlib==3.10.8 einops==0.8.2
pip install pymupdf==1.27.2.2
这套依赖装好后,就可以用 HuggingFace Transformers 直接加载模型。适合本地测试和小流量场景。
4.2 生产级部署(vLLM 后端)
docker pull vllm/vllm-openai:unlimited-ocr一行 Docker 命令就能拉起一个生产级服务,官方提供了带 vLLM 加速的镜像。如果你的业务已经有 Docker 化的部署流程,这套方案几乎可以无缝接入。
4.3 Python 调用示例
from transformers import AutoModel, AutoTokenizer

model = AutoModel.from_pretrained(
    'baidu/Unlimited-OCR',
    trust_remote_code=True,
    torch_dtype=torch.bfloat16
).cuda()
tokenizer = AutoTokenizer.from_pretrained(
    'baidu/Unlimited-OCR',
    trust_remote_code=True
)

model.infer(
    tokenizer,
    prompt='<image>document parsing.',
    image_file='doc.jpg',
    output_path='./output'
)
这段代码展示的是最基础的调用方式:用 Transformers 后端,传入一张图片和一句提示语,模型把结果输出到指定目录。如果换成 vLLM 后端,调用方式会从 Python 函数调用变成 HTTP 接口调用,更适合分布式部署。
五、跟同类项目比,强在哪里?
| 项目 | 总星标 | 特色 | 适用场景 |
|---|---|---|---|
| baidu/Unlimited-OCR | 13,065 | One-shot 超长文档 + vLLM | 长文档、PDF 批量、复杂布局 |
| DeepSeek-OCR | — | 百度上游项目 | 基础文档解析 |
| marker | 9,200+ | PDF 转 Markdown | 文档数字化 |
| Surya | 5,700+ | 多语言 OCR | 国际化文档 |
| docling | 5,100+ | 端到端文档理解 | 复杂报表 |
对比下来,Unlimited-OCR 的差异化主要体现在两点:一是「一次到位」的解析范式,不需要级联多个模型;二是原生支持 vLLM 这种工业级推理框架,对需要私有化部署的企业更友好。
六、值不值得现在就用?
客观评估:可以先小规模测试,但没必要立刻全面部署。理由如下:
- 适用场景匹配:
如果你的业务以「短文本 + 单图」为主,现有的百度 OCR API 已经足够用,不必为了 13K tokens 的超长窗口换方案。 - 部署成本:
本地跑这个模型需要 24GB 以上显存的 GPU,云上租一块 A100 月成本要几千元。如果你只有偶尔处理长 PDF 的需求,调 API 反而更划算。 - 项目成熟度:
发布才 15 天,API 接口还在快速迭代,存在变更风险。等过几个月、生态成熟后再重评估也不迟。
七、可借鉴之处(无论你用不用它)
抛开「用不用 Unlimited-OCR」这个问题,项目本身有几个值得学习的工程实践:
- vLLM 部署架构:
它把 Docker 镜像、speculative decoding、OpenAI 兼容接口整合得很顺滑,这套范式可以直接迁移到你部署其他开源 LLM(比如 Qwen、DeepSeek)的流程里。 - 统一接口设计:
所有能力(单图、多图、PDF)都通过同一套 API 暴露,避免了「每加一种格式就要新写一套接口」的麻烦。这种「一个接口覆盖所有场景」的设计,在你自己做工具封装时也值得参考。 - 批量 PDF pipeline:
它对多页 PDF 的处理流程(PDF → 图片 → 批量解析 → 合并结果)很清晰,可以直接抄来做自己的长文档处理工作流。
结语
Unlimited-OCR 的真正价值,不只是「又多了一个 OCR 工具」,而是它把「One-shot 解析超长文档」这件事的工程门槛拉低了一大截——你不用自己拼 pipeline,不用自己写多阶段调度,拿 Docker 跑起来就能用。这对想快速验证「AI 文档处理」想法的团队来说,是个值得收藏的项目。