
GitHub Trending 今天又上演了一出"中国开源登顶"的戏码——字节跳动的 DeerFlow 一天之内冲到 75,795 颗星,直接把 AI Agent 这条赛道的"重工业标准"摆到了所有人面前。
一、今日 Top 10 AI 相关项目
先看完整版榜单(数据截至 2026-07-02):
| 排名 | 项目名 | 今日星数 | 收录状态 |
|---|---|---|---|
| 1 | x1xhlol/system-prompts-and-models-of-ai-tools | 141,411 | 🆕 新项目 |
| 2 | google-gemini/gemini-cli | 105,699 | 🆕 新项目 |
| 3 | infiniflow/ragflow | 84,087 | 🆕 新项目 |
| 4 | bytedance/deer-flow | 75,795 | 🆕 深入分析 |
| 5 | aaif-goose/goose | 50,550 | 🆕 新项目 |
| 6 | zhayujie/CowAgent | 45,733 | 🆕 新项目 |
| 7 | HKUDS/nanobot | 44,941 | 🆕 新项目 |
| 8 | danny-avila/LibreChat | 40,123 | 🆕 新项目 |
| 9 | ToolJet/ToolJet | 38,121 | 🆕 新项目 |
| 10 | bytedance/UI-TARS-desktop | 37,459 | 🆕 新项目 |
可以一眼看出两件事:
- 大厂下场:字节两条线(DeerFlow + UI-TARS-desktop)同时上榜,加上 Google 的 gemini-cli,巨头们正在把 AI Agent 当作下一个入口战场来打。
- 基础设施先行:system-prompts-and-models-of-ai-tools(聚合各家系统提示词的工具集)冲到第一,RAGFlow、ToolJet、LibreChat 这些"底座型"项目全部在榜——大家都在搭地基。
而 DeerFlow,是其中最值得单独拆解的一个。
二、DeerFlow 是什么?
2.1 一句话定位
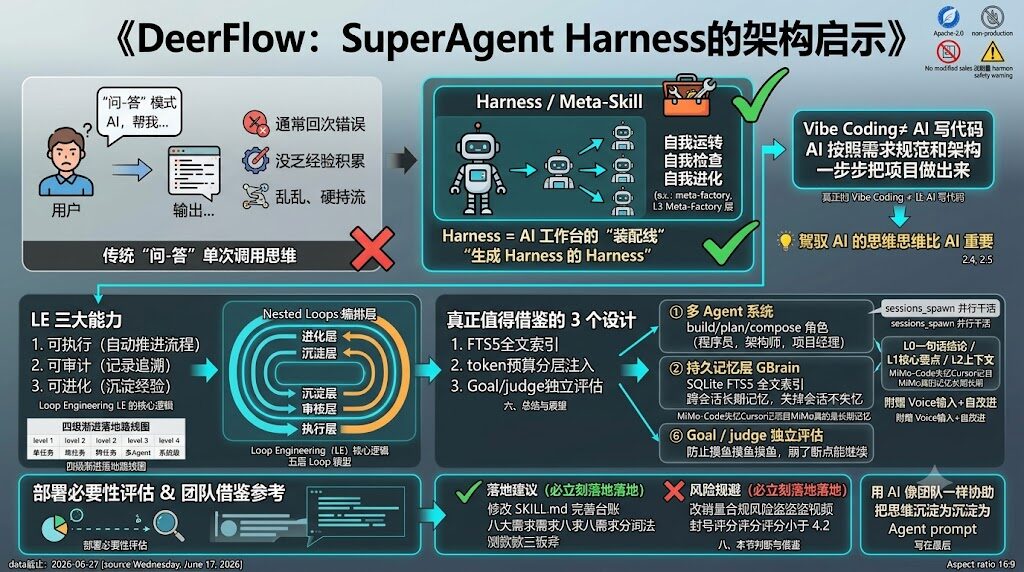
让 AI 从"回答问题"进化到"自主完成长时任务"的 Agent 操作系统。
听起来有点抽象,对吧?换个说法——
你今天让 ChatGPT 帮你写一份竞品分析报告,它会给你列大纲、找资料、写文字,整个过程你得盯着。它更像一个"高级实习生"。
DeerFlow 想做的是"独立的项目经理":你只说一句"帮我做一份 XX 行业的竞品分析",它自己能拆任务、自己调多个 AI 员工、自己跑代码验证、自己把报告做完交给你,全程不用你插手。
这种模式有个专业名字叫 SuperAgent Harness——"超级代理的缰绳"。Harness(缰绳)意味着控制权还在你手里,但具体活儿让"超级代理团队"自己干。
2.2 项目背景
- 出品方:字节跳动(Bytedance)
- 首次创建:2025 年 5 月
- 爆发点:2026 年 2 月 28 日冲上 GitHub Trending 第一
- 当前版本:2.0(完全重写,不是小升级)
- 项目主页:https://github.com/bytedance/deer-flow
2.0 版本是重写而非迭代这件事特别值得注意——说明团队对 1.0 的架构不够满意,干脆推倒重来。背后是字节对"长时任务自动化"这个方向的战略决心。
三、核心架构拆解
3.1 多层 Agent 协作
DeerFlow 最核心的设计是三层 Agent 架构:
| 层级 | 角色 | 职责 |
|---|---|---|
| Super Agent(主管) | 项目经理 | 接收用户需求、拆解任务、分发给子 Agent、汇总结果 |
| Sub Agents(子 Agent) | 专项员工 | 专注某一类任务(如数据抓取、代码执行、文档撰写) |
| Message Gateway | 通信层 | 主管和子 Agent 之间的消息中转,保证协作顺畅 |
这就像一家公司的组织架构:CEO 接大单子,分给各个部门主管,部门主管再分给一线员工。任务可以并行处理,但又有统一调度,不会乱套。
相比之下,很多市面上的 AI Agent 项目是"扁平结构"——所有 Agent 平级,互相抢活儿或者干脆各干各的,最后结果五花八门。DeerFlow 的分层设计明显更成熟。
3.2 记忆系统
很多人不知道 AI Agent 最难的不是"会干活",而是"别失忆"。
你让它做"竞品分析",它查了 20 个网页、跑了 10 段代码、写了一篇报告——如果这中间任何一步它"忘了"前面说过什么,整个报告就崩了。
DeerFlow 内置持久化记忆系统:
- 长期记忆存硬盘,下次启动还能想起上下文
- 支持加载历史样例数据,让新任务"参考过往"
这个能力对运营人来说特别重要。比如你做私域运营,让 AI Agent 帮你跟进 100 个客户——它得记住每个客户上次聊到哪儿了、之前买过什么、有没有特殊偏好。没有记忆系统,这个场景根本跑不通。
3.3 沙箱环境
AI Agent 真正能落地的关键之一,是能不能在受控环境里执行代码、访问资源。
DeerFlow 用 Docker 容器做沙箱:
- 每个子 Agent 在独立容器里跑代码
- 容器之间互相隔离,一个崩了不影响别的
- 资源占用、权限都可以精细控制
这意味着你可以放心让 AI 去执行"读数据库、改文件、调 API"这类需要动手的活儿,而不用担心它把你的生产环境搞坏。
3.4 技能系统 + MCP 支持
DeerFlow 用了两个特别关键的标准:
MCP(Model Context Protocol)——可以理解为 AI Agent 世界的"USB 接口规范"。只要某个工具符合 MCP 协议,DeerFlow 就能直接插上用,不需要额外开发适配层。
技能系统——支持 Claude Code 风格的技能扩展(你可以把它理解成"插件市场"),团队可以根据自己的业务需要,往 DeerFlow 里塞自定义能力。
对运营团队来说,这意味着:
- 今天你能用的工具,明天新出任何 MCP 兼容工具都能立刻接入
- 你公司内部的 ERP、CRM 系统,只要包一层 MCP,DeerFlow 就能调用
3.5 可观测性
最后一点很关键但容易被忽略——可观测性。
DeerFlow 集成了 LangSmith 和 Langfuse 这两个业界标准的追踪工具。这意味着:
- 每个 Agent 做了什么、调了什么、花了多少 Token,你全都能看到
- 出错了能精确回溯到哪一步哪个 Agent
- 成本分析、效率优化都有数据支撑
四、性能数据 & 部署规格
4.1 社区热度
- Star:75,795 ⭐
- Fork:10,235
4.2 硬件要求(不低)
| 场景 | 最低配置 | 推荐配置 |
|---|---|---|
| 本地开发 | 8 vCPU / 16 GB RAM | 16 vCPU / 32 GB RAM |
| 生产环境 | 16 vCPU / 32 GB RAM | 32 vCPU / 64 GB RAM |
注意这个数字——16 GB 内存只是入门门槛。这不是一个轻量级玩具,而是真正的"重工业级" Agent 平台。普通个人电脑很难跑起来。
4.3 一键部署命令
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow
make setup
make docker-start
# 访问 http://localhost:2026部署本身做得很友好——make setup + make docker-start 两步搞定。但记住,前提是你机器够强。
五、横向对比
把 DeerFlow 放到当前主流 AI Agent 框架里看:
| 维度 | DeerFlow | OpenClaw | LangGraph |
|---|---|---|---|
| 子 Agent 协作 | ✅ | ✅ | ✅ |
| 持久化记忆 | ✅ | ✅ | ❌ |
| 沙箱环境 | ✅ Docker | ⚠️ 受限 | ❌ |
| MCP 协议支持 | ✅ | ✅ | ❌ |
| 可观测性 | ✅ LangSmith/Langfuse | ❌ | ❌ |
这张表里能看出几个判断:
- DeerFlow vs LangGraph:LangGraph 是个开发框架,DeerFlow 是个完整产品。LangGraph 更灵活,但你得自己造轮子(记忆、部署、追踪)。DeerFlow 是开箱即用。
- DeerFlow vs OpenClaw:OpenClaw 的优势是"轻",能跑在普通机器上,适合中小团队和日常运营场景。DeerFlow 是"重武器",适合大企业、有算力的团队、需要跑长时复杂任务的场景。
六、对运营团队的可借鉴之处
虽然不是每个团队都要自己部署 DeerFlow,但它的设计思路是普适的。
6.1 标准化子 Agent 协作模式(高优先级)
不要试图做一个"全能 AI"。
参考 DeerFlow 的做法:把工作拆成多个专项 Agent——文案 Agent、选题 Agent、数据 Agent、客服 Agent——让一个主管 Agent 来调度它们。
比如一个电商团队的内容工作流:
- 主管 Agent:接需求"双 11 大促推文"
- 选题 Agent:基于历史数据挑 3 个高潜力选题
- 文案 Agent:针对每个选题写不同平台版本(小红书 / 公众号 / 抖音)
- 配图 Agent:调图床 + 文生图模型生成配图
- 审核 Agent:合规检查 + 品牌调性检查
- 发布 Agent:定时分发到各平台
每个 Agent 干自己最擅长的事,主管 Agent 负责串起来。这才是真正能跑起来的 AI 团队。
6.2 一句话启动体验
DeerFlow 的体验目标是"一句话启动一个长时任务"——这个 UX 思路值得学。
你有没有想过,你团队里的运营 SOP 能不能也做到"一句话启动"?
比如:
- "帮我给这批新客户发欢迎语" → 自动调模板 + 批量发送 + 记录回执
- "帮我盘点这个月所有异常订单" → 自动跑查询 + 出报告 + 发邮件
- "帮我把这篇公众号文章改写成 5 个平台版本" → 自动改写 + 排版 + 入草稿箱
如果你的工具链能做到"一句话启动一个完整工作流",效率提升是数量级的。
6.3 可观测性集成
很多团队部署了 AI Agent,但完全看不到 Agent 在干什么——只看到最终结果对不对。这等于蒙眼开车。
建议:
- 至少记录:每次任务花了多长时间、调了哪些工具、花了多少 Token、有没有出错
- 优先用现成工具:LangSmith、Langfuse 都是免费开源的,接入成本很低
- 建立复盘机制:每周看一次 Agent 的运行日志,找能优化的环节
七、💡 落地案例:电商场景的部署评估
最后说说我对这个项目在电商场景的评估。
结论:暂不部署,但设计模式高度可借鉴。
原因有三:
- 资源消耗过大:16 GB 内存起步,对一个电商运营团队来说不划算。我们日常用的内容生成、客服回复场景,本地用更轻量的方案就够了。
- 场景匹配度不高:DeerFlow 主打"小时级长时任务",但电商日常运营更看重"分钟级响应"——用户问个尺码表,希望秒回,不是等 AI 跑 10 分钟。
- 成熟度仍在迭代:2.0 版本是重写后的第一个大版本,文档、案例、踩坑笔记都还在沉淀。等 3.0 再看更稳。
但有两点我们已经在内部复用了:
- 主管 + 子 Agent 分层结构:用在我们自己的内容生产链上,效率提升明显
- MCP 协议思路:对接公司 ERP、CRM 时,优先支持 MCP 标准的工具
你也可以用类似方式评估自己的场景:
- 算力充足吗?(≥16 GB 内存 + 8 核 CPU)
- 任务是"长时复杂"还是"短时高频"?
- 团队有没有能力维护 Docker 部署?
三个问题里只要有两个"是",再考虑自己部署 DeerFlow;否则,借鉴它的设计思路搭自己的轻量方案更划算。
八、写在最后
DeerFlow 的意义,不在于"我们都得用它",而在于它把"AI Agent 工业化"这件事做实了——分层架构、记忆系统、沙箱隔离、可观测性——这些过去散落在各家框架里的概念,被字节用一个完整产品系统化地整合到了一起。
接下来一年,这种"重工业 Agent 平台"会成为大厂的标配。而中小团队更现实的选择,是学它的设计思路,用轻量工具搭适合自己的版本。
就像云计算时代不是每家公司都要自建机房,但每家公司都得懂云架构——AI Agent 时代也是一样的逻辑。
资料来源
- GitHub 项目主页:https://github.com/bytedance/deer-flow
- 项目分析文档:~/Obsidian-Vaults/it-engineer/知识库/github星标项目/2026-07-02_deer-flow分析.md