
核心观点:Loop Engineering 不是新框架,而是一种"一次启动、循环完成"的新范式——它的出现依赖 Agent Loop、MCP、Harness Engineering(Deep Agent)三件事的成熟。
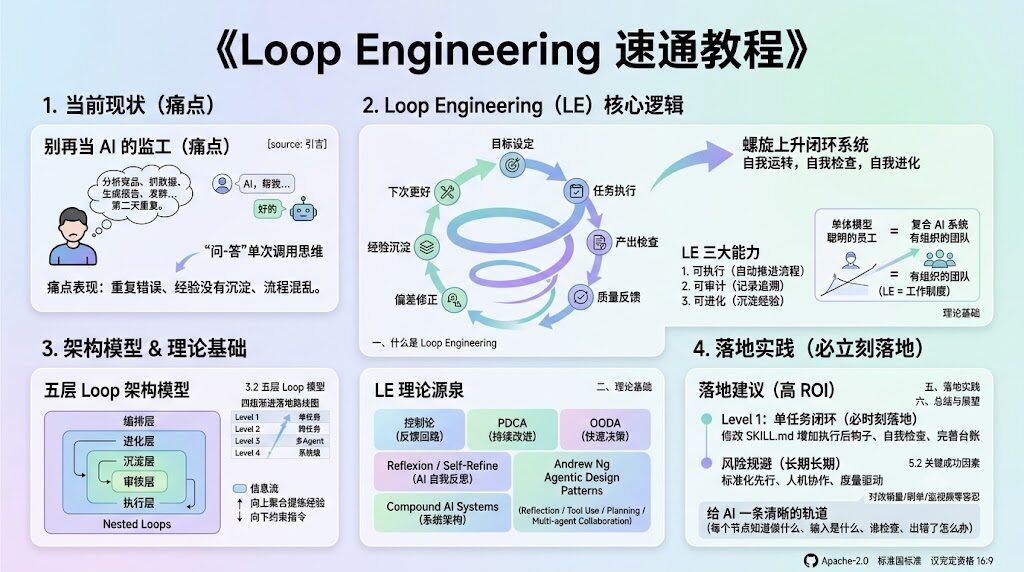
第一章 导读:为什么需要这份教程
Loop Engineering(循环工程)这个词在 2026 年 6 月 7 日由 OpenAI 工程师 Osman(同时也是 Claude Code 的开发者)正式提出,仅用一周时间就成为 AI 工程领域最热的话题。几乎在同一时间,Claude Code 的负责人在采访中公开表示"我再也不写 prompt 了,我写循环",OpenAI 也在 X 上发文"别再 prompt 编码了,去设置循环"。
这三件事同时发生并非偶然。本教程会按照"概念 → 历史 → 范式对比 → 模块拆解 → 实战要素 → 真实案例 → 开发者新角色"的顺序,把这件事彻底讲清楚。学完本教程后,你将能够:
- 准确区分 Agent Loop 与 Loop Engineering 的本质差异
- 理解 Loop Engineering 出现的 4 个先决条件
- 在 LangChain Deep Agent 框架上落地一个最小可用的 Loop
- 识别并规避 7 类典型风险(无限循环、目标偏移、上下文溢出、静默失败、Token 爆炸、认知负债、认知投降)
第二章 课程前言
2.1 这门课面向谁
本课程同时覆盖两类受众:
- AI 小白:只听过 Agent、AIGC 这些名词,没有真正开发过。本课程会从 2022 年的 ReAct 论文讲起,把四年的发展脉络完整串一遍。
- 已经在做 AI 开发的工程师:建议先把已有的框架知识"清零",因为接下来要讲的内容虽然简单,但是是过去式——它已经发生,只是大部分人还没意识到。
核心提示:本课不是讲一个新的颠覆性框架,而是讲一种"当现有框架都成熟后,自然演化出来的新范式"。
2.2 这门课会讲什么
本课程按照以下逻辑推进:
- 概念奠基:什么是 Agent Loop、什么是 Loop Engineering
- 历史溯源:2022 → 2026 四年的关键节点
- 范式对比:Prompt / Context / Harness / Loop Engineering 四种 engineering 的边界
- 模块拆解:五大构建块 + 记忆层
- 设计要素:11 个设计要素 + 7 类风险
- 实战案例:合同自动化处理的完整 Loop 实现
- 开发者新角色:未来程序员应该把精力花在哪里
2.3 学习路径建议
- 完全零基础:1.1 → 1.2 → 第二章 → 第三章 → 第八章
- 有 Agent 开发经验:2.1 → 2.2 → 第三章(重点看 3.5-3.6)→ 第四章 → 第五章 → 第七章
- 想直接上手写 Loop:第五章 → 第六章 → 第七章
第三章 核心理念:Agent Loop 与 Loop Engineering
3.1 Agent Loop:智能体循环
Agent Loop 翻译过来就是"智能体循环",是 Agent 执行任务时的基本工作机制。
Agent 与普通大模型的核心区别在于三点:
- 能自主调用工具:不需要人手动执行工具调用
- 有上下文记忆:能保留前序对话与执行状态
- 有循环决策能力:能自己判断"是否需要继续调用工具"还是"直接给用户回答"
"Loop"就是指"思考 → 行动 → 观察 → 再思考 → 再行动"这个循环。
早期实现(LangChain 0.1 时代):
while not finished:
    observation = env.observe()
    thought = llm.think(observation)
    if thought.needs_tool():
        action = thought.action
        result = env.execute(action)
        memory.append(result)
    else:
        return thought.answer
这就是典型的 while 循环驱动 Agent,每一轮都让大模型决定下一步动作。
现代实现(LangChain 0.3+):
LangChain 新版本(0.3 之后)已经不再用 while 循环实现 Agent Loop,而是改用 LangGraph——一个有向无环图(DAG)的状态机。每个节点是一个动作,边是状态转移条件。这种实现更可控、更易观测、更易调试。
关键区分:Agent Loop 是"每一次对话内部"的小循环,Loop Engineering 是"完成整个工程"的大循环。两者不是替代关系,而是包含关系——一个大 Loop 里通常包含多个 Agent Loop。
3.2 Loop Engineering:循环工程
Loop Engineering = Loop(循环)+ Engineering(工程),直译"循环工程"。
这个词由 Osman 在 2026 年 6 月 7 日发表的长文中正式定义。Osman 的背景:
- Claude Code 的原始开发者
- 2026 年 2 月跳槽到 OpenAI
- OpenAI 内部 Loop Engineering 理念的主要推动者
Loop Engineering 的核心思想:
完成一项工程,你只需要启动一次。不需要中途对话、不需要人写 prompt、启动后让它自己跑,结束时就直接给你最终结果。
对比示例:
一个具体例子:
假设你要"发布一篇文章到 3 个平台":
- Agent Loop 模式(传统):你 → 写 prompt 让 AI 起草文章 → AI 输出 → 你检查 → 你再写 prompt 改 → AI 再输出 → 你让 AI 发布到平台 1 → AI 报错 → 你再写 prompt 改 → …(你介入 10+ 次)
- Loop Engineering 模式:你 → 设计好 Loop(输入文章主题、3 个平台、终止条件)→ 启动 → 4 小时后收到邮件"已发布完成,3 个平台均成功" → (你介入 1 次)
核心机制:
- 内部会包含多个 Agent 之间的协作(sub-agent)
- 每个 sub-agent 有自己独立的上下文
- 整个 Loop 有明确的"目标 → 终止条件 → 升级机制"
- 人不介入过程,只在异常时介入
3.3 Loop Engineering 与 Prompt Engineering 的关系
网上很多文章说"Prompt Engineering 已被 Loop Engineering 取代"——这是误导。
Loop Engineering 不是 Prompt Engineering 的替代品,而是 Prompt Engineering 的更高级封装:
- Loop Engineering 的输入(启动 prompt)反而比 Agent Loop 单次 prompt 要求更高
- Loop 内部每个 Agent 的子 prompt 仍需要精心编写
- Skill 本身就是一种结构化 prompt
正确理解:Prompt Engineering 是 Loop Engineering 的基础组件,不是被替代的"旧范式"。
3.4 Loop Engineering 出现的 4 个先决条件
Loop Engineering 不是凭空出现的,它依赖四件事的同步成熟(详见第三章历史):
- Agent 能稳定调用工具 —— MCP 协议标准化(2024-2025)
- 运行成本可控 —— Token 单价大幅下降 + 框架自带压缩机制
- 上下文能自动管理 —— Deep Agent 等框架内置 checkpointer / store
- 独立验证机制成熟 —— Maker / Checker 架构成为标准
这四件事在 2026 年 6 月前同时成熟,于是 Loop Engineering 应运而生。
第四章 历史演进:从 ReAct 到 Loop Engineering(2022-2026)
理解这段历史对理解今天的技术栈至关重要。本章按时间线梳理四个关键节点。
4.1 年 10 月:ReAct 论文——思考与行动合并
2022 年 10 月,ReAct(Reasoning + Acting)论文由 Princeton 和 Google 的联合团队发表。
核心贡献:把"推理"(Reasoning)和"行动"(Acting)合并到一个循环里。
在此之前,大模型只能做静态推理——你给它一个事实,它推导出相关信息,但不能用推理的结果再去执行下一步动作。ReAct 提出了"思考 → 行动 → 观察 → 再思考"的循环范式。
深远影响:
- LangChain 内部的 Agent 实现
- OpenAI Agent API
- Claude Agent SDK
- 几乎所有后续 Agent 框架
ReAct 的局限:
- 只是"单次对话"内的循环
- 每轮都需要人发起
- 没有"长循环"概念
📌 ReAct 解决了 Agent 内部的"小循环"问题,但没有解决"工程级别的长循环"问题。
4.2 年 3 月:AutoGPT 与 BabyAGI——第一次"放手让 AI 自己跑"
2023 年 3 月,AutoGPT 和 BabyAGI 两个开源项目同时引爆 GitHub(各获得 10 万+ Star)。
它们做的事:
- 让 GPT-4 自己设定目标
- 拆解任务
- 串行执行
- 完成后生成新目标
- 继续循环
为什么失败了:
- 死循环 / 空转:模型不知道什么时候该停,任务链越来越长,token 消耗无止境
- 幻觉严重:早期模型能力弱,目标拆解经常跑偏
- 无意义产出:执行了一堆任务但产出与用户原始目标无关
这两个项目的失败证明了一件事:仅靠"大模型自主决策 + while 循环"是不够的,必须有强约束的终止条件和结构化任务管理。
📌 AutoGPT 的失败不是方向错,而是基础设施(模型能力、工具标准、框架)都不成熟。
4.3 年:Function Calling 标准化 + LangChain 框架成熟
2024 年是 Agent 基础设施的关键一年。
上半年:Function Calling(OpenAI 提出)
OpenAI 推出 Function Calling 能力——大模型可以结构化地调用工具,告别"在 prompt 里手写 if-else 解析工具返回"。
同期 Anthropic 推出 Tool Use(后来演化为 MCP)。
核心变化:
- 之前:工具调用靠 prompt 工程凑合
- 之后:工具调用成为大模型的一等公民能力
意义:开发者从"研究怎么让 AI 调用工具"转向"怎么把业务工具封装好"。
下半年:MCP 协议(Anthropic 提出)
2024 年 11 月底,Anthropic 提出 MCP(Model Context Protocol)——一个"USB 接口"式的工具调用标准。
MCP 解决的问题:
- 之前每家大模型(OpenAI / Anthropic / Google)的工具调用格式都不同,换模型要重写
- 有了 MCP,工具只需开发一次,所有支持 MCP 的模型都能用
2024 年中:LangChain 框架出现
Harrison Chase 创立的 LangChain 在 2024 年发布 0.1+ 版本(最初 0.2),让 Agent 开发从"手写 while 循环"进入"框架时代"。
📌 2024 年的关键词是"标准化"——Function Calling 标准化工具调用、MCP 标准化工具协议、LangChain 标准化 Agent 开发。
4.4 年:Deep Agent 与 Claude Agent SDK——Harness Engineering 落地
2025 年是 Harness Engineering 落地的关键年。
2025 年 3 月:OpenAI 宣布 Agent SDK 支持 MCP。
2025 年 4 月:阿里、百度、微软、Google 全部宣布支持 MCP——MCP 正式成为行业标准。
2025 年 7 月:LangChain 发布 Deep Agent(LangGraph 深度封装)。
Deep Agent 首次提出几个关键概念(虽然早期版本不成熟):
- Sub-agent 隔离:一个 Agent 可以调用其他 Agent,彼此上下文独立
- Skill:可复用的能力单元
- 文件沙箱:Agent 操作的虚拟文件系统,不影响主机
2025 年 9 月:Anthropic 发布 Claude Agent SDK——Claude Code 的底层 API。
Claude Agent SDK 提供的能力:
- 上下文管理 / 压缩
- 工具执行权限控制
- Sub-agent 编排
- 与 LangChain Deep Agent 对标
Harness Engineering 的概念成型:
Deep Agent 和 Claude Agent SDK 标志着 Harness Engineering(驾驭工程)有了具体的落地框架。其核心思想是"让 AI 安全地、可观测地、可控地运行"。
4.5 年 7 月:Ralph Loop——循环思想的早期实践
在 LangChain Deep Agent 刚发布的同时,另一位独立工程师(Ralph)做了一件纯手写 Agent 的事——用 3 个月时间,让 AI 自己用 while 循环写出了一门新的编程语言(命名为 "Curst")。
他把自己用的循环模式命名为 Ralph Loop。
Ralph Loop 的两个关键设计:
- 环境状态上下文:不让大模型"记住"上下文,而是把执行结果写到文件里,每次循环从文件读取最新状态
- Stop Hook 机制:循环有明确的停止钩子,达到条件时强制退出
📌 Ralph Loop 没有大火,但它的思想被 Deep Agent / Claude Agent SDK 吸收——即"环境状态 + 显式终止条件"是 Loop Engineering 的必要组件。
4.6 年 4-5 月:Maker / Checker 架构标准化
2026 年 4-5 月,OpenAI、Anthropic、阿里千问同步采用 Maker / Checker 架构用于内部 Agent 编排。
Maker / Checker 的核心思想:
- Maker(构建者):负责执行任务,理解业务后干活
- Checker(检查者):独立检查结果是否符合目标,不看 Maker 的推理过程
为什么需要 Checker:
"避免过度自信地表扬自己的平庸工作"——Agent 自己做的链路它自己觉得都对,没法自我评判。必须引入独立的第三方。
Checker 的行为约束:
- 只读结果,不读过程(避免被 Maker 的推理过程"污染"判断)
- 只评判"是否完成目标",不给修改建议
- 独立上下文、独立的工具权限
与 Loop Engineering 的关系:
Maker / Checker 是 Loop 内部的核心协作机制——一个 Loop 通常包含 1 个调度 Agent + 多个 Maker/Checker 对。
4.7 年 6 月:Loop Engineering 正式提出
2026 年 6 月 7 日,Osman 发表 Loop Engineering 长文,核心论点:
- 不要每次对话写 prompt
- 设计循环,让 Agent 自主完成整个工程
- 一次启动,一次结果
几乎同时(6 月 9 日),Claude Code 负责人在采访中表示"我再也不写 prompt 了,我写循环"。
OpenAI 也在 X 上发文:"别再 prompt 编码了,去设置循环"。
为什么是 2026 年 6 月(而不是更早或更晚):
- MCP 成熟(2025 年中)→ 工具调用标准化
- Token 成本降低 → 长时间循环不"破产"
- Deep Agent / Claude Agent SDK 成熟 → Harness Engineering 落地
- Maker / Checker 成为标准 → 独立验证机制成熟
四件事同步成熟,Loop Engineering 应运而生。
📌 核心结论:Loop Engineering 不是 Osman 凭空发明的,而是过去四年积累到 2026 年 6 月自然涌现的范式。
第五章 范式对比:四种 Engineering 的边界
开发 AI 应用时,你经常会听到四种 "Engineering"——很容易混淆。本章一次性把它们讲清楚。
5.1 Prompt Engineering——让 AI 理解你的问题
定义:通过精心设计的提示词,让大模型理解你的意图、角色、输出格式、约束条件。
核心关注点:
- 角色设定("你是一个资深 Python 工程师")
- 输出格式("用 Markdown 表格返回")
- 任务描述("请把以下代码重构为函数式风格")
- Few-shot 示例(给几个样例让 AI 模仿)
典型场景:
- 单次问答
- 文本生成、改写、翻译
- 一次性的小任务
局限:
- 每次都需要人写 prompt
- 人要持续参与判断输出是否符合预期
- 不能管理长对话的上下文
5.2 Context Engineering——让 AI 知道它有什么
定义:管理大模型可用的"上下文"——包括历史对话、可用工具、可用文件、可用记忆。
核心关注点:
- 哪些历史对话保留、哪些丢弃
- 哪些工具对当前任务相关
- 哪些文件 / 数据需要塞进上下文
- 短期记忆 vs 长期记忆的管理
典型场景:
- 长对话(AI 会"失忆",需要主动管理上下文)
- 多文件项目(需要告诉 AI 整个项目结构)
- 多 Agent 协作(每个 Agent 需要哪些上下文)
与 Prompt Engineering 的关系:
- Prompt Engineering 关注"说什么"
- Context Engineering 关注"给它什么"
两者不是替代,是互补——一次完整的 Agent 调用,既需要好的 prompt,也需要合适的 context。
5.3 Harness Engineering——让 AI 安全运行
定义:通过架构设计,让 AI 在一个"有护栏"的环境里运行,避免破坏系统、跑偏目标。
核心关注点:
- 沙箱(Sandbox):AI 的操作在虚拟环境中进行,不影响主机
- 权限隔离:AI 能做什么、不能做什么
- 上下文隔离:Sub-agent 之间互不可见
- 状态后端:把 AI 的执行结果持久化到存储
落地框架:
- LangChain Deep Agent:开源的 Harness Engineering 框架
- Claude Agent SDK:Anthropic 官方 SDK,Claude Code 的底层
- OpenAI Agent SDK:OpenAI 官方 SDK
核心价值:
Harness 是"完成 Loop Engineering 的底座",没有 Harness Engineering,就没有 Loop Engineering。
5.4 Loop Engineering——让 AI 完成整个工程
定义:设计一个长循环,让 AI 自主完成一项完整工程,中途不需要人介入。
核心关注点:
- 启动 prompt(一次性输入完整需求)
- 终止条件(什么时候算完成)
- 升级机制(搞不定时怎么叫人)
- 内部 sub-agent 协作
- 状态持久化
与前三者的关系:
Harness(底座) → Loop(应用层) → Context(每次循环) → Prompt(每次调用)- Harness 提供安全运行的环境
- Loop 在这个环境上跑
- Loop 内部每次循环涉及 Context 与 Prompt 的管理
5.5 四种 Engineering 的对比表
5.6 常见误解澄清
误解 1:Loop Engineering 替代了 Prompt Engineering
错。Loop Engineering 的输入 prompt 反而比单次 Agent Loop 要求更高,Loop 内部每个 sub-agent 的 prompt 仍需精心编写。Prompt Engineering 是 Loop 的基础组件,不是被替代的"旧范式"。
误解 2:Harness Engineering 等于 Deep Agent
不完全对。Harness Engineering 是一种思想(让 AI 安全运行),Deep Agent 是落地框架。同一思想可以有不同的实现。
误解 3:Loop Engineering 是新框架
错。Loop Engineering 是新范式——它的实现完全基于现有框架(Deep Agent / Claude SDK / Codex)。不需要等新框架出来,今天就可以开始做。
📌 正确理解四种 Engineering 的关系:Prompt → Context → Harness → Loop 是逐层向上封装的,Loop Engineering 是当前最高层级的范式。
第六章 五大构建模块全解析
Osman 的 Loop Engineering 长文中明确提出:构建一个 Loop Engineering 系统需要五大构建块 + 一个记忆层。本章逐一拆解。
6.1 模块一:自动化调度
定义:让 Loop 启动后能自动触发、自动运行,不需要人干预。
三种触发方式(可单独使用,也可组合):
- 定时触发(Cron):每隔一段时间执行一次
- 典型场景:每天 9 点检查退款、定时巡检服务器
- 实现:传统 cron job / 框架的 scheduler
- 事件触发(Event):外部事件发生时执行
- 典型场景:上传文件后自动处理、收到邮件后自动回复
- 实现:监听事件 / 回调函数
- 目标驱动(Goal-driven):启动后跑直到完成目标
- 典型场景:自动写文章、自动生成报告
- 实现:状态机 / 终止条件判断
组合示例(第七章合同案例会用到):
定时触发(每 10 秒扫描目录)+ 目标驱动(合同处理完成)= 一个完整的 Loop
常见误区:
- 误以为必须用一种触发方式 → 实际可以混用
- 误以为定时就是 cron → 实际框架内也有 scheduler
6.2 模块二:环境隔离
定义:Loop 内的不同 sub-agent 之间、sub-agent 与主机之间,都要做好隔离,避免互相影响。
隔离的两个维度:
- 环境隔离(Environment):每个 sub-agent 在独立的虚拟环境里运行
- Claude Code 用 working tree
- LangChain Deep Agent 用 sandbox / file state backend
- 上下文隔离(Context):每个 sub-agent 有独立的 context window
- 互相看不到对方的对话历史
- 只通过"返回值"传递信息
为什么必须隔离:
- 防止 AI 操作误删主机文件
- 防止一个 sub-agent 的错误污染另一个
- 防止上下文互相干扰导致判断失误
📌 Deep Agent / Claude Agent SDK 默认提供这两层隔离,开发者不需要自己实现。
6.3 模块三:Skill
定义:可复用的能力单元,封装了"做某件事"的完整流程与工具。
Skill 的三大特性:
- 渐进式披露(Progressive Disclosure):默认只告诉 AI"我能做什么",AI 用到时才加载详细步骤
- 节省 token
- 减少无关信息干扰
- 工具组合:Skill 内部可以调用多个工具
- 例:"写文章" Skill 内部 = 大模型生成 + 文件保存 + 格式校验
- 可嵌套:Skill 可以调用其他 Skill
Skill 与 Prompt 的区别:
- Prompt 是"说什么"的文本
- Skill 是"怎么做"的结构化流程
写 Skill 本质上是写"高级 prompt + 工具编排"。
6.4 模块四:工具与连接器
定义:Agent 能调用的所有外部能力的统称——MCP server、API、函数、本地脚本等。
三种工具形式:
- MCP 工具:通过 MCP 协议暴露的工具
- 标准化
- 跨模型兼容
- 推荐使用
- API 包装函数:把 HTTP API 包成 Python 函数
- 灵活
- 需要每个模型都适配一遍
- 本地脚本:直接调用本地可执行文件
- 性能好
- 难跨平台
工具的"装饰器"模式:
现代框架(如 LangChain)支持用装饰器把普通函数注册为 Agent 可识别的工具,无需写额外的协议代码。
工具开发是 Loop Engineering 的核心工作:
Loop Engineering 看起来"一句话就完成",但背后需要大量工具与 Skill 的开发。"开发量从 prompt 转到了工具和 Skill。"
6.5 模块五:Sub-Agent 协作
定义:一个主 Agent 调度多个 sub-agent,每个 sub-agent 负责一个独立的子任务。
Sub-Agent 的三大特性:
- 独立上下文:每个 sub-agent 看不到其他 sub-agent 的对话
- 独立工具:每个 sub-agent 有自己的工具集
- 独立环境:每个 sub-agent 在自己的沙箱里执行
Sub-Agent 协作的两种模式:
- 流水线模式:sub-agent 串行执行,上一环输出作为下一环输入
- Maker / Checker 模式:一对 sub-agent,Maker 干活、Checker 检查(详见 3.6)
调度 Agent 的职责:
- 理解主任务
- 拆解为子任务
- 分发给合适的 sub-agent
- 汇总 sub-agent 的结果
- 判断是否完成主目标
📌 Sub-Agent 协作是 Loop Engineering 内部"分工"的核心机制。
6.6 模块六:记忆层
定义:Loop 运行过程中需要"记住"的信息——短期记忆、长期记忆、工作记忆。
三种记忆类型:
- 工作记忆:当前任务正在用的数据
- 短期记忆:当前会话的历史
- 长期记忆:跨会话持久化的信息
LangChain Deep Agent 的实现:
- Checkpointer:保存每一轮的状态,支持回滚与恢复
- Store:长期记忆的存储,支持向量检索
记忆的作用:
- 让 Loop 在长循环中不"失忆"
- 让 Loop 跨会话继承之前的经验
- 让 sub-agent 之间能间接传递信息(通过共享记忆)
6.7 五大模块的依赖关系
                    自动化调度(触发)
                          ↓
        ┌────────── 环境隔离 ──────────┐
        ↓                              ↓
   Sub-Agent 协作  ←  Skill  ←  工具
        ↓
记忆层(贯穿)关键洞察:
- 五大模块是正交的——任何一个出问题,整个 Loop 都会失败
- 现有框架(Deep Agent / Claude SDK)已经内置了80% 的能力
- 开发者真正要做的,是业务层的工具与 Skill
📌 核心结论:做 Loop Engineering 不是"重新发明轮子",而是"在 Deep Agent / Claude SDK 上做业务封装"。
第七章 设计 Loop 的要素与风险
设计一个生产可用的 Loop,需要关注11 个设计要素与7 类典型风险。本章逐一拆解。
7.1 个设计要素
7.1.1 目标(Goal)
整个 Loop 要完成什么?必须极其明确——是"发一篇文章到 3 个平台",不是"做点内容运营"。
SMART 原则:
- Specific:具体
- Measurable:可衡量
- Achievable:可达成的
- Relevant:相关的
- Time-bound:有时间边界
7.1.2 触发方式(Trigger)
Loop 怎么启动?定时 / 事件 / 目标驱动?频率是多少?
7.1.3 任务范围(Scope)
Loop 内的 sub-agent 分别做什么?边界要清晰——Maker 只干活,Checker 只检查,不交叉。
7.1.4 工作空间隔离(Workspace Isolation)
Loop 涉及多个 Agent 时,每个 Agent 要在独立的沙箱里运行。
7.1.5 上下文管理(Context Management)
- 哪些信息放短期记忆?
- 哪些信息放长期记忆?
- 什么时候压缩?
- 什么时候清空?
7.1.6 Sub-Agent 委托(Delegation)
主 Agent 怎么把任务拆给 sub-agent?规则是什么?
7.1.7 验证机制(Verification)
谁来检查 sub-agent 的输出?检查标准是什么?判断流程是什么?
7.1.8 状态(State)
整个 Loop 当前处于什么状态?需要持久化哪些数据?
7.1.9 预算(Budget)
- 最大轮数(防止无限循环)
- Token 上限(防止成本爆炸)
- 时间上限(防止跑太久)
这是 Loop Engineering 最容易踩坑的地方——预算没设好,Loop 一晚上烧掉几千美元是常见事。
7.1.10 升级机制(Escalation)
Loop 搞不定时,怎么叫人?怎么通知?通知渠道是什么(邮件 / 短信 / 企业微信)?
7.1.11 日志(Logging)
Loop 跑完后,需要留下什么日志?给谁看?包含什么字段?
完整日志应包含:
- 每个 sub-agent 的输入输出
- 每次工具调用的参数与返回
- 每次判断的决策依据
- 异常信息
7.2 类典型风险
7.2.1 风险一:无限循环
症状:Loop 跑了一晚上,token 烧光也没停。
根因:终止条件没设好,或终止条件判断逻辑有 bug。
应对:
- 设最大轮数(10 / 20 / 50 视场景)
- 设 Token 上限
- 设时间上限
- 加 stop hook(强制中断)
7.2.2 风险二:目标偏移
症状:Loop 跑着跑着,做的事和原始目标越来越远。
根因:需求不明确、Skill 边界不清、sub-agent 之间目标不一致。
应对:
- 在写 Skill / 工具时,把"边界"和"目标"写在 prompt 最前面
- 让 Checker 持续检查"是否还在主目标上"
- 当检测到偏移,主动让主 Agent 重新校准
7.2.3 风险三:上下文溢出
症状:对话太长,token 超限报错。
应对:
- 用框架自带的压缩机制(Deep Agent 默认有)
- 主动管理短期记忆
- 把长对话状态持久化到文件
7.2.4 风险四:静默失败
症状:Loop 看起来在跑(日志正常),但实际什么都没产出。
根因:评估器(Checker)逻辑有问题——Maker 做的事 Checker 看不到,Checker 问的问题 Maker 接不到。
应对:
- Maker 与 Checker 必须通过标准化的中间格式通信(如 JSON schema)
- 加"心跳"日志:每个 sub-agent 定时输出"我正在做什么"
- 人在关键节点 review 日志
7.2.5 风险五:Token 成本爆炸
症状:一个 Loop 跑了 24 小时,账单一万多美元。
根因:无限循环 + 模型选贵 + 没设上限。
应对:
- 强制设 Token 上限
- 监控面板:实时看到每个 Loop 消耗多少 token
- 重要任务用便宜模型(Haiku / GPT-4o mini)
预测:2026 年下半年会出现"Loop 监控平台"——实时展示哪些 Loop 在跑、消耗多少 token。这是新的细分赛道。
7.2.6 风险六:认知负债
症状:3 个月后回头看代码,发现自己写的东西已经看不懂了。
根因:长期不读 AI 写的代码,认知逐步脱节。
应对:
- 定期 review AI 写的代码(每周至少 1 次)
- 关键代码段必须人工 review
- 用 CI/CD + 单测保证可维护性
7.2.7 风险七:认知投降
症状:完全信任 AI 的输出,不再独立判断其正确性。
根因:长期"看都不看就点同意"。
应对:
- 关键决策点强制人工 review
- 重要任务用 Maker / Checker 双 Agent 互检
- 团队层面建立"AI 输出 review"文化
7.3 风险检查清单(设计 Loop 时对照使用)
设计 Loop 时,逐项打勾:
- [ ] 有明确的目标 + 终止条件
- [ ] 设了最大轮数 / Token 上限 / 时间上限
- [ ] Sub-agent 之间上下文隔离
- [ ] Maker / Checker 通信用结构化格式
- [ ] 有心跳日志
- [ ] 有升级通知机制
- [ ] 有完整执行日志
- [ ] 关键决策点有人工 review 机制
- [ ] 团队成员会定期读 AI 写的代码
- [ ] 有监控面板或计划引入
📌 一个生产级 Loop 必须同时满足这 10 项,缺一项就可能出大事故。
第八章 实战案例:合同自动化处理 Loop
本章用"自动处理合同"这个真实业务场景,把前 6 章所有概念串起来。
8.1 业务背景
场景:法务部门每天会有 5-10 份新合同进入待处理文件夹。需要做的事:
- 识别合同类型(采购 / 销售 / 劳动合同)
- 提取关键信息(甲方乙方 / 金额 / 期限)
- 检查条款风险(异常条款 / 缺失条款)
- 生成摘要报告
- 提交给法务审核
传统做法:法务助理手动处理,每份 30 分钟。
Loop Engineering 做法:放进文件夹 → Loop 自动处理 → 法务只 review 报告。
8.2 整体架构
   ┌──────────────┐
   │  合同文件夹   │ (定时扫描)
   └──────┬───────┘
          ↓
   ┌──────────────┐
   │ 主 Loop 调度  │ (目标驱动)
   └──────┬───────┘
          ↓
   ┌──────┴───────┐
   ↓              ↓
┌────────┐   ┌────────┐
│ Maker  │   │Checker │
│处理合同│   │检查结果│
└────┬───┘   └───┬────┘
     ↓           ↓
     └───→ 输出报告 ←───┘
                ↓
         (异常时通知人)
8.3 核心代码骨架(Python + LangChain Deep Agent)
8.3.1 Loop 主循环
import time
from pathlib import Path
from contract_processor import ContractProcessor
from report_generator import ReportGenerator
class ContractLoop:
def __init__(self, watch_dir: str, max_rounds_per_contract: int = 10):
self.watch_dir = Path(watch_dir)
self.processor = ContractProcessor()
self.reporter = ReportGenerator()
self.max_rounds = max_rounds_per_contract
self.budget_tokens = 100_000 # 单个合同 token 上限 def run(self):
"""主循环:每 10 秒扫描一次目录"""
while True:
pending = self.scan_pending()
for contract_path in pending:
self.process_one(contract_path)
time.sleep(10) def scan_pending(self) -> list:
return list(self.watch_dir.glob("*.pdf")) + list(self.watch_dir.glob("*.docx")) def process_one(self, contract_path: Path):
"""处理单个合同:单轮循环 + 最大轮数限制"""
for round_idx in range(self.max_rounds):
result = self.processor.process(contract_path, round_idx)
check = self.reporter.check(result)
if check.is_acceptable:
self.save_report(contract_path, result, check)
contract_path.rename(contract_path.with_suffix(".done"))
return
if self.processor.tokens_used > self.budget_tokens:
self.escalate_to_human(contract_path, "Token 超限")
return
self.escalate_to_human(contract_path, f"超过{self.max_rounds}轮未达成")8.3.2 Maker:合同处理
class ContractProcessor:
    def process(self, path: Path, round_idx: int) -> dict:
        # 1. 读取合同
        text = read_contract(path)
        # 2. 调用 Deep Agent
        result = deep_agent.invoke({
            "contract_text": text,
            "round": round_idx,
            "instruction": """
            请完成以下任务:
            1. 识别合同类型
            2. 提取关键字段(甲方、乙方、金额、期限、付款方式)
            3. 检查风险条款(异常金额、缺失签字、模糊条款)
            4. 输出 JSON 格式
            """
        })
        return result
8.3.3 Checker:结果检查
class ReportGenerator:
    def check(self, result: dict) -> CheckResult:
        # Maker / Checker 通信:只看 result,不看过程
        if not result.get("contract_type"):
            return CheckResult(False, "缺少合同类型")
        if not result.get("amount"):
            return CheckResult(False, "缺少金额")
        if result.get("risk_issues"):
            return CheckResult(False, "存在风险条款需人工 review")
        return CheckResult(True, "")
8.3.4 升级机制
def escalate_to_human(self, contract_path: Path, reason: str):
    send_email(
        to="[email protected]",
        subject=f"合同需人工处理: {contract_path.name}",
        body=f"原因: {reason}\n文件: {contract_path}"
    )
8.4 关键设计决策
8.4.1 为什么用"定时扫描 + 目标驱动"组合
- 定时扫描:业务事件(合同进入文件夹)是异步的,需要定期轮询
- 目标驱动:单份合同处理不是"一次对话",需要跑到"报告合格"为止
- 两者组合才完整
8.4.2 为什么用 Maker / Checker 而不是单 Agent
- 早期用单 Agent 时,常出现"自评 90 分但实际 60 分"的情况
- Maker / Checker 互相独立后,漏检率明显下降
- Checker 不读 Maker 过程,避免被"过程合理"误导
8.4.3 为什么把控制逻辑写在代码里而不是 Skill
- 这个 Loop 的循环次数、token 上限是硬约束,必须代码层强制
- 如果写在 Skill 里,模型可能"忘了"或"误判"
- 复杂的循环控制用代码,复杂的任务逻辑用 Skill——这是分工原则
8.5 落地步骤
把这个 Loop 投入生产的步骤:
- POC 阶段:先拿 10 份历史合同跑,确认输出质量
- 小流量:1 个业务线先用,人工 review 所有报告
- 扩量:多个业务线,逐步降低人工 review 比例
- 完全自动化:只在异常时通知人
- 持续优化:根据 review 反馈优化 Skill 与工具
8.6 常见踩坑
- 预算没设好 → 第一次跑就把一个月的 token 预算烧光
- 日志太简略 → 出问题时根本不知道 sub-agent 之间发生了什么
- Maker / Checker 通信用自然语言 → 解析失败率高,改用 JSON schema
- 没设 stop hook → 一次循环跑了一晚上
- 升级通知用邮件 → 半夜出问题没人看邮件
📌 这个案例的核心价值:它演示了"代码 + Skill + 工具"如何组合成一个生产级 Loop。实际项目可能更复杂,但分层思想是一致的。
第九章 开发者新角色与大模型技术全景
9.1 未来程序员的核心工作
Loop Engineering 时代,程序员的角色发生根本变化:
核心能力需求:
- 代码能力:工具与 Skill 仍需扎实编程能力
- 业务理解:把业务拆成"可循环"的子任务
- 架构设计:设计循环、sub-agent 协作、状态管理
- 成本意识:每个 Loop 都是"在烧钱",必须会算账
- 验证意识:不轻信 AI 输出,强制人工 review 关键节点
📌 程序员不会被 AI 替代,但会被"会用 AI 做 Loop Engineering 的程序员"替代。
9.2 训练系统(Training System)
未来程序员的日常工作之一——调 prompt / 调 Skill / 调边界。
典型场景:
- 发现某个 Skill 总是跑偏 → 改 Skill prompt
- 发现某个 sub-agent 经常 token 耗光 → 改它的边界
- 发现某个工具调用失败率上升 → 修工具或换模型
调参工具:
- 评测集(Eval Set):一组标准输入,验证每次改动是否让输出变好/变坏
- A/B 测试框架:同时跑两个版本,对比效果
- 监控面板:实时看每个 Loop 的成功率、token 消耗、延迟
9.3 大模型技术全景
整个大模型技术栈分三层:
9.3.1 工具层
Web Coding 工具:
- Claude Code、OpenAI Codex、Google Gemini Code Assist
- 特点:一上手就会,但缺乏体系化方法论
低代码平台:
- Coze、Dify、n8n、FastGPT、扣子(RPA)
- 特点:拖拽式搭建 Agent / 工作流
- 局限:复杂场景下"巧妇难为无米之炊"——没有对应工具/节点时必须自己开发
- 适用:个人开发者、简单业务场景
9.3.2 应用开发层
核心语言:Python(90%+ 公司使用)
核心框架:
- LangChain / LangGraph:Agent 与工作流开发的事实标准
- Deep Agent:LangChain 团队推出的 Harness Engineering 落地框架
- Claude Agent SDK:Anthropic 官方 SDK
- OpenAI Agent SDK:OpenAI 官方 SDK
核心能力:
- MCP 工具开发
- Agent 上下文 / 状态管理
- 多 Agent 开发
- Harness Engineering(Deep Agent)开发
- Skill 开发
- 私有化部署
为什么这是最重要的层:
企业做大模型开发,最看重的是应用开发能力。其他层是"基础",这一层是"核心"。
9.3.3 算法微调层
做什么:
- 行业大模型:用自己公司的数据微调开源模型
- LoRA 微调、蒸馏、0-1 训练
- 解决"通用模型在垂直领域表现差"的问题
市场趋势:
- 2025 年下半年到 2026 年,面试中算法微调的问题明显增多
- 不是每家公司都用得到,但是面试必问
- "会微调" = "懂得更深" = "拿到 offer"
9.3.4 三层的重要性排序
📌 学习建议:先掌握应用开发层(90% 的工作机会都在这里),再补算法微调(面试加分),工具层有时间再学。
9.4 面试准备建议
9.4.1 必掌握技能
- Python 熟练
- LangChain / LangGraph 至少一个项目
- Deep Agent 至少跑通 demo
- 写过至少 1 个完整的 Loop
9.4.2 加分技能
- 微调(LoRA、QLoRA)
- 私有化部署(vLLM、Ollama)
- MCP 工具开发
- 监控系统设计
9.4.3 简历建议
- 不要只写"会用 LangChain"
- 写"用 Deep Agent 实现了 X 业务的自动化 Loop,节省 Y 人天/周"
- 量化成果
9.5 行业趋势预测
9.5.1 短期(6 个月内)
- Loop 监控平台会出现——专门监控 Loop 运行的平台
- Loop 编排框架会出现——专门做 Loop 编排的可视化工具
- Claude Code、Codex、OpenAI Cloud 都会强化 Loop Engineering 能力
9.5.2 中期(1 年内)
- Loop 模板市场——类似"模板商店",开发者卖 Loop 模板
- Loop 评测平台——专门评测 Loop 效果的 SaaS
- Loop 工程师会成为独立岗位
9.5.3 长期(2 年+)
- Auto-Loop——AI 自己设计 Loop,开发者只描述业务
- Loop Marketplace——Loop 交易市场
- "开发即配置"——开发者的核心工作变成"配置 Loop 而不是写代码"
第十章 总结:Loop Engineering 时代
回到最初的问题——Loop Engineering 是什么?
它是一种范式,不是新框架。它告诉我们:
当 AI 能力、工具标准、上下文管理、独立验证机制四件事都成熟后,开发者的工作从"写 prompt 调 AI"变成"设计循环让 AI 自己完成工程"。
它的落地路径:
Harness Engineering(Deep Agent / Claude SDK)
        ↓ 提供安全运行的底座
Loop Engineering(在底座上设计业务循环)
        ↓ 内部使用
Prompt + Context Engineering(每次循环内的 prompt 与上下文)它对开发者的要求:
- 会用 Deep Agent / Claude SDK(现成框架)
- 能写业务工具与 Skill(核心工作量)
- 会设计 Maker / Checker 协作(Loop 内部架构)
- 懂成本控制(每个 Loop 都在烧钱)
- 保持独立判断(不轻信 AI 输出)
最重要的认知:
Loop Engineering 不会替代程序员,但会用 Loop Engineering 的程序员会替代不会用的人。
下一步建议:
- 找一个自己工作中的小任务(每天重复的)改造成 Loop
- 加监控、调预算、跑一周看效果
- 把经验沉淀成团队内部的 Loop 模板
Loop Engineering 不是未来,它已经是现在。