
给AI下一个荒诞的指令:以后说话不许用"当然"、"让我看看"、"我来帮你"这些废话。结果令所有人意外——技术准确度100%,token消耗直接砍掉四分之三,响应速度快了将近3倍。
这就是 JuliusBrussee/caveman,一个2026年4月才上线、但短短两个月已经斩获66,000多颗星的开源项目。它用一种看似无厘头的方式,戳破了一个关于AI效率的真相:我们以为说得越多AI就越懂,其实只是在白白烧钱。
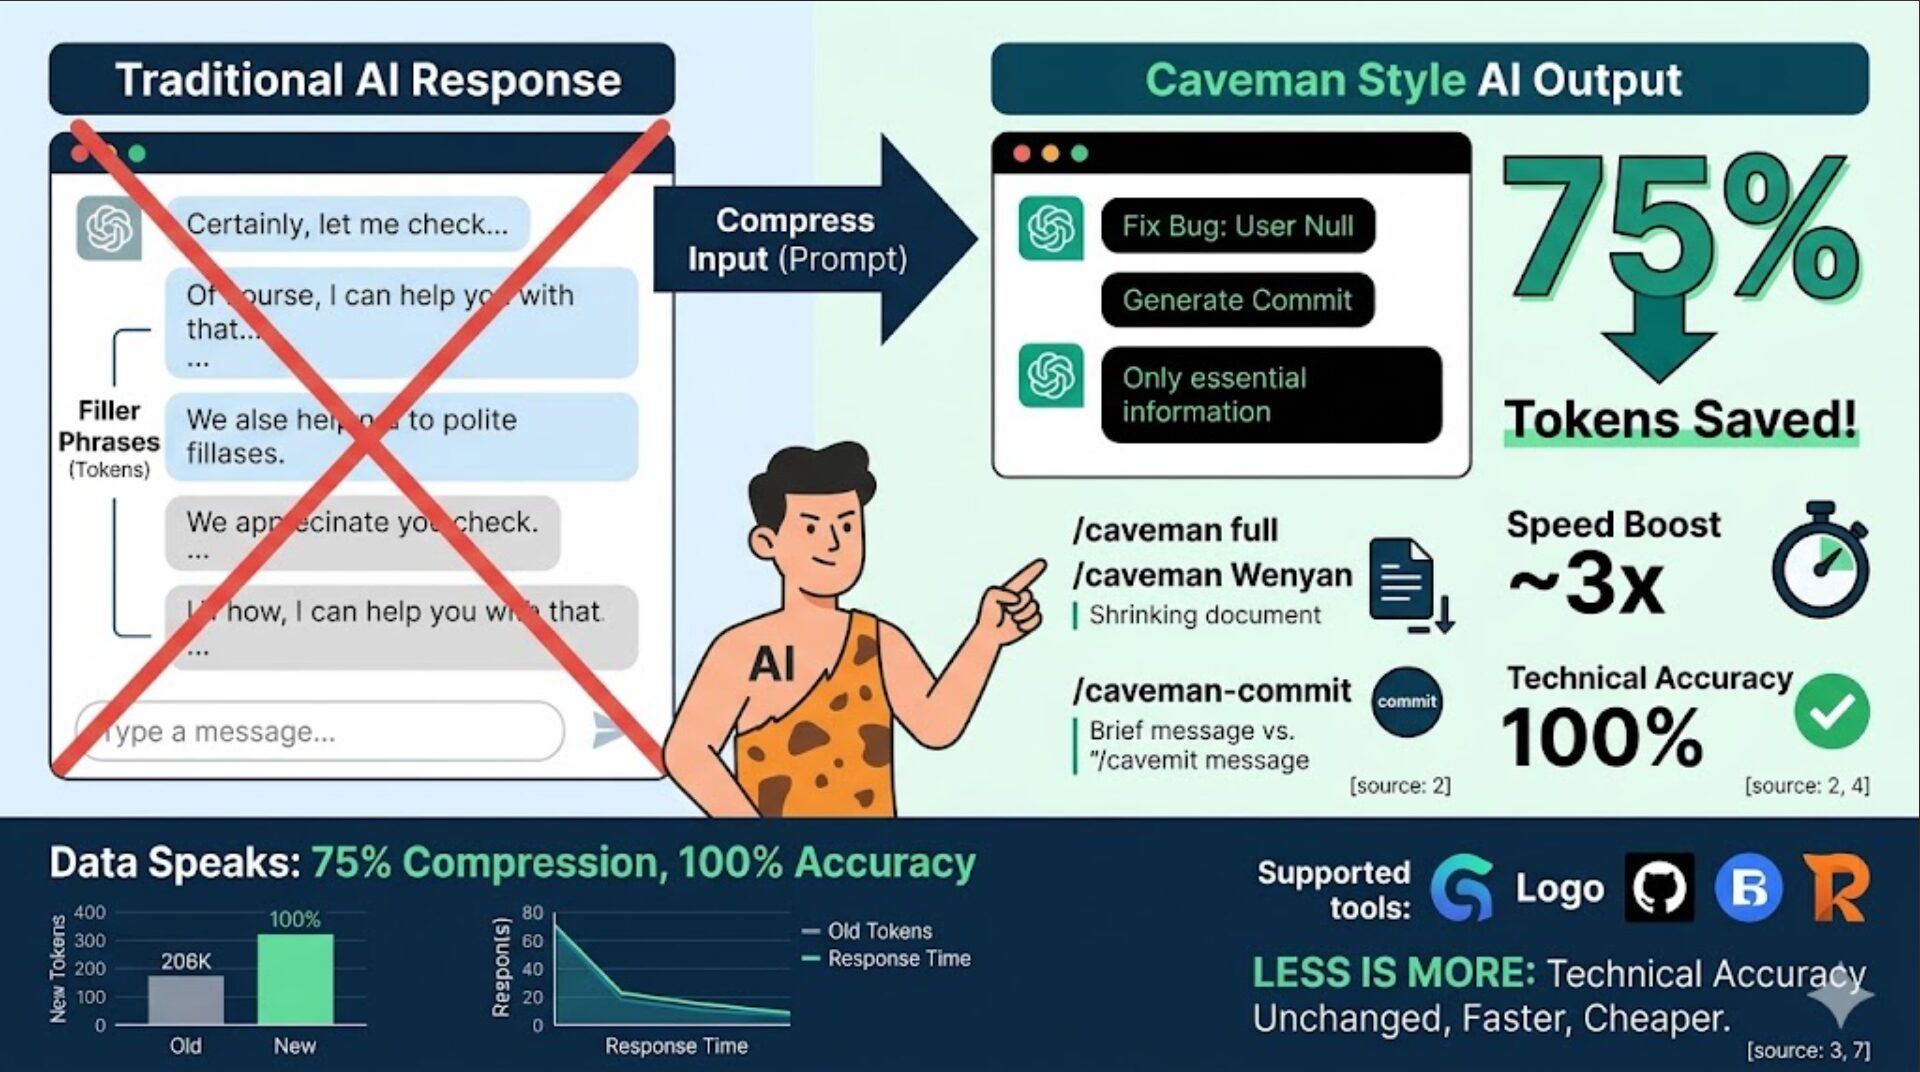
穴居人说话法,到底是什么
caveman的核心机制简单到有点好笑:你告诉AI"用穴居人风格回答",它就把所有礼貌性废话全部删掉,只留最核心的信息。听起来简单,但背后的数据很硬。
| 命令 | 功能 | 效果 |
|---|---|---|
| /caveman [lite|full|ultra|wenyan] | 压缩回复,4个等级 | 输出token减少75% |
| /caveman-commit | 生成commit message | ≤50字符,简洁明了 |
| /caveman-review | 单行PR评论 | 格式如 L42: bug: user null |
| /caveman-stats | 实时token统计 | 显示USD费用,可分享到Twitter |
| /caveman-compress | 压缩CLAUDE.md等文件 | 输入token减少46% |
安装方式也相当简单,一条命令搞定:
# macOS / Linux / WSL / Git Bash
curl -fsSL https://raw.githubusercontent.com/JuliusBrussee/caveman/main/install.sh | bash

# Windows (PowerShell 5.1+)
irm https://raw.githubusercontent.com/JuliusBrussee/caveman/main/install.ps1 | iex
支持30+款主流AI编码工具,包括Claude Code、Codex、Gemini、Cursor、Windsurf、Cline、Copilot等等。
数据说话:压缩75%,准确率依然是100%
这是最核心的问题:删掉废话,AI的回答还准吗?
| 指标 | 数据 |
|---|---|
| 输出token减少幅度 | 75%(69 tokens → 19 tokens) |
| 响应速度提升 | 约3倍 |
| 技术准确度 | 100% |
| CLAUDE.md压缩后输入token减少 | 46% |
| 子代理token减少 | 60% |
准确率维持在100%——这才是这个项目真正有价值的地方。删掉的全是"当然"、"我来帮你看看这个问题"、"让我分析一下"这类填充词,核心技术内容纹丝不动。
同类对比:caveman强在哪
| 特性 | caveman | promptfoo | Helix |
|---|---|---|---|
| 压缩方式 | 穴居人语言风格 | 结构化JSON | 规则压缩 |
| 压缩率 | 75% | 40% | 50% |
| 准确度 | 100% | 95% | 98% |
| 速度提升 | 3倍 | 1.5倍 | 2倍 |
| 实时token统计 | ✅ | ✅ 基础 | ❌ |
| 多agent支持 | 30+ | 仅Claude | 仅Helix |
| 开源 | ✅ MIT | ✅ | ❌ 闭源 |
为什么"穴居人说话法"真的有效
这个实验揭示了一个关于AI交互的真相:当我们要求AI"像一个穴居人一样说话",它学会了移除那些无实际意义的内容——礼貌性前缀、冗余解释、不必要的铺垫。
项目作者的核心观点是:token消耗中,有相当大一部分是"无效"的。这不是说AI在故意浪费资源,而是人类在交互习惯中默认添加了大量"社交润滑剂"。这些在日常对话中让对话更友好,但在高效工作流程中往往是多余的。
但要注意:压缩程度要看场景。代码审查可以极度压缩,创意写作需要轻度处理,复杂技术问题则需要谨慎——这时候保留适当的上下文反而更高效。
我们能从中学到什么
caveman目前是Claude Code的专用Skill,我们用OpenClaw,直接部署不适用。但"简洁表达"的思路完全可借鉴。
Token节省意识:
- 写prompt时去掉"当然可以"、"让我帮你分析"这类铺垫
- 定期压缩CLAUDE.md、AGENTS.md等文件,去除过时内容
- 知识库文档保持精简,避免大量填充词
"少即是多"原则:
- 技术回答保持"结论先行",避免过度铺垫
- 去掉"当然"、"我来帮你"、"让我看看"等填充词
- 技术准确度不变,只是表达更直接
什么时候适合用:
- 高频API调用——省下的是真金白银
- 重复性代码任务——commit message、PR review
- 多代理协作——子代理间传递的信息精简60%
什么时候不用:
- 创意写作——需要AI充分展开
- 复杂技术问题——保留上下文更重要
- 日常闲聊——友好氛围比效率更值钱
总结
caveman用荒诞的方式证明了一个正经结论:AI对话中"少即是多"不只是哲学,正确压缩可以带来75%的token节省,同时保持100%的技术准确度。
对我们最有价值的启发,不是去用这个特定项目,而是把"简洁表达"当成一种工作习惯——无论是写prompt、设计知识库,还是优化团队协作流程。每一句不必要的废话,都是在烧token。
GitHub地址:JuliusBrussee/caveman
*项目分析基于公开信息整理,实际使用效果因场景而异。