
2.2 万星的 GitHub 开源项目,C++ 源码级修改 Chromium,通过全部 30 项反爬检测。本文分析它到底有多强、适合谁用,以及为什么我们的电商团队最终选择借鉴而非直接部署。
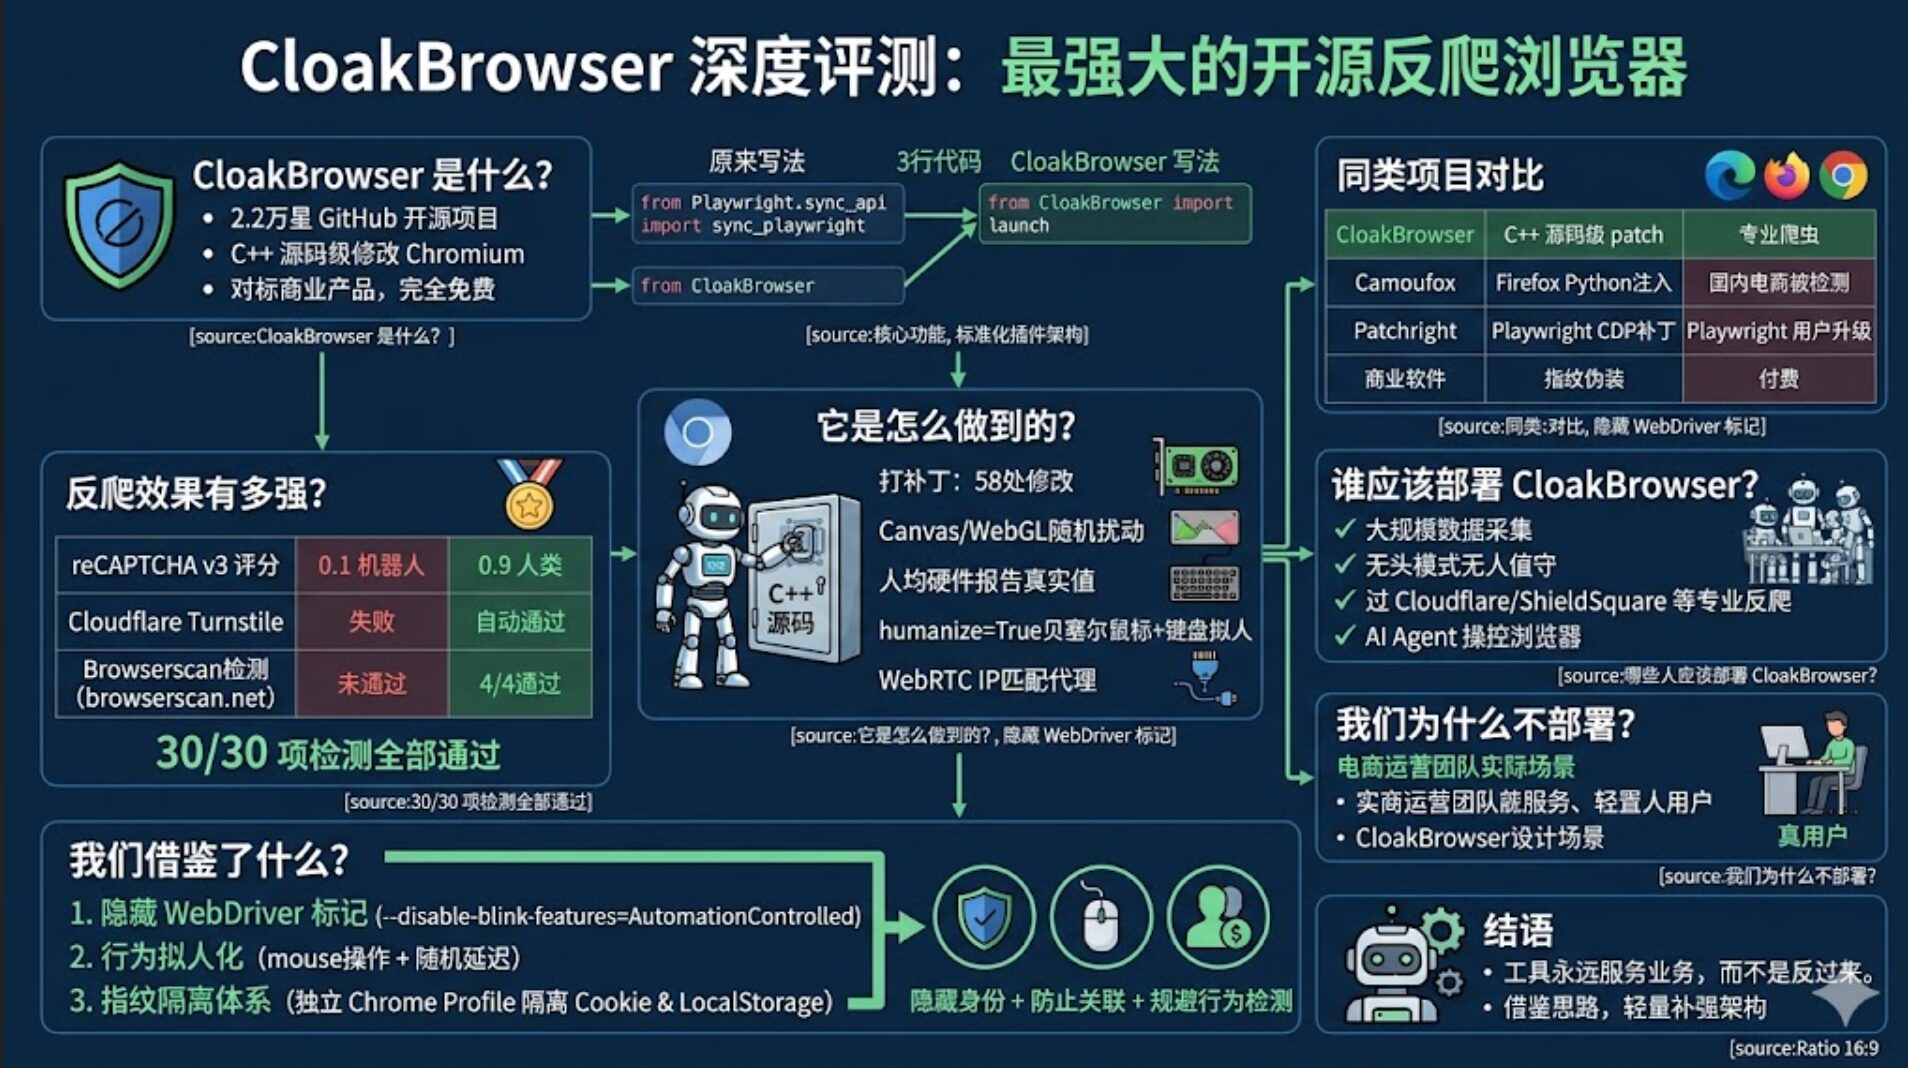
CloakBrowser 是什么?
CloakBrowser 是一个开源的「反检测浏览器」——它不是在 Chrome 外面包一层伪装,而是直接修改 Chromium 的 C++ 源代码(58 处补丁),重新编译出一个看起来和普通浏览器完全一样的定制版 Chromium。
与市面上常见的反爬方案不同,它和 Playwright API 完全兼容,只需 3 行代码就能无缝替换:
from playwright.sync_api import sync_playwright  # 原来的写法
browser = sync_playwright().start().chromium.launch()

from cloakbrowser import launch  # 现在的写法
browser = launch()它对标的是商业产品(Multilogin、GoLogin、AdsPower),但完全免费、开源(MIT 协议)。
反爬效果有多强?
在对 CloakBrowser 与原生 Playwright 进行的检测对比中,结果令人印象深刻:
| 检测服务 | 原生 Playwright | CloakBrowser | 说明 |
|---|---|---|---|
| reCAPTCHA v3 评分 | 0.1(机器人) | 0.9(人类) | 服务端验证,非本地伪造 |
| Cloudflare Turnstile | ❌ 失败 | ✅ 自动通过 | 无需点验证码 |
| FingerprintJS | ❌ 被检测 | ✅ 通过 | demo.fingerprint.com |
| BrowserScan (4项检测) | ❌ 未通过 | ✅ 4/4 通过 | browserscan.net |
| navigator.webdriver | true | false | C++ 源码级消除 |
| TLS 指纹 (JA3/JA4) | 与 Chrome 不一致 | 完全一致 | 网络层不可区分 |
| window.chrome 对象 | undefined | object | 与真实 Chrome 完全一致 |
30/30 项检测全部通过——这不是 JS 注入或者配置魔改能做到的。
它是怎么做到的?
大多数反爬工具(如 playwright-stealth、undetected-chromedriver)在 JavaScript 或浏览器启动参数层面打补丁。问题在于:
- 反爬系统也在进化:越来越多的网站能检测出这些补丁本身
- Chrome 更新就失效:每个 Chrome 大版本更新都可能打破补丁
- JS 注入级修改无法覆盖底层指纹:Canvas、WebGL、音频指纹必须从 C++ 层修改
CloakBrowser 的思路完全不同——它从源码层面消除了「自动化痕迹」:
- Canvas/WebGL 指纹:C++ 渲染层加入随机扰动,模拟不同 GPU
- 硬件报告:屏幕分辨率、CPU 核心数、内存大小等报告为真实值
- WebRTC IP:自动匹配代理出口 IP,防止真实 IP 泄漏
- CDP 输入行为:
Input.dispatchMouseEvent产生的事件看起来像真实鼠标 - humanize=True:一条参数启用贝塞尔曲线鼠标轨迹 + 逐字符键盘输入 + 真实滚动模式
可以说,CloakBrowser 不是在「伪装」成浏览器——它就是一个正常的浏览器,只是你没有手动操作它。
同类项目对比
| 项目 | ⭐ | 引擎 | 反爬层级 | 适用场景 |
|---|---|---|---|---|
| CloakBrowser | 21.9k | Chromium | C++ 源码级 58 处补丁 | 专业爬虫、自动化测试 |
| Camoufox | 8.8k | Firefox | Python 注入指纹 | 通用反爬,但 Firefox 在国内电商被重点检测 |
| Patchright | 3.3k | Chromium | CDP 补丁 + JS 注入 | Playwright 用户的轻量升级 |
| AdsPower | 商业 | Chromium | Profile 管理 + 指纹伪装 | 多账号运营(付费) |
Camoufox 基于 Firefox,理论上效果不错,但国内电商平台对 Firefox 的检测极为严格(淘宝页面甚至在 Firefox 上直接弹安全警告),基本不可用。
Patchright 是 Playwright 的 fork 版,在 CDP 层做补丁。优点是改动小、迁移成本低,但 JS 注入级别的伪装在淘宝每次前端更新后都可能失效。
CloakBrowser 的核心优势是 C++ 源码级修改:只要 Chromium 内核不升级新的检测手段,所有补丁都持续有效。
哪些人应该部署 CloakBrowser?
如果你的场景符合以下任一条件,强烈建议考虑:
- 大规模数据采集:每日需要获取几百甚至上千个页面的数据
- 无头模式运行:服务器端无人值守,必须靠浏览器伪装通过检测
- 需要过 Cloudflare/ShieldSquare 等专业反爬:JS 注入方案基本无效
- 使用 AI Agent 操控浏览器:如 browser-use、Crawl4AI 等框架,CloakBrowser 可即插即用
- 已有住宅代理 IP 但浏览器指纹暴露:CloakBrowser 的指纹随机化能补齐最后一块短板
不适合的情况:只是偶尔手动操作、已有真实登录态的浏览器、数据需求不大(< 20 页/次)。
我们为什么不部署?
我们的团队做电商运营,需要经常登录淘宝/天猫卖家后台查看数据。但我们的使用场景和 CloakBrowser 的设计场景有本质区别:
| CloakBrowser 设计的场景 | 我们的实际场景 |
|---|---|
| 无头模式批量抓取 | 真实 Chrome 窗口 + 手操为主 |
| 无登录态、裸奔访问 | 已登录的真实账号 Cookie |
| 数据中心 IP 池轮换 | 真实家庭/办公 IP |
| 骗过所有反爬检测 | 正常浏览器本身就不会触发反爬 |
我们的多店铺 Chrome 架构本质上是真实用户的真实浏览器——有真实 Cookie、真实 IP、真实登录态。淘宝没有理由把它当成爬虫。
真正会触发反爬的,不是「用了哪个浏览器」,而是「用浏览器做了什么事」。我们的自动化操作量很小(偶尔翻几页、点几个按钮),远达不到触发行为分析的门槛。
我们借鉴了什么?
虽然不直接部署,但 CloakBrowser 的思路给了我们三点重要启示,并已落地:
1. 隐藏 WebDriver 标记
淘宝检测自动化浏览器的第一关就是 navigator.webdriver === true。我们在每个店铺 Chrome 的启动参数中加入了:
--disable-blink-features=AutomationControlled这会将 navigator.webdriver 从 true 强制设为 false,消除了最明显的自动化痕迹。
2. 行为拟人化
CloakBrowser 的 humanize=True 本质是「让自动化操作看起来像人」。我们制定了操作规范:
- 每步操作间隔 200-800ms 随机延迟(不是连续毫秒级操作)
- 鼠标操作优先使用
page.mouse(OS 级事件),而非 CDPInput.dispatchMouseEvent(被淘宝行为分析重点监控) - 单次会话连续操作 不超过 10 步,中间休息 5-10 秒
3. 指纹隔离体系
CloakBrowser 每次启动随机生成指纹。我们的多店铺架构天然实现了这一点:每个店铺使用独立的 Chrome Profile 目录,Cookie、LocalStorage、浏览器指纹完全隔离,淘宝无法跨店铺关联账号。
三者协同效果:
--disable-blink-features=AutomationControlled→ 隐藏身份- 独立 Profile 指纹隔离 → 防止关联
- 拟人化操作规范 → 规避行为检测
对于我们的「真账号 + 真浏览器 + 少量自动化」场景,这套组合已经足够了。
写在最后
CloakBrowser 是一个技术上极其出色的项目——C++ 源码级修改 Chromium 的做法,远超市面上所有 JS 注入方案。如果你有大规模数据采集需求,它是目前最好的开源选择。
但技术的价值在于匹配场景。我们的核心场景是「真人在真实浏览器上操作,偶尔用自动化提效」,而非「用机器人批量抓数据」。这种情况下,借鉴 CloakBrowser 的思路、用最轻量的方式补强现有架构,比直接替换整个浏览器栈更合适。
工具永远服务业务,而不是反过来。
项目地址:https://github.com/CloakHQ/CloakBrowser