
在 AI 智能体快速发展的今天,数据无处不在,但高质量的上下文却成为了制约智能体能力的核心瓶颈。传统的 RAG 方案存在上下文碎片化、检索效果差、不可观测等诸多问题,让开发者在构建长时运行、复杂任务的智能体时举步维艰。
火山引擎最新开源的 OpenViking 项目,正是为了解决这些痛点而生。它不是一个简单的记忆系统,而是一个专为 AI 智能体设计的 上下文数据库,通过创新的文件系统范式,统一管理智能体所需的记忆、资源和技能,为智能体提供了一个高效、可观测、可迭代的"大脑"。
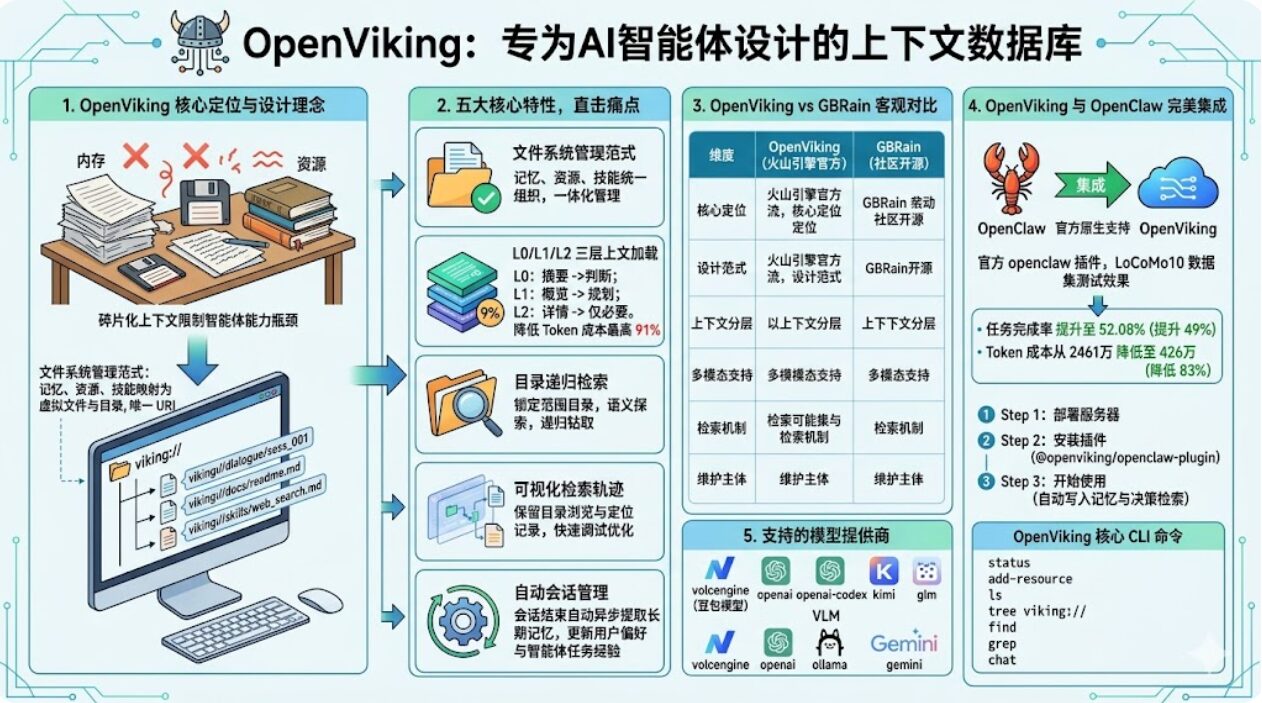
一、OpenViking 核心定位与设计理念
OpenViking 摒弃了传统 RAG 碎片化的向量存储模型,创新性地采用 文件系统范式 来组织所有上下文。它将智能体需要的一切信息 —— 无论是用户对话记忆、项目文档资源,还是智能体自身的技能和任务经验 —— 都映射为 viking:// 协议下的虚拟文件和目录,每个条目都有唯一的 URI 地址。
这种设计带来了革命性的变化:开发者管理智能体的上下文,就像管理自己电脑上的文件一样简单直观。你可以用 ls 列出资源,用 tree 查看目录结构,用 find 进行语义检索,用 grep 进行关键词搜索。上下文管理从模糊的语义匹配,变成了精确、可追踪、可调试的"文件操作"。
二、五大核心特性,直击智能体开发痛点
OpenViking 针对智能体开发中最常见的五大痛点,提供了完整的解决方案:
1. 文件系统管理范式:解决上下文碎片化
传统智能体开发中,记忆散落在代码里,资源存在向量库中,技能分散在各个模块,难以统一管理。OpenViking 通过虚拟文件系统,将记忆、资源、技能统一组织在一个层级结构中,实现了真正的一体化上下文管理。
2. L0/L1/L2 三层上下文加载:大幅降低 Token 消耗
将所有上下文一股脑塞进提示词不仅昂贵,还容易超出模型窗口并引入噪声。OpenViking 会自动将每个上下文处理为三层:
- L0(摘要层):一句话摘要,用于快速判断相关性
- L1(概览层):包含核心信息和使用场景,供智能体规划阶段决策
- L2(详情层):完整原始数据,仅在绝对必要时才加载
这种按需加载的机制,在官方测试中实现了最高 91% 的 Token 成本降低。
3. 目录递归检索:提升检索全局准确性
单一的向量检索往往只能找到语义相似的碎片,却无法理解信息的完整上下文。OpenViking 采用了创新的目录递归检索策略:
- 先通过向量检索快速定位高分目录
- 在该目录内进行二次精细检索
- 递归钻取子目录,逐层探索
- 最后聚合所有相关结果
这种"先锁定范围,再精细探索"的方式,让检索结果不仅准确,而且具有全局上下文。
4. 可视化检索轨迹:让上下文不再是黑盒
传统 RAG 的检索过程是一个黑盒,出错时很难定位问题。OpenViking 完整保留了每次检索的目录浏览和文件定位轨迹,开发者可以清晰地看到智能体"看了什么"、"为什么看这些",从而快速调试和优化检索逻辑。
5. 自动会话管理:让智能体越用越聪明
OpenViking 内置了记忆自迭代机制。每次会话结束后,系统会自动分析任务执行结果和用户反馈,异步提取长期记忆并更新到对应的目录中:
- 更新用户偏好记忆,让回复更贴合用户需求
- 积累智能体任务经验,提升后续决策效率
真正实现了智能体的自我进化。
三、OpenViking vs GBRain:客观对比
说明:OpenViking 官方文档中未提及 GBRain,以下对比仅基于两个项目的公开 GitHub 信息,供开发者选型参考。
四、OpenViking 与 OpenClaw 完美集成
OpenViking 官方原生支持 OpenClaw 智能体框架,并提供了专门的插件。官方在 LoCoMo10 长对话数据集上的测试结果令人惊艳:
- 任务完成率从原生 OpenClaw 的 35.65% 提升至 52.08%(提升 49%)
- 输入 Token 成本从 2461 万 降低至 426 万(降低 83%)
前置条件
- Python 3.10 或更高版本
- Rust 工具链(Cargo,用于构建核心组件)
- C++ 编译器:GCC 9+ 或 Clang 11+
- 操作系统:Linux、macOS、Windows
- 稳定的网络连接
第一步:部署 OpenViking 服务器
# 安装 Python 包(官方推荐)
pip install openviking --upgrade --force-reinstall

# 安装 Rust CLI(推荐)
npm i -g @openviking/cli

# 交互式配置向导
openviking-server init

# 验证配置
openviking-server doctor

# 启动服务器
openviking-server
服务器默认运行在 1933 端口。
第二步:安装 OpenClaw 官方插件
⚠️ 官方特别提醒:不要使用 clawhub install openviking,这会安装一个完全不同的 AgentSkill,而不是上下文数据库插件。
正确的安装流程:
# 安装 OpenViking OpenClaw 插件
openclaw plugins install @openviking/openclaw-plugin

# 配置插件连接到你的 OpenViking 服务器
openclaw openviking setup \
  --base-url http://localhost:1933 \
  --api-key your-openviking-api-key \
  --json

# 重启 OpenClaw 网关使配置生效
openclaw gateway restart

# 验证插件状态
openclaw openviking status --json
第三步:开始使用
插件安装完成后,一切都会自动进行:
- OpenClaw 会自动将所有对话历史、任务结果和感知数据写入 OpenViking
- 每次决策前,自动从 OpenViking 检索相关上下文
- 会话结束后,自动提取长期记忆并更新
开发者无需修改任何 OpenClaw 核心代码,即可获得强大的上下文管理能力。
OpenViking 核心 CLI 命令
# 查看服务器状态
ov status

# 添加资源(支持GitHub仓库、网页、本地文件)
ov add-resource https://github.com/volcengine/OpenViking

# 列出所有资源
ov ls viking://resources/

# 查看目录树
ov tree viking://resources/volcengine -L 2

# 语义检索
ov find "what is openviking"

# 关键词检索
ov grep "openviking" --uri viking://resources/volcengine/OpenViking/docs/zh

# 启动交互式聊天
ov chat
五、支持的模型提供商
VLM 模型
volcengine:火山引擎豆包模型(官方推荐)openai:OpenAI 官方 APIopenai-codex:通过 ChatGPT/Codex OAuth 调用kimi:Kimi 编码订阅版glm:智谱 AI 编码计划
Embedding 模型
支持 volcengine、openai、azure、jina、ollama、voyage、dashscope、minimax、cohere、vikingdb、gemini、litellm 和 local 等多种提供商。
六、部署注意事项
- 配置文件:默认位于
~/.openviking/ov.conf,可通过OPENVIKING_CONFIG_FILE环境变量指定其他路径 - CLI 配置:默认位于
~/.openviking/ovcli.conf,可通过OPENVIKING_CLI_CONFIG_FILE环境变量指定 - Docker 部署:官方提供 Docker 镜像,已预装 VikingBot,默认随服务器一起启动
- 生产环境:官方推荐在火山引擎 ECS 上使用 veLinux 操作系统
- Helm Chart:项目代码库中包含
deploy/helm目录,但官方 README 中暂未提供详细的部署说明
七、总结
OpenViking 重新定义了 AI 智能体的上下文管理方式。它通过文件系统范式,将原本复杂、碎片化、不可观测的上下文管理,变成了简单、统一、可调试的标准操作。
对于正在构建复杂 AI 智能体的开发者来说,OpenViking 不仅能大幅提升智能体的任务完成率,还能显著降低 Token 成本,同时让整个系统更加透明和可维护。如果你正在被智能体的"失忆"问题困扰,或者觉得传统 RAG 方案不够好用,那么 OpenViking 绝对值得一试。
项目地址:https://github.com/volcengine/OpenViking
八、补充
我们当前使用的知识管理和记忆管理体系架构,是 LLM wiki风格的Obsident+GBRain + 三层轻量记忆系统,与单纯的openviking对比如下:
对我们来说,没必要更换或者另外安装openviking,但对我们优化记忆系统,也有一定借鉴意义。比如:
当前我们的自动摘要机制是
# HEARTBEAT.md 要求每天:
## 每日复盘
### 今日完成
### 今日沉淀
借鉴openviking,我们就做了优化,给重要文档加上tl_dr字段:
---
tl_dr: "一句话总结本文核心结论"
level: L1  # 或 L0/L1/L2
---