
快速落地方法:
本文及本站大部分openclaw相关文章,都可以让Openclaw agent阅读,然后进行应用,参考Prompt如下:
分析有哪些内容,对我们优化工作流程有价值。并严格根据openclaw/Darwin-Skill最新官方文档进行核对,排除错误及过时信息,制定落地计划,安装和部署GBrain。
详细方法,参考文章 >>>
你是不是也有这样的困扰:读了很多书,合上书就忘得差不多;遇到问题时,明明记得某本书里讲过类似的方法,却怎么也想不起来具体怎么用;辛辛苦苦做的读书笔记,最后都躺在文件夹里落灰。
今天给大家分享一个我最近挖到的宝藏项目 ——cangjie-skill。它不是普通的读书软件,也不是 AI 摘要工具,而是一个能把任何高价值书籍的核心方法论,系统性转化为 AI Agent 可以直接调用的技能包的方法论框架。简单说,就是让你读过的每一本书,都变成一个随时能帮你解决问题的 AI 智囊。
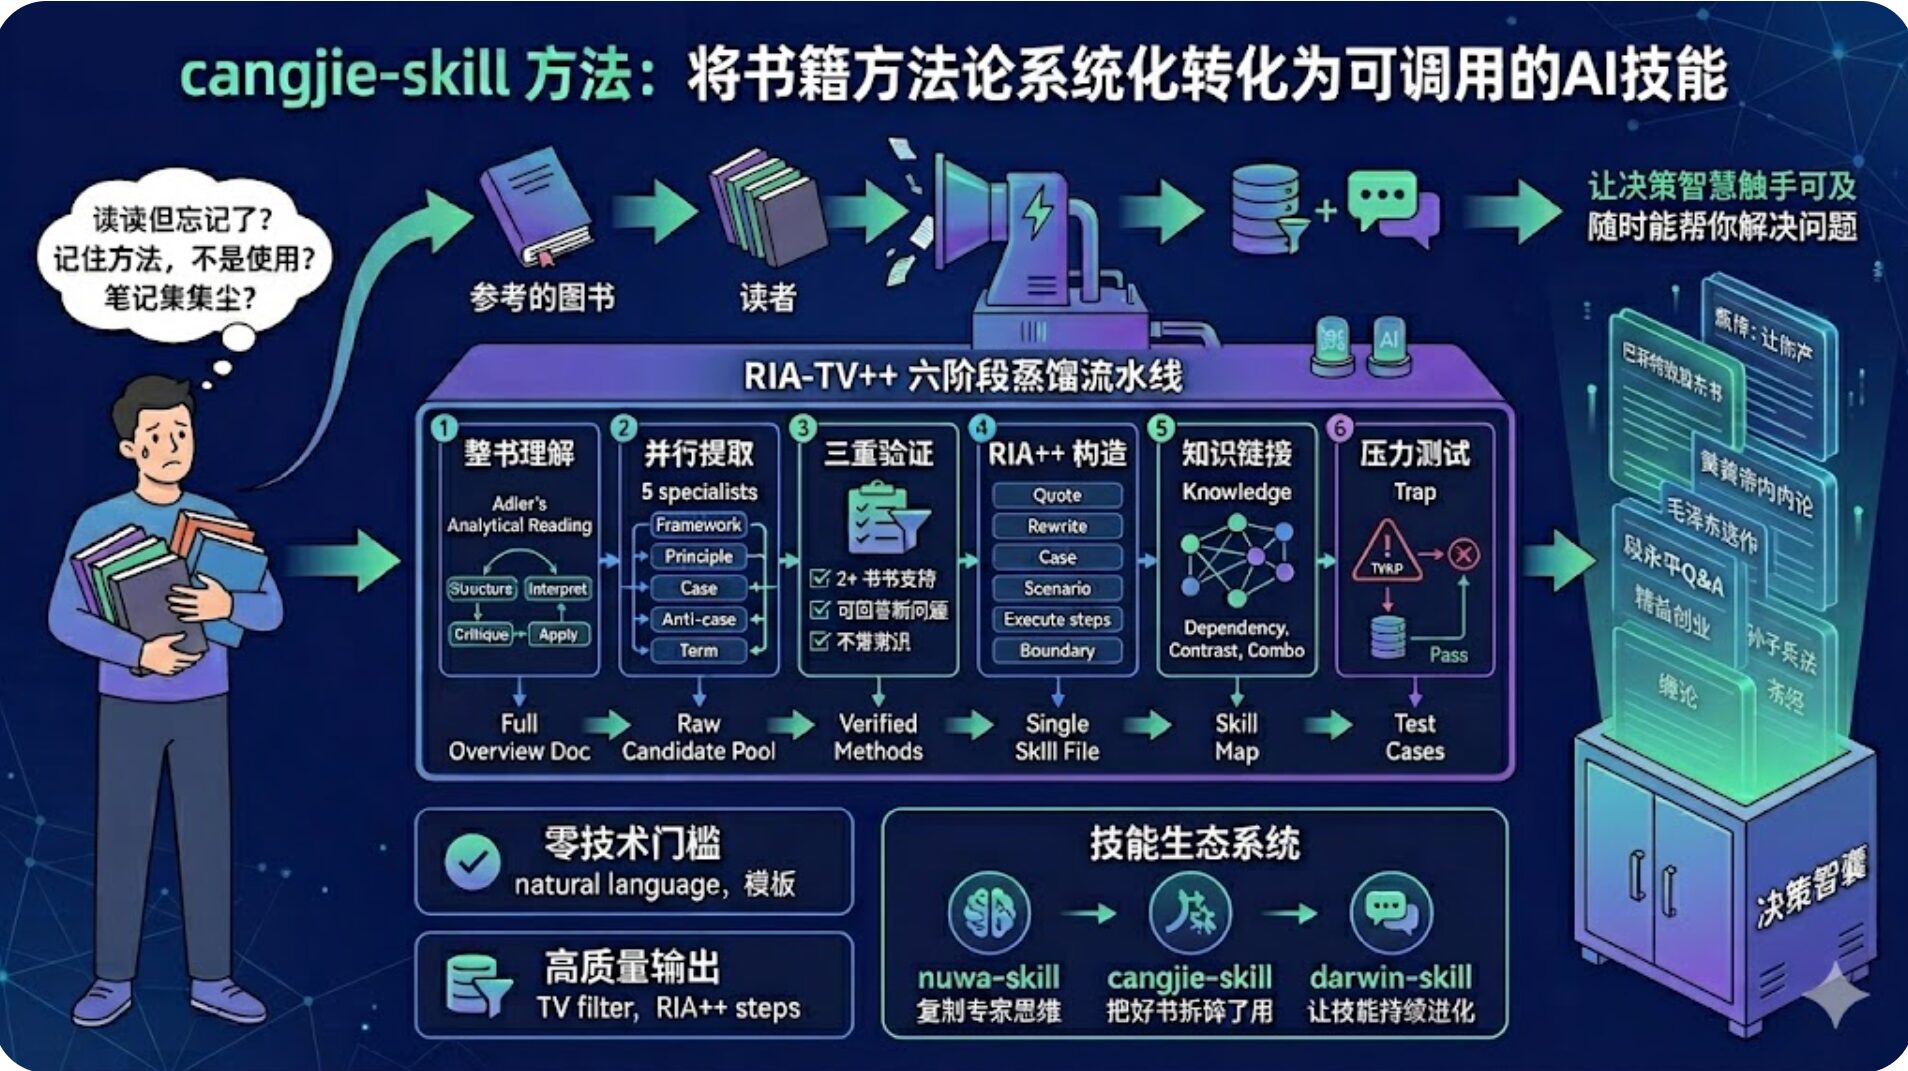
一、它到底解决了什么问题
很多人读书的痛点,本质上不是 "没读懂",而是 "不会用"。传统的读书笔记只是把书里的内容压缩了一下,还是给人看的,不是给 AI 用的。当你需要解决具体问题时,AI 没法从你的零散笔记里精准提取出对应的方法论。
cangjie-skill 就是为了解决这个问题而生的。它的目标很明确:把每一本高价值的书,都变成一套可独立调用、可组合使用、可压力测试的 AI 技能工具包。让 AI 能在你需要的时候,自动调用书里的方法帮你做决策。
二、核心原理:RIA-TV++ 六阶段蒸馏流水线
这是整个项目最精华的部分。cangjie-skill 没有用什么复杂的代码,而是基于一套非常严谨的方法论,通过纯 Prompt 的方式,引导大模型完成书籍的蒸馏过程。整个流程分为六个阶段,环环相扣,缺一不可。
这个流程之所以叫 RIA-TV++,是因为它融合了赵周的便签拆书法(RIA)、三重验证机制(TV),还专门为 AI 执行增加了可执行步骤和边界条件(++)。
三、它的优势和不足
为什么我推荐你试试
- 零技术门槛:全程都是自然语言交互,不需要写一行代码,任何人都能上手
- 方法论足够严谨:基于成熟的阅读和学习理论,不是拍脑袋想出来的
- 输出质量高:三重验证机制过滤掉了大部分没用的内容,留下来的都是真正能解决问题的方法
- 可复用性强:提供了标准化的模板,你可以用它蒸馏任何领域的书
- 生态完整:和另外两个项目形成了完美的闭环,从蒸馏到使用再到进化,一条龙服务
它不是万能的
- 不是一键工具:需要你跟着流程一步步引导 AI,不能扔一本书进去就等着出结果
- 比较耗时:完整蒸馏一本书,通常需要几个小时到几天的时间
- 依赖大模型能力:用 GPT-4 和用普通模型,出来的效果天差地别
- 没有可视化:目前只能输出文本格式的技能包,没有知识图谱之类的可视化功能
- 没有一键安装:还没发布到官方技能商店,需要手动克隆仓库
四、完整的技能生态系统
cangjie-skill 不是一个孤立的项目,它是一个更大的 AI 技能生态的一部分。三个核心项目紧密配合,形成了 "蒸馏 – 使用 – 进化" 的完整闭环。
简单说就是:nuwa 帮你把牛人 "复制" 下来,cangjie 帮你把好书 "拆碎" 了用,darwin 则让这些技能越用越好。
五、已经有哪些现成的技能包
目前作者已经用这套方法,蒸馏了 14 本经典书籍,生成了超过 200 个可直接使用的 AI 技能。涵盖了投资、商业、文案、认知、管理等多个领域。
除此之外,还有来自社区贡献的《精益创业》《孙子兵法》《缠论》《茶经》等书籍的技能包。
六、在 OpenClaw 中的正确部署与使用
前置准备
- 已经安装好 OpenClaw 核心框架
- 有一个可用的大模型 API 密钥(推荐 GPT-4 或 Claude 3)
- 已经创建了你的 OpenClaw 工作区
安装步骤
因为这个技能还没有发布到 ClawHub,所以我们需要手动克隆仓库到正确的位置。
# 克隆仓库到你的OpenClaw工作区对应的技能目录
# 把[agent]替换成你自己的Agent名称
git clone https://github.com/kangarooking/cangjie-skill.git ~/.openclaw/workspace/[agent]/skills/book2skill注意:这个技能的真实 ID 是book2skill,cangjie-skill只是仓库的名字。OpenClaw 会自动扫描工作区skills目录下的所有SKILL.md文件,不需要在任何配置文件里手动注册。
验证安装
# 进入你的OpenClaw工作区
cd ~/.openclaw/workspace/[agent]

# 查看所有已加载的技能
openclaw skills list如果输出里能看到book2skill,就说明安装成功了。
如何使用
book2skill是一个 "元技能"—— 也就是用来生成其他技能的技能。它不会直接帮你蒸馏完一本书,而是会一步步引导你完成整个 RIA-TV++ 流程。
在 OpenClaw 中输入下面的指令,就可以开始蒸馏一本书了:
使用book2skill帮我蒸馏《[你要蒸馏的书名]》,严格按照RIA-TV++六阶段流水线生成完整的技能包。然后跟着 AI 的引导,一步步完成六个阶段的工作。最后你会得到一个完整的技能包仓库,包含全书概览、技能地图、各个独立的技能文件,以及用来测试的用例集。
七、我的实践——借鉴 RIA-TV++ 改造知识体系
仔细研究了book2skill技能之后,我发现直接照搬它的形式并不适合我们。
为什么没有直接用?
原因很现实:他们用 skill 包来解决"AI 能不能调用"的问题,但我们已经有了 Obsidian 和 GBrain。GBrain 能做语义检索,Obsidian 能管理知识内容,再加一层 skill 包反而成了重复建设。14 本书 × 20 个 skill,意味着几百个文件要维护,而且 skill 之间的语义关联远不如 GBrain 的知识图谱清晰。
另一个原因是场景不同。他们的 skill 是给 AI Agent 调用的,我们的知识是给人 + AI 一起用的。性质不一样,解决方案自然也不一样。
借鉴了最有价值的部分
虽然没用它的形式,但 cangjie-skill 的核心理念值得借鉴。它把人读书的过程拆成了六个阶段(叫做 RIA-TV++):先理解整本书,再并行提取各个维度的知识点,然后三重验证确保内容靠谱,接着把这些碎片重新组装成结构化的知识模块,最后加上使用场景和边界条件。
最有价值的是最后两步:告诉 AI 在什么情况下该用这个知识,以及什么情况下不该用。这正是我们以前的知识库最缺的东西——存了很多笔记,但需要的时候想不起来怎么用。
怎么用到我们的系统里
我们的系统原本已经有"编译真相"和"时间轴"的结构,用来记录当前认知和认知的变化过程。这次升级,在每个知识条目里增加了三个新段落:
第一,触发场景。写清楚在什么情况下会用到这个知识。比如"当需要确定新品血压计的定价区间时"。
第二,可执行步骤。不是泛泛而谈,而是具体的 1-2-3 步操作指引。
第三,边界与盲点。这个知识适用于什么场景,什么情况下不适用,以及我们自己已知的局限。
同时在文件头部的 YAML 元数据里加了一个 trigger 字段,让 AI 在检索知识的时候能更准确地判断这个知识跟当前问题有没有关系。
改造的效果
升级刚完成,现在能看到的改变是:每个知识条目都有了明确的"出场条件"。以前是囤积,现在是 Ready to Use。
更深层的影响是知识入库的质量要求提高了。以前随手记的笔记往往只有观点没有边界,现在要写清楚"什么情况下用"和"什么情况下不用",逼着自己想清楚这个知识到底能解决什么问题。
预计三个月后,当知识库积累到一定规模,团队成员遇到问题时的第一反应会从"我记得某篇文章里讲过"变成"让我查一下知识库里对应的触发场景"。这个转变,才是真正有价值的地方。
八、写在最后
在这个信息爆炸的时代,我们缺的从来都不是知识,而是把知识转化为行动的能力。cangjie-skill 最打动我的地方,不是它有多先进的技术,而是它真正解决了 "知识无法落地" 这个痛点。
把一本书蒸馏成技能包的过程,其实也是你自己深度理解和内化知识的过程。最后你得到的不仅是一个能帮你解决问题的 AI 工具,更是一套真正属于你自己的方法论体系。
如果你也厌倦了 "读了很多书却依然过不好这一生" 的状态,不妨试试这个方法。让 AI 帮你把读过的书,真正变成你人生的护城河。