
同时在做三件事的人大概都熟悉这种感觉:给不同任务挑不同的模型厂商,每家的额度和配置文件各躺一份,谁快用完了一次要等报错才知道;想攒点自己的学习笔记,存到哪儿都不放心——放云端怕它替自己说话,放本地又只能一层层翻。
有一个项目专门收拾这两件事。左边是把各家模型和工具收进同一个本地入口,右边是把学习记录做成带证据回链的结构化记忆,而不是一段谁都不敢完全相信的"我记得你说过"。它叫 HKUDS/DeepTutor,香港大学一个实验室团队的公开作品。
下面把它拆开讲清楚:它到底由哪些东西构成、哪些设计值得单独拿出来看。
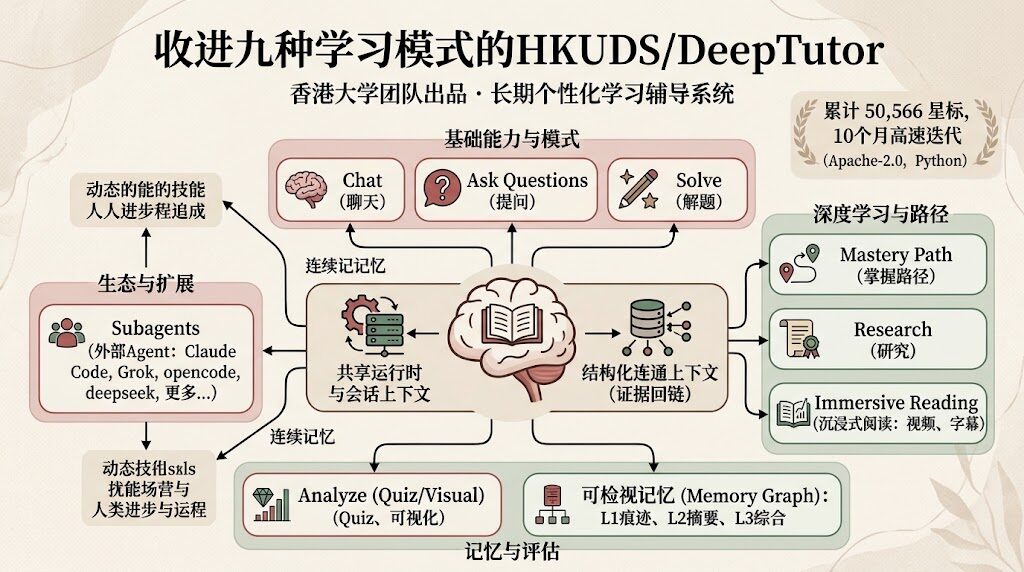
一、它是什么:一个把九种学习场景收进同一套运行时的项目
项目自述是 "DeepTutor: Lifelong Personalized Tutoring",文档站在 deeptutor.info。名字里的关键词是终身:它想做的不是一个能聊天的辅导页面,而是长期陪着你把学习过程本身管起来的系统。
野心体现在它收进来的东西有多杂:九种能力模式、知识库、书籍、题库、人格设定、记忆、外部 Agent、技能市场、命令行、可视化、音频概述。这些东西任意两个放在一起都够做一个独立产品,而它选择全塞进同一套能力运行时和同一个会话上下文里。
二、架构的关键判断:共享运行时,专属流水线
九个能力入口
Chat、Ask Questions、Quiz、Research、Visualize、Solve、Mastery Path、Immersive Reading、Audio Overview
这九个名字共享同一个能力运行时和同一个会话上下文,但各自保留专门的循环与流水线。它们不是九个互不相干的插件,而是九个跑在同一台机器上的能力入口。
它避开的两种失败模式
这个选择同时避开了两个常见坑。做成一堆互相独立的工具,状态、记忆和工具链会全线割裂;做成一个大而全的聊天框,每种场景的专属流程又被平均掉。它选的是中间那条路:运行时共享,流程分化。
Task Board:给人看的进度面板
面板支持 To do、In progress、Done 三态,每张卡片带备注,能拖拽,也能用键盘可达的移动按钮操作,归档后还能恢复。卡片留在当前工作区里,跟随既有的外观与语言设置,不需要任何模型配置。
这条设计值得单独看一眼:把"给人看的进度"和"给模型的能力"分开,减少了一整类不必要的耦合。
连通的学习上下文
知识库、书籍、Learning notebook 页面、收藏、题库、人格设定与记忆,都可以跨流程复用,前提是账号授权与学习策略允许。换句话说,你在一次会话里积累的东西,不需要在另一个模式里重新喂一遍。
三、沉浸式视频学习:把链接变成教材
原生播放与字幕检索
把 YouTube 或 Bilibili 的链接丢进 Reading,系统会落地成原生播放,而不是把视频外链甩出去。配套能力包括字幕检索、带时间戳锚定的辅导、可保存笔记与断点续播。
字幕与浏览可以走管理员配置的 Invidious 实例——这是给那些不想把请求直接交给默认上游的人留的口子。
四、Subagents 与 Partners:让外部 Agent 进场
十个可调用的 Agent harness
Claude Code、Codex、Grok CLI、Antigravity、Kimi、opencode、MiMo、Hermes、OpenClaw、DeepSeek
在 Chat 里可以直接叫起这些 Agent harness,也可以叫起一个 Partner。历史会话能导入进来,IM 伙伴还能常驻在同一个"大脑"上。
导入历史会话与常驻伙伴
导入历史会话、按需编排角色、伙伴各自持有私有会话且带可链接的聊天账号——这几件事叠加起来,意味着这个项目想当的是中枢,不是又一个孤立的聊天壳。
五、多引擎知识层:版本化的 RAG 库
十种知识后端
知识层横跨 LlamaIndex、PageIndex、GraphRAG、LightRAG、远端 LightRAG Server、自托管 WeKnora、腾讯 IMA 与 MarginNote 4 库、接入的 Kiwix ZIM 归档,以及直连的 Obsidian vault,文档解析器可插拔。
也就是说,它不要求你把笔记搬进某一个特定的数据库——已有的本地 Obsidian 仓库、腾讯 IMA 里的收藏、离线 Kiwix 归档,都能直接作为知识源接进来。
LightRAG 的独立角色模型
LightRAG 那条线还额外提供独立的抽取、查询与视觉角色模型设置,建库默认只建默认配置,重建则必须显式确认。
最后这半句是纪律:默认动作保守,破坏性动作需要确认。RAG 这类操作重建一次代价很高,"先问一句"比"自动帮你重建"更值得默认。
可插拔的文档解析
解析环节可插拔,配合不同格式的文档。相关的解析能力在版本记录里是逐步加进来的:多格式 MinerU、Apache Tika、多模态解析等。
六、可检视的记忆:三层加一张图
三层记忆各存什么
L1 痕迹保存原始执行轨迹,L2 表层摘要从轨迹里归纳出事实,L3 综合是跨表面的合成结论。
三层分开本身不算稀奇,真正关键的是它让个性化变得可见且可编辑——不是只能看结论,而是能一路点回去看这条结论是从哪次交互、哪条证据来的。
Memory Graph:把结论连回证据
Memory Graph 把 L2 事实连回 L1 证据,把 L3 综合连回贡献它的那批 L2 表面。任何一条"我记得你偏好深色主题"的判断,都能顺着这条链往回走。
这条设计把个性化从黑箱拉回到了可审计的状态。
记忆可以改,也可以清
除了查看,还有清理路径:L2/L3 记忆文档可以单独检查和清空,L1 与全部记忆也可以整体清掉。能在出错时把记忆归零,比"记忆永不衰减"实用得多。
七、命令行:同一套能力的两种入口
常用命令速览
deeptutor chat                                   # 交互式 REPL
deeptutor chat --capability deep_solve --kb my-kb
deeptutor run chat "Explain Fourier transform"
deeptutor run deep_solve "Solve x^2 = 4" --kb my-kb
deeptutor kb create my-kb --doc textbook.pdf
deeptutor memory show
deeptutor config show
一个二进制,两种用法:人用交互式 REPL,机器用 run 加参数。
NDJSON 事件流
给任意 run 加上 --format json,每一轮就会以 NDJSON 流出——一行一个事件(content、tool_call、tool_result、done 等),并且每一行都带着 session_id。
事件流可以逐行消费,而不是等一个完整 JSON 回来。对做任务编排、进度观测和回执记录的系统来说,这是现成的范式。
用 session_id 把会话串起来
SID=$(deeptutor run deep_research "Survey 2026 papers on RAG" \
  --config mode=report --config depth=standard --format json \
  | jq -r 'select(.type=="done").session_id')
deeptutor run deep_question "Quiz me on that survey" --session "$SID" --format json
先跑一次深度研究拿到会话 ID,再基于同一个会话出题:上下文没有丢。
没有终端时,问人一句会怎么结算
无人值守场景里,ask_user 遇到没有 TTY 的情况会自动以空回复结算,而不是把整条链路挂死。一个后台任务不该因为"想问人一句"就永远不结束——这条对任何调度型系统都适用。
八、技能生态:开放格式加多注册表
EduHub 作为默认市场
技能走开放的 Agent-Skills 格式:一个目录、一份 SKILL.md 说明书(YAML frontmatter 加 Markdown),外加可选参考文件。里面没有任何该项目专有的东西,所以任何讲这套格式的注册表都能成为技能源。
自带的 EduHub 是教育向市场,也是默认 hub:
deeptutor skill search "socratic tutor"        # 搜索默认 hub
deeptutor skill install socratic-tutor          # 拉取 → 校验 → 注册
deeptutor skill install eduhub:[email protected]   # 锁定 hub 与版本
deeptutor skill list                            # 本地技能及其来源
ClawHub 是一等公民
因为说的是开放格式,通用技能注册表也能直接当源:
deeptutor skill search "git release notes" --hub clawhub
deeptutor skill install clawhub:[email protected]
deeptutor skill install clawhub:udiedrichsen/stock-analysis
同名 slug 有多个发布者时,搜索会列出各自发布者,并给出带发布者前缀的完整安装引用。
注册表本身也能当外部技能源用
EduHub 同时是一个独立、兼容 ClawHub 的注册表,不是 DeepTutor 的附属品——别的 Agent(Claude Code、Codex 等)可以直接通过 eduhub 命令行安装:
npx eduhub install socratic-tutor新增注册表的配置方式
更多注册表写在 data/user/settings/skill_hubs.json:type: "clawhub" 指向任何兼容的 HTTP API,type: "command" 包一层注册表自带的取件命令行,"default" 指定裸 slug 走哪个 hub。所有注册表最终汇入同一道导入闸。
九、导入安全闸:把「不得自我提权」写进机制
无论技能来自哪个注册表,进工作区之前都要过同一道闸。
第一道:注册表的安全裁决
先查注册表给出的安全裁决,被标记的包默认拒绝,除非显式加 --allow-unverified。
第二道:防御式解包
解包时逐项检查路径穿越、条目数、体积、压缩比、后缀与符号链接;可执行位被剥掉,而无扩展名文件仍然放行。
第三道:把 always 字段剥掉
frontmatter 会被归一化到项目自己的 schema,并且 always: 字段被剥掉——一个下载来的技能,因此不可能把自己强塞进每次的系统提示。
这是整套机制里最关键的一条:它把"外部技能不得自我提权"从规范约定变成了代码强制。
第四道:来源信息落盘
provenance——hub、版本、安全裁决、安装时间——会写进 .hub-lock.json,供审计与更新。
多用户场景下的技能分层
浏览器导入落在已认证调用者的技能层,命令行与管理台安装落在 owner/admin 工作区;管理员的技能对普通用户默认隐藏且只读,直到显式授予。
十、安装与运行:四条路径加一条 Docker 试水线
统一的 runtime-home 布局
四条安装路径共享同一套布局:私有设置放在启动目录下的 data/user/settings/,也可以用 DEEPTUTOR_HOME 或 deeptutor start --home 显式指定。
推荐流程四步
选一个 runtime-home 目录 → 安装 → deeptutor init → deeptutor start。
命令行场景有轻量变体:deeptutor init --cli 共享同一套设置布局,但跳过前后端端口询问,仍然会让你选择 Embedding 与 Search(不需要时选 Skip)。
Docker 试水线
不想折腾 Python 或 Node 的话,有一条现成的路径:
docker run --rm --name deeptutor \
  -p 127.0.0.1:3782:3782 \
  -v deeptutor-data:/app/data \
  ghcr.io/hkuds/deeptutor:latest
打开 http://127.0.0.1:3782 ,在 Settings → Providers 里配置模型提供方,命名卷 deeptutor-data 会把设置和本地数据留下来给下次用。
让 Agent 替人装自己
README 里直接给了一段可以复制到终端型 Agent(Codex、Claude Code 等)的提示词:让它从 docs-for-dev/README.md 读起,接着读 AGENT_SETUP.md 与 SKILL.md,照着准备环境、配置模型提供方、验证、启动 Web 应用,最后交出访问地址和检查结果。
提示词里还特意写了一句:缺提供方、模型或凭据来源信息时询问用户,并且不要打印 API key。
Help me install and configure the current dev version of DeepTutor from https://github.com/HKUDS/DeepTutor.
Clone the dev branch, or inspect and reuse my existing checkout. Start at
docs-for-dev/README.md, then read docs-for-dev/AGENT_SETUP.md and SKILL.md.
Follow the setup guide to prepare the environment,
configure my model provider, verify the setup, and start the Web app.
Ask me for any missing provider, model, or credential-source information;
do not print API keys. Preserve my existing files and settings, and finish
with the access URL and the results of your checks.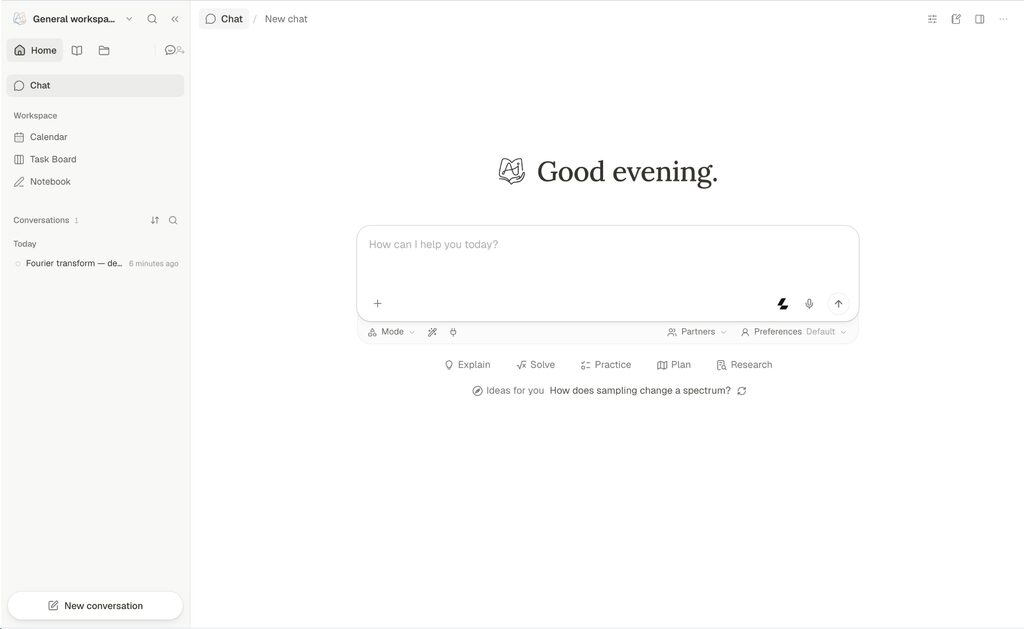
十一、隔离:内容工作区与私有运行时分开
两个目录各自的职责
内容工作区是 Agent 可读的文件夹,生成物落在 outputs/ 下按能力、会话、轮次分层;私有运行时则存放设置、凭据与记忆。两者是分开的概念,不是同一个目录的两个子集。
自定义工作区把会话、学习材料、进度与缓存隔离到一棵私有的 .deeptutor/data/ 目录树里,文件工具不能浏览;而设置、凭据与记忆仍然在账号级共享。
输出目录之外只读
在输出目录之外执行是只读的,把生成文件复制到工作区其他位置需要针对该源和目标做一次显式确认。有系统沙箱或 Docker 运行时,这条边界会被强制执行;本地受限子进程回退则标注为尽力而为。
十二、一个容易被忽略的细节
README 里提了一句:如果回答丢了早先的约束、引用了弱证据,或者与选定的材料不一致,请先按 docs-for-dev/REASONING_SAFETY_CHECKLIST.md 收集诊断信息,再开 issue。
把"答案质量退化"当成可收集的诊断信号,而不是直接甩一个问题出去——这个流程化的小设计,比一句"请描述问题"有价值得多。
十三、十点可借鉴之处
1. 结论必须带证据回链
长期结论只写"结论 + 偶尔一句话来源",时间一长就没人说得清它从哪来。补一条固定格式的证据指针,不需要换架构,写记忆时多带一个出处而已。
2. 外部内容必须过机制化安全闸
尤其是"导入时剥掉自动注入字段"这一条——把外部内容不得自我提权从规范约定变成代码强制,比靠人工审阅可靠得多。
3. 事件流用 NDJSON
一行一个事件、每行带会话 ID,进度可观测、可断点续读、可多消费者同时消费。
4. 无人值守的追问必须自动结算
没有终端时用空回复结算而不是挂死。任何后台任务都可能需要"问一句",这一条能直接消灭一整类静默超时。
5. 技能分发要可审计
带 hub 前缀和版本号的安装引用,加上锁文件记录来源信息,构成一套可审计的分发机制。
6. 状态面板与模型配置解耦
"给人看的进度"和"给模型的能力"分开,能砍掉一批不必要的耦合。
7. 把安装说明写成给 Agent 的说明书
配上清晰的入口文档与交接文档,比写给人看的说明更适合 AI 原生时代,也让"安装"这一步本身可以被自动化。
8. 答案质量退化要做成可收集的诊断项
"丢了早先约束 / 引用弱证据 / 与选定材料不符"这三条,可以直接进任何 Agent 系统的复盘清单。
9. 多后端 RAG 要可插拔
默认只建默认配置、重建必须显式确认——把破坏性操作默认挡在确认之后,是能直接抄的纪律。
10. 内容站点与私有运行时分家
Agent 可读的工作区与私有设置、凭据、记忆分离,文件工具看不到私有树。这条对任何要长期运行的 Agent 系统都是底线要求。
十四、结语
DeepTutor 值得看的地方不是"又一个大模型套壳",而是三件事:把九种学习场景收进一个共享运行时,是架构判断;把记忆做成带证据回链的可编辑图,是可解释性;把外部技能导入做成机制化安全闸,是工程纪律。
前两件是产品判断,第三件是最该立刻动手的那件。