
如果你每天都在跟 AI 编程工具打交道,这条账单值得你花三分钟看一眼。实测下来,最贵的不是"模型不够聪明",也不是"上下文太长",而是一件很反直觉的事:模型被调用的次数。这篇把一份真实账单拆到了最底层——哪部分钱花在了重复劳动上,哪部分是可以立刻回收的,以及一次把 5 小时额度烧穿的事故是怎么发生的。
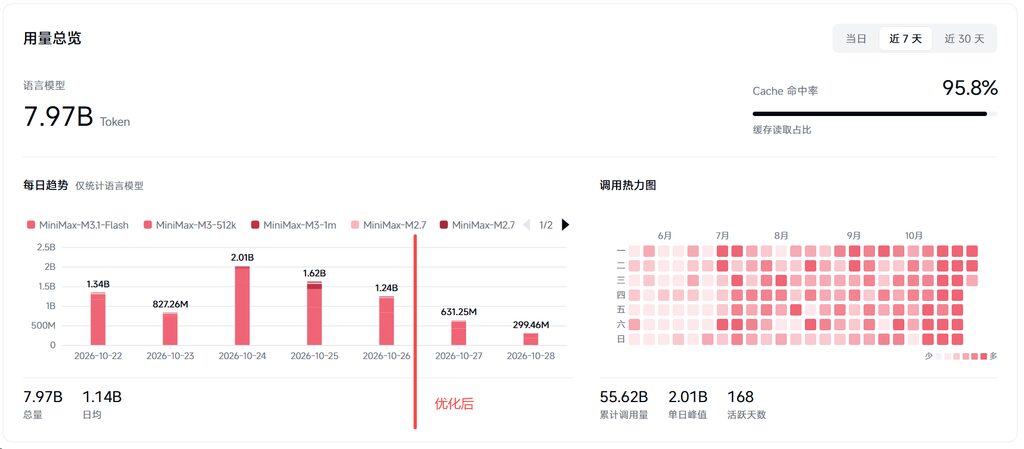
最近高强度使用 AI 编程助手:5小时的Max版token plan一般在几十分钟就会烧完。最高一天消耗了20亿token。额外购买积分,经常性一小时就烧掉200以上。这可还是定价比较低的国产大模型,已经相当肉疼了。
对问题进行了分析诊断后,才发现,绝大多数token都是没有产出的浪费。经过优化后,同样的工作量,token消耗降低了至少2/3。本文把我的经验教训分享出来,希望也能帮助你节约token支出。
统计口径:2026-09-29 至 2026-10-26,合计 27.6 天、182 个会话、897 轮对话、40,436 次 LLM 调用。
一页纸结论
| 结论 | 性质 |
|---|---|
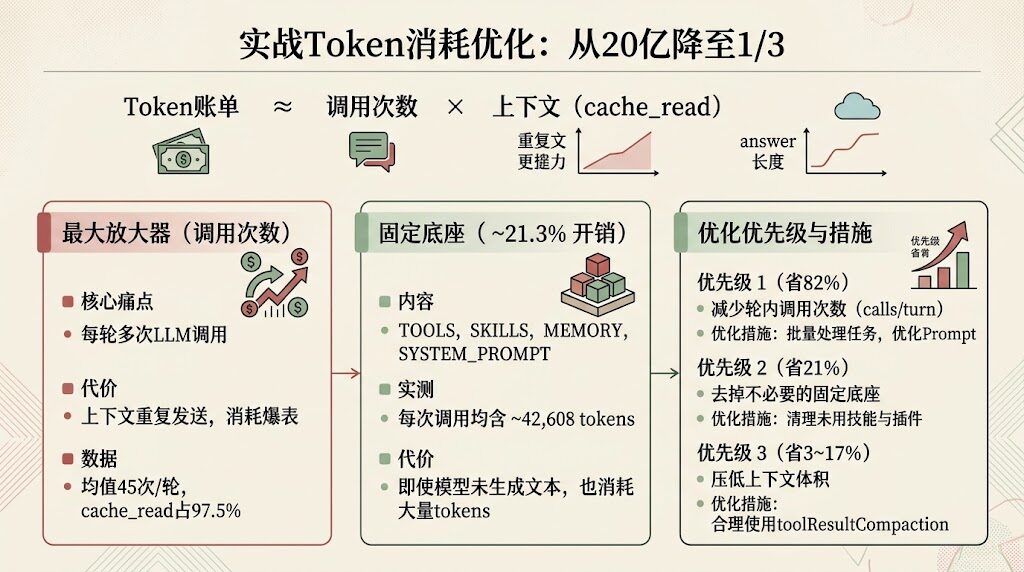
| Token 账单 ≈ 调用次数 × 每次上下文大小,与「回答有多长」几乎无关 | 【实测】 |
| 放大器是调用次数(37.2×),不是上下文膨胀(3.2%) | 【实测】 |
| 每次调用的固定底座 42,608 tokens(TOOLS/SKILLS/MEMORY/SYSTEM_PROMPT)占 21.3% | 【实测】 |
| 技能目录 149 条,27.6 天里只被显式调用 39 次(21 个技能) | 【实测】 |
| 「装了但没用」的可回收项合计约 10% 的历史总消耗 | 【实测+推断】 |
1. 总账
1.1 优化前后对比
| 维度 | 数值 |
|---|---|
| 优化前1周日均消耗 | 1.5B tokens |
| 最高 | 2B tokens / 天(明显恶化) |
| 每轮 LLM 调用次数 | p50 = 16、p75 = 45、p90 = 125、p99 = 393、max = 743、均值 45.1 |
【实测】在优化前,cache_read 占 97.5% 意味着:钱花在必须重复发送的上下文上,不是花在写出的文字上。
2. 决定性分解:放大器是「调用次数」
【实测】两个对照实验推翻了「上下文太大」这个直觉:
| 假设 | 推算结果 | 结论 |
|---|---|---|
| 每轮只调用 1 次 LLM | 0.22B(少 37.2×) | ✅ 真正的放大器 |
| 上下文在轮内完全不增长 | 只少 3.2% | ❌ 上下文膨胀不是主因 |
推论:省 token 的优先级是 ①减少调用次数 → ②压低每次调用的固定底座 → ③压低上下文体积。
| 措施 | 封顶节省 |
|---|---|
| calls/turn 压到 ≤10 | 省 82% |
| 去掉全部固定底座 | 省 21% |
| 上下文体积砍一半 | 省 3~17% |
3. 上下文成分解剖
【实测】22,682 条 context_usage 记录,按时间桶取均值:
| 成分 | 插件移除后 30min | 最近 24h | 前 7 天 | 前 20 天 |
|---|---|---|---|---|
| TOOLS | 26,491 | 26,539 | 19,494 | 22,505 |
| MESSAGES | 117,754 | 167,552 | 148,324 | 152,728 |
| MEMORY | 6,756 | 6,595 | 4,917 | 4,113 |
| SKILLS | 4,903 | 4,838 | 4,822 | 4,679 |
| SYSTEM_PROMPT | 4,458 | 4,436 | 3,634 | 3,822 |
| OTHER | 0 | 3,289 | 2,737 | 1,388 |
| 固定底座合计 | 42,608 | 44,408 | 40,867 | 39,948 |
固定底座 × 40,436 次调用 = 1.72B = 21.3% 的总消耗。
3.1 压缩的真实效果(常被高估)
【实测】压缩后上下文从 359k 降到 51k(14%),但那 51k 里 81.8% 是固定开销,工具结果只剩 ~9,257 tokens。 ⇒ 调 toolResultCompaction 的收益远小于想象,因为工具结果文本本来就小(p50 = 349B)。
4. 图片:610MB base64 钉在上下文里
4.1 图片是怎么计费的
【实测】507 张图 / 610.8MB base64 = 快照字节的 79.5%;405 张来自 read(均 1.48MB/张)。读图后 usedTokens 跳变 +6,318 ~ +26,042 ⇒ 按 image token 计费并永久驻留。
4.2 正确使用图片
不是不能使用图片/截图,一定要让大模型从图片中获取信息后,不再反复因读图而消耗token,这个非常重要!
5. 审计「装了但没用」:装了就花钱
| 对象 | 每次调用固定付出 | 是否「不调用就不付」 |
|---|---|---|
| 技能 | 目录行 – <name>: <description>,实测 SKILLS 分项 4,903 tokens/次(合计 198M ≈ 2.5%) | ✅ 正文是懒加载的 —— SKILL.md 只在 skill 工具被调用时载入。不调用不付正文钱,只付目录行那一行 |
| 工具 | 每个启用工具的完整 JSON schema,实测 TOOLS 分项 26,539 tokens/次(合计 1.07B ≈ 13.3%) | ❌ 没有「不调用就不付」的机制。schema 每次调用都全量发送 |
6. 优化方案
6.1 配置收紧 config.yaml
| 键 | 原值 | 新值 | 作用 |
|---|---|---|---|
| toolResultCompaction.maxInlineKiB | 64 | 32 | 工具结果更早落盘 |
| toolResultCompaction.mcpDetailsMaxInlineKiB | 32 | 16 | MCP 详情更早落盘 |
| toolResultCompaction.watermarkKiB | 256 | 64 | 压缩更早触发 ⇒ 图片更早离场 |
| toolResultCompaction.minSavingsKiB | 256 | 64 | 同上 |
| toolResultCompaction.keepRecentRounds | 5 | 2 | 保护的历史轮次更少 |
| requestMedia.image.maxwidth/maxheight | 2000 | 1280 | 图片 base64 更小 |
| contextManagement.compactionTriggerAt | (默认 95%) | 0.5 | 上下文到 50% 就压缩 |
6.2 三段 Hook 架构
UserPromptSubmit ─┬─ context_guard_hook  (≥70% 上下文时提示 /new)
                  └─ handoff_hook         (记录指令)
SessionStart ─────┬─ context_guard_hook
                  └─ handoff_hook         (注入铁律 + 交接卡)
PreToolUse ──────── tool_budget_hook       (调用预算:≥30 提醒,可硬 deny)
Stop ────────────── handoff_hook (自动写交接卡)【实测】tool_budget_hook 已在本会话第 30 次调用时真实触发。 【实测】handoff_hook 自测 14/14 通过;5MB 级 transcript 回归 148ms(只读文件尾部)。
6.3 状态外置「铁律」机制(L4)
三件套,每轮自动运行:
Stop事件 → 写maintenance/task-state/LATEST.md(目标 / 最近进展 / 涉及文件指针 / 下一会话须知)SessionStart事件 → 注入铁律 + 交接卡路径与摘要 ⇒ 新会话自动接力PreToolUse事件 → 调用预算硬护栏
关键设计:交接卡由 Stop 事件「持续刷新」,与 /new 的时机无关。 ⇒ 「/new 前要做什么才不中断任务」这个问题本身被消解了 —— 任何时刻切走,卡片都已是最新。
7. 问答附录
Q1 L4 状态外置如何自动化并形成铁律?
见 §6.3。三层结构:规则注入(SessionStart/UserPromptSubmit)→ 硬拦截(PreToolUse deny)→ 产物落盘(交接卡)。
Q2 使用 /new 前该做什么才不中断任务?
不需要做任何事(已验证:Stop 事件持续刷新卡片)。唯一注意:卡片里的「目标」取自最近一条指令,你刚改主意还没说出口的部分新会话看不到 —— 补一句即可强制刷新。
Q3 新会话可以接力任务吗?
可以。 SessionStart 自动把交接卡路径 + 摘要注入新会话第一轮上下文,Agent 会先读它再动手。 【实测】e2e 注入文本 = 铁律 3 条 + 卡片路径 + 卡片摘要。
Q4 /new 是原窗口继续还是必须用 +?
- 【实测】桌面端把
/new(及/clear)映射为动作new_chat;/compact→summarize;/fork= 复制成新会话且保留上下文(不减体积,别拿它当省 token 手段)。 - 【未验证】
new_chat在 UI 层是「当前窗口换一条会话」还是「并列开新窗口」——源码只给了动作名,界面表现未实测。 - 【实测】两者都会触发
SessionStart,接力都成立。要跟旧会话对照就用+。
Q5 图片读过后如何从上下文清掉?
自动压缩时 archiveImages() 会把图片换成文字收据,不需要手工清。
Q6 长会话压调用次数(非技术版)
把一次问答想成一场很长的会议。每翻一页资料,整本会议记录就要重新复印一份寄给记录员 —— 复印费就是 token。
- 会议越久,每页复印越贵(上下文变大)→ 小头。
- 真正的开销是记录员被打断的次数:你每追问一句、他每翻一次文件,整本记录重印一遍。被打断 100 次 = 复印 100 次整本。
所以第一招不是「少说话」,是「少打断」:
- 一句话把事说全,别挤牙膏式追问;
- 让他一次把清单拉完(一次 grep 拿全部,而不是一条一条试);
- 长表格、长日志让他写成文件,你只拿结论和路径;
- 截图、整段代码、大文件别反复贴;
- 事说清就让他做完,别做一半插话问「到哪了」。
经验值:一轮问答让他来回动手 10 次以内,比 100 次省约 8 成。
8. 总结
任何"一次对话 = 一次模型调用 + 一份固定上下文"的工具,都逃不开下面这三条:
- 固定底座是刚性的。
- 工具定义、系统提示、技能目录,无论你这一轮说了什么,都会被整份发出去。你以为"这次只问了一句话",实际账单付的是"一整套工具 + 全部历史 + 全部规则"。
- 不要看到好工具就安装,把工具数量控制在够用就行,一定要记住:每个启用的工具都是每次调用的固定开销。
- 调用次数是乘数。
- 本次实测里,把每轮调用次数压到10次以内,可以砍掉约82%的总消耗;把上下文体积砍一半,只能省3%到17%。两个数字差了一个数量级。
- 给调用次数设一个硬上限
- 把长表格和长日志落盘成文件只让模型读结论
- 在上下文接近阈值时主动开新会话
- 缓存读取是"重复劳动"的钱。
- 它便宜,但量大到足以把token 消耗烧穿10倍;
- 本地 93.6% 的重复上下文在任何口径下都是纯浪费。
- 先砍上下文体积(autoCompactWindow、块预算),再谈调优。