
如果你在用 Claude Code、OpenClaw 这类 AI Agent 工具,迟早会发现一个尴尬:模型很聪明,但一遇到专业活儿——比如「帮我审一遍这个 API 的注入风险」——它给的答案泛泛而谈,全是「需要注意 SQL 注入」这种正确的废话。
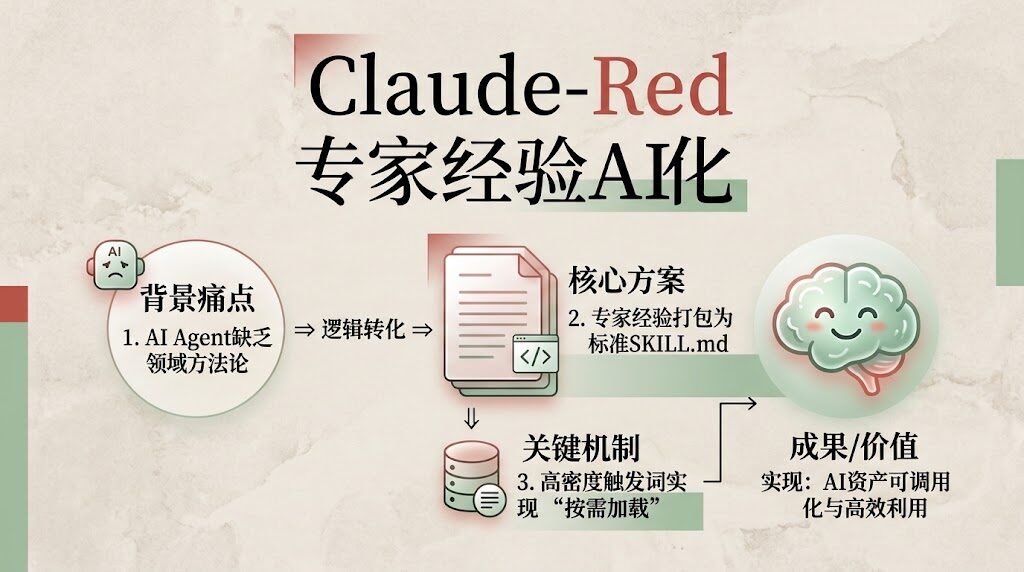
原因其实不玄学:模型缺的不是通用知识,而是某个具体领域的方法论。什么探测顺序、什么 payload、卡住了往哪走、什么时候该停手——这些如果不写下来,模型每次都得从零推理。
Claude-Red 就是把这套东西补上的。它把 78 个安全领域的「专家人格」打包成标准 SKILL.md 文件,你按触发词挂上去,Claude 就能像换了个专业脑子的工程师那样干活。本文拆解它到底怎么做的,以及这套思路能怎么借鉴到你自己搭的 Agent 技能库里。
它是什么:一个把安全专家「装」进 Claude 的技能库
先给个坐标:这是一个 Python 为主体的开源项目,MIT 许可,2026 年 3 月建仓,到 10 月中已经攒到 8,601 星、1,106 个 fork。体量不算最大,但在「AI 做安全」这条赛道上,它是目前最成体系的一个。
仓库档案速览
| 项 | 值 |
|---|---|
| 仓库 | SnailSploit/Claude-Red |
| 总星标 / Fork | 8,601 / 1,106 |
| 主要语言 | Python(技能主体实为 Markdown) |
| 许可 | MIT |
| 技能数量 | 78 个 SKILL.md,23 个分类 |
| 创建时间 | 2026-03-04 |
| 最近推送 | 2026-10-12 |
| 当前版本 | v0.3.0,Unreleased 进行中 |
一句话定位
把 Claude 变成「上下文感知的红队操作员」的即插即用攻击性安全技能库。注意它卖的不是工具,是方法论——每个技能文件本质上是一份写得极其具体的作战手册。
它到底做了什么:一份技能文件长什么样
这是全项目最值得学的部分。Claude-Red 的技能不是「一段提示词」,而是一份标准 SKILL.md 文件——YAML frontmatter 加结构化正文,写清楚某个攻击面的完整方法论:探测手法、绕过思路、工具链命令、边界情况,以及什么时候该升级到下一步。
触发词密度:技能能不能被自动触发,全看 description
以 SQL 注入技能为例,它的 description 长这样(原文):
Use when performing web application SQL injection testing, database enumeration, privilege escalation via SQLi, or assessing injection vectors in APIs and modern stacks.注意这句话里塞进了多少触发词:SQL 注入、bug bounty、枚举、权限提升、WAF 绕过、ORM CVE、API 注入。这不是啰嗦——AI Agent 是靠语义匹配决定「要不要加载这个技能」的,description 里没写到的词,模型大概率就想不起来去调它。
正文结构:先给主流程,再逐层展开
同一个文件(9,880 字节)的正文是这么组织的:开头一个「Quick Workflow」给 5 步主流程,让人一眼看到全局;然后展开 Detection,按 Basic Probes → Error-Based → Boolean Blind → Time-Based 排开;每个手法后面直接跟 payload 代码块,而不是「了解 SQL 注入原理」这种正确的废话。
关键设计:用不到的技能,不占上下文
78 个技能不可能全塞进上下文窗口,所以它走的是按需加载:技能按对话触发词命中才被读进来,用不上就完全不占 token。这套机制和 OpenClaw 的 Skills 机制完全同构——你如果熟悉那一套,看这个项目会觉得很亲切。
23 个分类、78 个技能:覆盖面到底有多宽
为了让你快速判断「这玩意跟我的活儿有没有关系」,这里把完整分类列出来。注意看分布——它不是堆了一批同质化的 SQL 注入技能,而是把安全工作的整个面铺开了。
| 分类 | 技能数 | 覆盖焦点 |
|---|---|---|
| Web Application | 16 | OWASP Top 10、业务逻辑、高级 Web 漏洞 |
| Wireless | 14 | 802.11 / WPA2-3 / EAP / WPS / evil-twin / BLE / Zigbee / Z-Wave / LoRa |
| Infrastructure & Red Team | 7 | 初始访问、EDR 绕过、Windows 内核 |
| Exploit Development | 6 | 栈/堆破坏、ROP、缓解机制、崩溃分析、TOCTOU |
| Fuzzing & Vuln Research | 4 | libFuzzer、AFL++、覆盖率引导、漏洞分类法 |
| Post-Exploitation | 3 | 横向移动、持久化、数据外泄 |
| Auth & Identity | 2 | JWT 利用、OAuth/OIDC 滥用 |
| Reconnaissance | 2 | OSINT 工具、结构化情报收集 |
| API Security | 2 | REST/gRPC/WebSocket、业务逻辑滥用 |
| Container & K8s | 2 | 容器逃逸、集群攻击 |
| CI/CD | 2 | 流水线利用、密钥窃取 |
| Cryptography | 2 | 密码学实现攻击、TLS/SSL |
| Privilege Escalation | 2 | Linux/Windows 提权 |
| Supply Chain | 2 | 供应链攻击、依赖混淆 |
| Social Engineering | 2 | 钓鱼、vishing、smishing、U 盘投毒 |
| Forensics & C2 | 2 | 反取证、C2 框架操作 |
| Active Directory | 1 | 内网 AD 攻击方法论 |
| Cloud | 1 | AWS/Azure/GCP 攻击路径 |
| Mobile | 1 | Android/iOS 应用测试 |
| IoT & Embedded | 1 | 硬件、固件、RTOS、ICS/OT |
| Network Attacks | 1 | 二层/三层攻击、MITM、协议投毒 |
| AI Security | 1 | 提示注入、越狱、RAG 投毒 |
| Utility | 2 | 快速分诊清单、专业报告模板 |
Web 应用占 16 个:密度最高,也最贴近日常
如果你是做业务的,16 个 Web 技能基本覆盖了你日常会遇到的:注入、XSS、反序列化、SSRF、文件上传、鉴权绕过、业务逻辑。每一个都是独立技能,而不是一篇「Web 安全大全」。
无线安全 14 个:少见的"重"领域
802.11 握手、WPA2/3 破解思路、evil-twin 钓鱼热点、蓝牙、Zigbee、LoRa——这块在 AI 安全项目里几乎没人做。它说明作者不是跟风做热点,而是按安全工作的真实分工在铺。
IoT 与嵌入式只有 1 个:诚实的留白
硬件、固件、RTOS、工业控制系统被归成 1 个技能,而另一些方向却拆成十几个。分类粒度的差异本身传递了信息:作者知道哪块是难点,哪块还只是浅尝。
AI Security 那 1 个:给 AI 时代补的一格
提示注入、越狱、RAG 投毒单独成类。在一个 2026 年的安全技能库里,这格的存在本身就是信号——它承认 AI 系统本身也是攻击面,而不只是干活的工具。
两个被低估的「元资产」
78 个技能本身是资产,但真正让这个项目「可运营」的是另外两个文件。它们的思路比技能内容更值得抄。
MINDMAP.md:把技能库当资产管理,不是当文档堆
这是一张 6,995 字节的 mermaid 思维导图,把 78 个技能全部铺开。它当然可以当导航用——但作者真正的用法是覆盖度审计:在接手一次安全评估之前,先对着导图看一遍,哪里是空的、哪块技能只覆盖了一半,一目了然。
这个差别很大。多数人的技能库是「攒」,攒到哪儿算哪儿;这里是「盘」,每次动手前先盘一遍家底。放到你自己身上同样成立——你有多少个电商运营技能、覆盖到哪类活动、哪个环节还是空白,一张图胜过翻目录。
CHANGELOG.md:把「变厚了」记成可审计的事实
v0.3.0 那次深度重写,CHANGELOG 里记的不是「优化了若干技能」,而是具体行数变化:
| 技能 | 重写前 | 重写后 |
|---|---|---|
| offensive-deserialization | 183 行 | 600+ 行 |
| offensive-ssti | 347 行 | 758 行 |
| offensive-graphql | 207 行 | 567 行 |
| offensive-advanced-redteam | 146 行 | 640 行 |
同时列出了 Phase 1~6 的拆分计划:Active Directory 拆 16 个、云身份拆 10 个、IoT 拆 10 个等。拆分即版本化——当一个技能太粗时,正确做法不是把它写得更长,而是拆成若干更细的技能,让触发更准、加载更省。
工程配套:作者考虑的是「别人怎么用起来」
一个技能库能不能被真的用起来,取决于安装门槛。这个项目的配套做得比同类扎实:
install.sh:支持只装一个分类
交互式安装,带 --target 和 --category 参数。你不需要 78 个技能全上身——只关心 Web 那一类,装 16 个就够。这直接决定了「上手成本」和「实际采用率」。
git sparse-checkout:避免全量 clone
配合按分类安装,仓库支持稀疏检出。78 个技能加上文档,完整克隆并不小;能只拉你需要的部分,说明作者清楚这东西会被放在什么环境里用。
claude-skills.json 与 convert_skills.py
前者是一份 58,607 字节的全量技能元数据索引,后者是一个 8,353 字节的批量转换脚本。一个管「查」,一个管「改」,让技能库可以被程序化地维护,而不是靠人手一个个编辑。
SECURITY.md:攻击性内容项目的标配
做红队内容必然有人会问「怎么用来搞别人」。作者直接把安全披露流程写清楚,这一步不少项目省了——省掉的后果是:一旦被滥用,仓库就成了别人攻击的现成手册。
引用基准公开:MITRE ATT&CK / OWASP WSTG / PayloadsAllTheThings
每个技能都能追溯到公开的攻防基准。这既是可信度背书,也方便读者交叉验证,不用只信作者一家之言。
六条能直接抄走的方法论
看完它做了什么之后,真正值得你带走的其实是下面这六条。它们跟安全无关,你搭任何 Agent 技能库都用得上。
一、description 写法是技能触发成功率的真正杠杆
它的 description 不是一句概括,而是一串触发词密集堆叠的「Use when…」句式。对比一下我们多数自己写的技能——「一句话摘要 + 几个关键词」,命中率差着量级。
可落地的动作很轻:把你高频真实用到的说法(中英文各一套)显式写进 description 的「Use when…」句式里。这不是玄学优化,改一次触发率就有肉眼可见的变化。
二、单技能 500–800 行是「深度密度」基准
重写后的技能普遍 500–800 行,每行都是可直接复制运行的 payload、命令或具体绕过点。我们多数技能正文不到 100 行——差距不在篇幅本身,而在每节都带可以直接用的东西。
方法论要落到可复制的具体物上。写「需要注意异常处理」没用,写出「执行哪个命令、看到什么输出、然后怎么做」,才叫方法论。
三、把覆盖度审计当一等公民
MINDMAP 的真正价值不是导航,是让缺口可见。作者靠它在开工前发现覆盖不足的地方。你也可以给自己的技能库维护一张「能力域 × 技能」矩阵,把「我觉得还差点什么」从模糊感觉变成一份可视化清单。
四、拆分即版本化
面对「一个 AD 技能太粗」的痛点,作者的做法是拆成 16 个细分技能,而不是继续往一个技能里塞。这条原则直接可用:一个巨型技能的上下文成本高、触发不准;拆细之后,每个都能被精确命中。
你可以拿自己手上的技能试试——如果某个技能经常「该触发时没触发」,八成是它同时想管太多事。
五、用可审计的事实替代模糊的形容词
「183 → 600+ 行」这种记录方式,把「这个技能变厚了」变成了可核对的事实。你自己的技能更新日志也可以这么写:新增覆盖点数量、扩展了哪几类场景、替换掉哪些过时步骤——远比「优化了 XX」有用。
六、攻击-防御镜像对:共用一套分类语言
GitHub 当日榜单上,一个做防御(多阶段安全审计)的头部项目和一个做进攻(红队技能库)的头部项目同时在榜——作者自己把它们称作镜像对。这个现象值得借鉴的是结构而非内容:用同一套能力域划分,让「审计方」和「被审计方」说同一种语言,才能互相检查覆盖缺口。
怎么用起来:上手路径
下面是一条最省事的路径,你自己也能走一遍——不是为了用红队手段,而是为了体会「专业技能库」是怎么搭起来的。
第一步:只看,不要装
先打开 MINDMAP.md 和任意一个 SKILL.md 的原文。看两件事:description 怎么写、正文是不是每节都带可直接复制的东西。这一步不需要任何环境,也是判断「值不值得学它的写法」最快的方式。
第二步:挑一个分类装
用 --category 只装你看得懂的那一类。对绝大多数读者来说,Web Application 或 Utility 就够了。别一上来全量 clone 再在目录里迷路。
第三步:观察它是怎么被触发的
装好之后,故意用几种不同说法提同一个需求,观察技能有没有被正确拉起来、命中的是不是最合适的那一个。这个观察过程,比读十遍 description 都有用。
第四步:抄它的写法,改你自己的技能
挑你自己的两个技能:一个改 description(加触发词句式),一个改结构(每节补可复制命令),然后对比触发命中率的差别。这是最低成本的验证。
什么时候用不上它:几个诚实的场景
不是所有项目都值得你投入,下面这些情况可以直接跳过。
你不做安全相关的工作
这 78 个技能全是攻防方法论。你要做的如果是内容运营、电商运营、常规后端业务,装了它们不会带来任何收益——它们唯一的价值在于「专业领域方法论怎么写」。
你的环境不允许装这类技能
有的团队对外部技能库、Claude 技能挂载有明确的安全规范,那就先看规范再看项目,别先装上再想办法解释。
你期待它直接给出可用结论
它是方法论库,不是答案机。给你的是「怎么查、按什么顺序查、卡住了往哪走」,具体结论仍然要你在自己环境里跑出来。别把装技能当成自动化。
你想找的是防御工具
这项目偏进攻侧(红队)。如果你要的是防御侧的审计工具,那是另一个方向的成熟项目,别在一棵树上找两边的果子。
内容声明与使用边界
Claude-Red 属于攻击性安全内容。本文只从方法论与技能工程的角度讨论它——怎么组织专家知识、怎么写 description、怎么用 MINDMAP 做覆盖度审计、怎么拆分技能。
本文讨论的技术内容仅供安全研究与防御参考。相关技能不部署、不用于任何未授权测试,不应用于攻击任何真实系统或他人资产。任何实际使用都必须在获得明确书面授权、且在自有或受控隔离环境内进行。
关于合规边界的三点提醒
第一,方法论本身没有违法与不违法之分,未经授权使用才有。你把「SQL 注入有 Error-Based、Boolean Blind、Time-Based 三类探测路径」写进自己的技能库,和你拿它去扫别人的站,是两件完全不同性质的事。
第二,公开漏洞与授权测试之间要画线。CVSS 分数高不等于获准测试;对方没给书面授权,再「只是验证一下」也可能构成未授权访问。
第三,把安全边界写进流程,比写在口头承诺里可靠。给自己团队的技能库加一条默认规则——涉及真实目标的技能必须显式标注授权范围——这个成本极低,能挡掉绝大多数麻烦。
结语:真正值得带走的是那个「思路」
Claude-Red 有 8,601 颗星,但如果你只是把它当成一个「红队工具包」来理解,你看不出它最有价值的地方。
它真正示范的是一件事:怎么把一个专家脑子里的隐性知识,变成 AI 可以按需调用、可以版本管理、可以审计覆盖度的显性资产。这件事跟安全没什么关系,它对任何专业领域都成立——电商、运营、数据分析、财务、法务,任何需要「让 AI 干专业活」的场景都适用。
如果你也在搭自己的 Agent 技能库,这篇文章里最值得你立刻动手的只有三件:给 description 加上「Use when…」触发词句式、给每个技能正文补上可复制的具体物、以及给技能库画一张覆盖度矩阵。
三件都不复杂,一下午就能做完第一个。而效果,通常比换模型来得明显。