
GitHub 今日 AI 板块最炸裂的项目 PrimeIntellect-ai/prime-agent,单日 +1,138 颗星,总星 14,435。这篇文章把它的核心机制拆开讲清楚:为什么它让 AI Agent 从"能跑对话脚本"跨到"能自我进化",以及它和 Claude Code、AutoGPT、crewAI 到底差在哪。
如果你正在用 Claude Code 写代码,或者考虑搭一个长期跑的任务自动化助手,又或者只是好奇 AI Agent 能玩出什么花样 —— 这篇值得花 10 分钟。
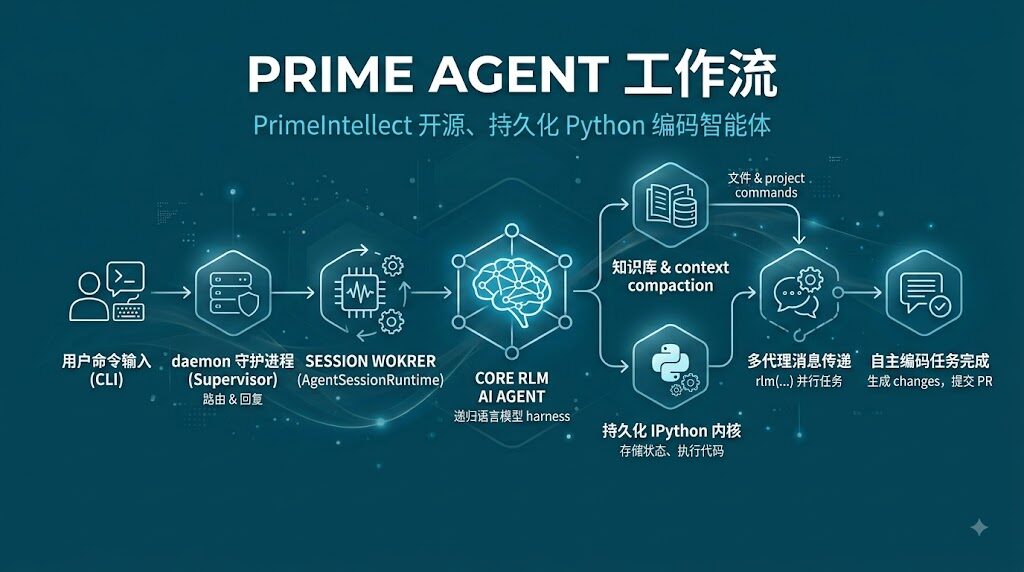
它到底是干嘛的
Prime Agent 是一款 MIT 协议的开源 AI Coding & Research Agent,定位是"能长时间自主跑、跑完还能自己复盘改进"。听起来是不是有点像 AutoGPT?区别在于它不是空喊口号,而是用一套扎实的工程机制把这事做成。
三个核心关键词:RLM(递归语言模型)、Continual Harness、程序化执行。
RLM:把上下文变成变量
传统 Agent 把对话历史当"上下文窗口"塞给模型,窗口爆了就失忆。RLM 把 Context 直接当 Python 变量,工具、子 agent、API 调用统统是函数调用。整件事运行在一个持久化 REPL 里 —— 也就是说你开着它跑一个 6 小时的研究任务,6 小时后它还在同一个 Python 进程里。
Continual Harness:让 Agent 真的能"成长"
这是 prime-agent 最值钱的部分。它有一个持久化存储层存放提示词、记忆、技能规范,里面跑着 /refine 命令。这个命令做的事情很简单:审查过去 30 轮 agent 的执行轨迹 → 找出哪些决策可以更好 → 基于证据做小步更新。关键是不重写 base prompt,只做 evidence-backed 的增量改动。这和"自动改 prompt"的玄学不一样,它是结构化的、可回滚的。
程序化执行:所有操作都是函数
文件操作、shell 执行、工具调用、子 agent 调度、上下文管理 —— 全部通过 Python 代码实现,而不是对话式串脚本。子 agent 用 rlm(...) 调用,return 的不是字符串而是 Python 对象,pipeline 化特别简单。
性能数据说明
- 活跃 Stars:14,435(截至 2026-08-12)
- 今日增量:+1,138,属于爆发期
- 所属组织:PrimeIntellect.ai(专注 RL + AI Agent 研究)
- 底层依赖:pi(一个 TUI/Agent 框架)
中间没有任何"我用了多牛"的自夸,都是公开 GitHub 数据。
上手指南
# 一键安装(macOS / Linux)
curl -fsSL https://app.primeintellect.ai/prime-agent/install.sh | sh

# 进入工作目录启动
cd /path/to/project
prime-agent

# 首次启动需要认证
prime-agent /login
常用命令:
prime-agent agents:浏览运行中的 sessionprime-agent attach <agent>:附加到运行中的 sessionprime-agent --resume <path|id>:恢复已保存的 sessionprime-agent status:查看后台服务状态prime-agent doctor [--fix]:检查 / 修复后台服务prime-agent update [--force]:更新prime-agent shutdown [--force]:关闭所有 agent
前置依赖:IPython(安装脚本会自动准备)。
和同类项目对比
这是最能讲清楚 prime-agent 价值的一张表。
| 项目 | 许可证 | 本地运行 | 子 agent | 后台持久化 | 自我改进 | 技能包 |
|---|---|---|---|---|---|---|
| prime-agent | MIT | ✅ | ✅ 程序化 | ✅ daemon | ✅ /refine | ✅ Python 包 |
| Superpowers | MIT | ✅ | ❌ | ❌ | ❌ | ⚠️ Shell 脚本集 |
| OpenClaw | MIT | ✅ | ✅ | ✅ | ❌ | ✅ 多语言 Skills |
| AutoGPT | MIT | ✅ | ✅ | ⚠️ 有限 | ⚠️ 实验性 | ⚠️ 插件市场 |
| crewAI | Apache | ✅ | ✅ 对话式 | ❌ | ❌ | ❌ |
| n8n | SSPL | ⚠️ 自托管 | ⚠️ Workflow | ✅ | ❌ | ⚠️ 节点市场 |
核心差异:prime-agent 是目前唯一同时具备"程序化子 agent + daemon 持久化 + /refine 自我改进"三者结合的开源 Agent 框架。
很多读者会问:那 Claude Code 呢?Claude Code 不在表里,因为它不开源、不是 MIT、不能本地部署。但如果你问"理念上谁更接近",答案是 Claude Code,因为二者的核心信念都是"agent 应该能 long-running、能 refine"。prime-agent 是这个理念的开源实现。
自我改进到底怎么用
这部分是 prime-agent 的杀手锏。当一个 agent 跑完一批任务后,你可以:
- 输入
/refine:触发对自己行为轨迹的审查 - 它会扫描最近 N 轮的执行记录,找"明明有更好做法"的决策点
- 基于证据(不是想法)生成小步修改建议
- 修改只影响 harness 状态,不动 base prompt,因此可回滚
这套机制的意义是:你的 agent 跑得越久,它越懂你。不会"重启就归零"。这是 AutoGPT 那种"memory 文件"做法没真正解决的痛点。
适合谁用 / 什么时候用不上
适合:
- 长期跑的研究任务(论文综述、代码库分析、批量数据处理)
- 需要定制 harness 的 AI 团队(你能直接改 Python 包层的 skill)
- 习惯 CLI、不需要 GUI 的开发者
用不上:
- 只想跑一两次对话的轻量用户(直接用 Claude Code / Cursor 更省事)
- 团队全是 GUI 党(prime-agent 没有 Web UI)
- 怕折腾 IPython 依赖的人
小结
prime-agent 的爆发不是偶然。它在一个被 AutoGPT 玩坏过的赛道里,用 RLM + Harness + /refine 三个工程模块认真回答了"AI Agent 怎么长期跑"的问题。对开发者群体来说,这是一个值得花一个周末上手的项目;对 AI 工具选型者来说,它是一个观察 RL 训练 + Agent 框架结合的前哨。
如果你已经在用 Claude Code 或类似的 AI 工具,prime-agent 不一定替代你,但它的 /refine 思路绝对值得借鉴 —— 任何 AI 工作流,能让模型"复盘自己"的设计,长期价值都远超"换个更强的模型"。