
今天的 GitHub Trending 榜单上,一个支持全平台离线运行的 AI 虚拟助手格外引人注目——Open-LLM-VTuber 单日收获 581 颗星,总星数逼近万星大关(9,718⭐)。它最大的卖点是什么?不需要联网、不需要特定硬件,就能在你自己电脑上跑一个能「看」手势、「听」语音、「说」话的 Live2D 虚拟伙伴。
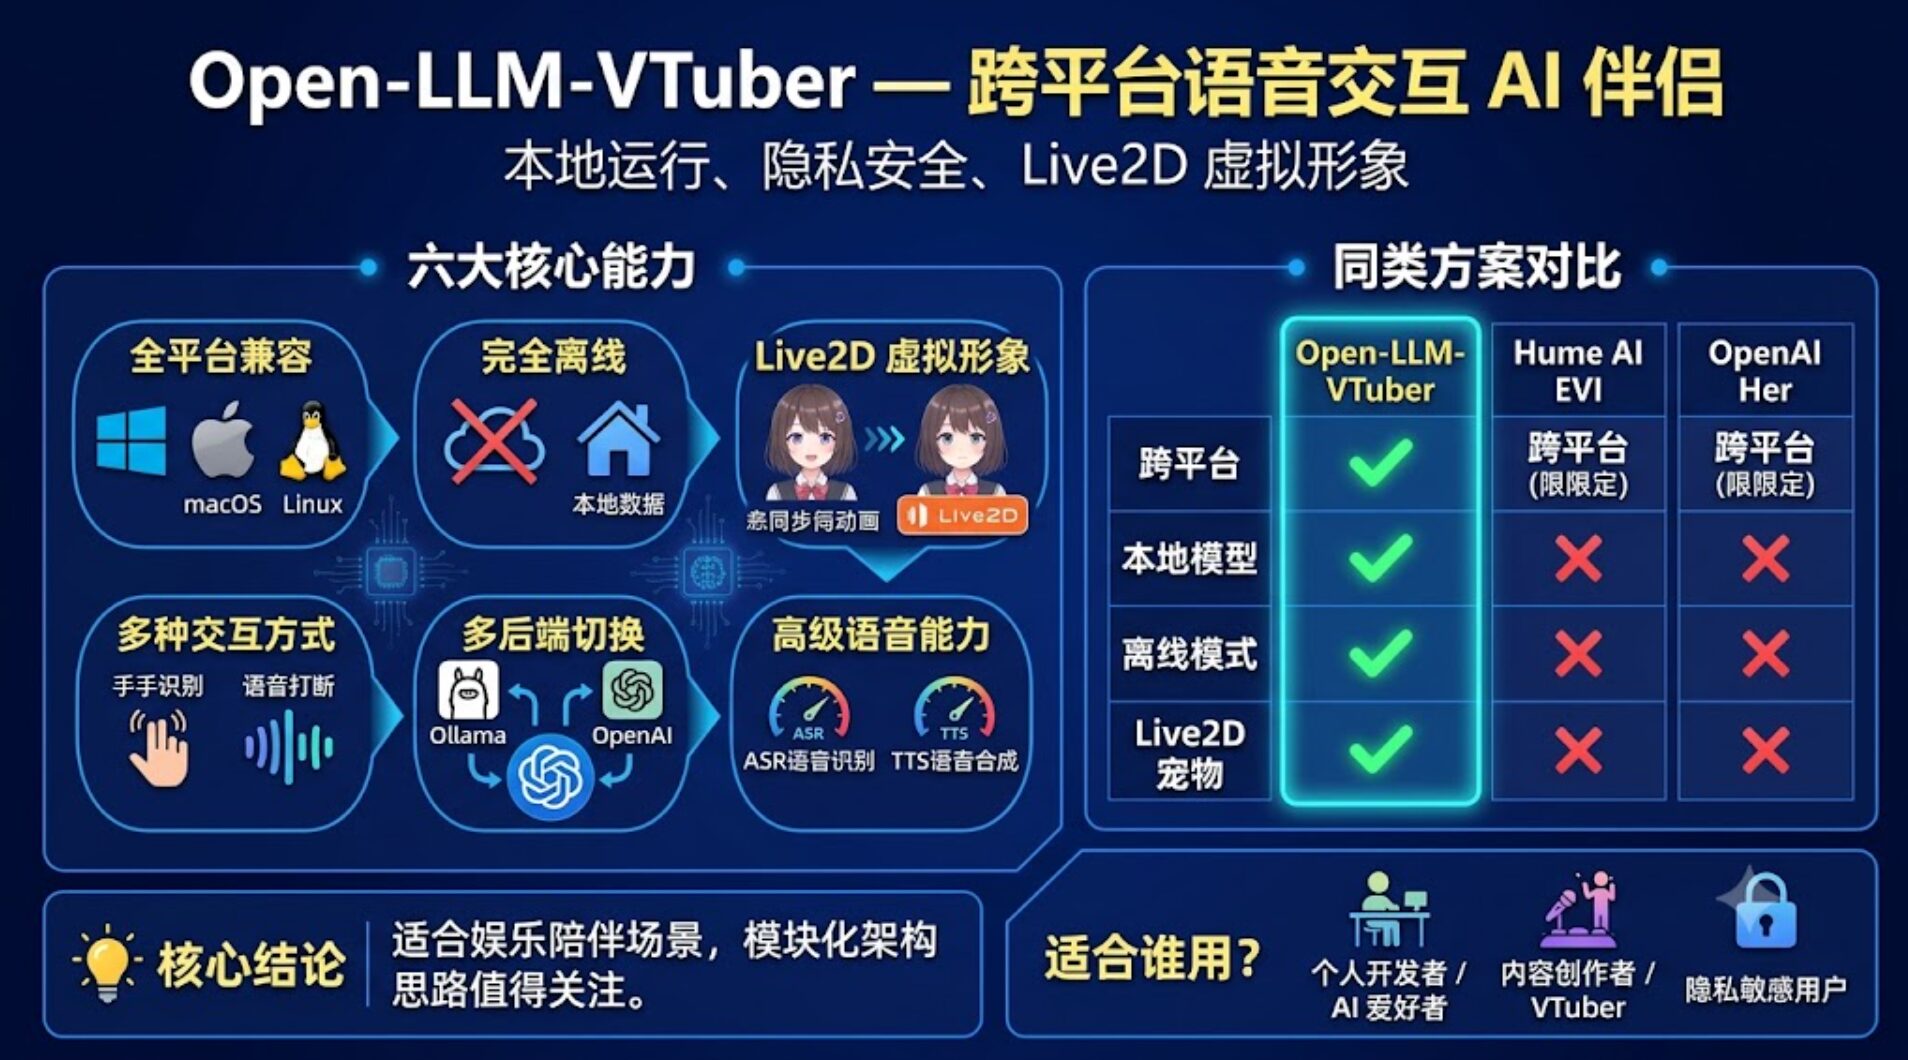
Open-LLM-VTuber 是什么?
简单来说,它是一个开源的「虚拟 AI 伴侣」框架。不同于市面上大多数语音助手(比如 Siri、小爱同学),Open-LLM-VTuber 能让你在本地电脑上跑一个大模型驱动的虚拟形象——它能听懂你说的话(语音识别),能用自然语言回复你(大模型生成),还能用语音合成把回复「说」出来,搭配 Live2D 形象实现口型同步和表情变化。
换个方式理解:如果你看过虚拟主播(VTuber),Open-LLM-VTuber 就是把虚拟主播背后的动捕和 AI 对话能力打包成了一个开源软件,让你不需要专业设备和团队也能跑起来。
六大核心能力
🖥️ 全平台兼容:Windows、macOS、Linux 都能跑,支持 NVIDIA 显卡也支持非 NVIDIA 显卡(Intel、AMD 等),不挑硬件。
🔒 完全离线:所有模型(包括大语言模型、语音识别、语音合成)都在本地运行,不需要联网。这意味着你的对话数据不会离开你的电脑。
🎭 Live2D 虚拟形象:桌面应用支持透明背景的 Live2D 模型,虚拟角色会随语音输出同步做口型和表情,更像一个「真实存在」的桌面宠物。
🎤 多种交互方式:支持手势识别、语音打断(你在它说话时插嘴,它能停下来听)、触摸反馈等。不是那种「等它说完才能说话」的死板对话。
🔌 多后端灵活切换:大模型后端支持 Ollama、OpenAI 等多种来源。你可以用自己部署的开源模型(如 Llama、Qwen),也可以用 OpenAI 的云端 API。
🗣️ 高级语音能力:语音识别(ASR)支持 sherpa-onnx、FunASR、Faster-Whisper 等多种引擎;语音合成(TTS)支持 MeloTTS、Coqui-TTS 等,可根据需求选择性能和质量的最佳平衡。
与同类方案对比
| 特性 | Open-LLM-VTuber | Hume AI EVI | OpenAI Her |
|---|---|---|---|
| 跨平台 | Windows / macOS / Linux | macOS / iOS | 仅 Web |
| 本地模型 | ✅ | ❌ | ❌ |
| 离线模式 | ✅ | ❌ | ❌ |
| 透明桌面虚拟形象 | ✅ Live2D | ❌ | ❌ |
一目了然:Open-LLM-VTuber 是唯一一个同时做到「跨平台 + 本地模型 + 离线 + Live2D 宠物」的方案。Hume AI 和 OpenAI Her 虽然背后有强大的云端模型,但运行环境受限且必须联网,对隐私敏感或网络不稳定的场景不够友好。
适合谁用?
个人开发者 / AI 爱好者:想体验「本地 AI 虚拟助手」的感觉,愿意花时间配置环境。
内容创作者 / VTuber:需要一个开源的、可定制的虚拟形象驱动方案,不依赖商业软件。
隐私敏感用户:不想把个人对话数据上传到云端,希望全部在本地处理。
核心结论
从实用角度来说,Open-LLM-VTuber 目前更适合娱乐和陪伴场景,暂时不适合作为生产级的 AI 工作助手部署。但它的模块化 Agent 接口设计非常值得关注——将语音识别、大模型推理、语音合成拆分为独立模块,通过统一接口串联,这种「搭积木」式的架构思路,对优化多 Agent 协作模式有不少借鉴意义。
如果你只是想尝鲜,直接用它的 Web 版就能体验;如果你想折腾,桌面端的 Live2D 透明背景桌面宠物是个很有趣的方向。