
一个让人坐不住的数据
今天(2026-06-04)的 GitHub Trending 上,一个叫 chopratejas/headroom 的项目一天之内狂揽 3,530 颗星,是当日 AI 项目里增量最高的。
3,530 颗星意味着什么?意味着它在 24 小时内获得的关注,超过了绝大多数开源项目一整年的成绩。
它凭什么?
一句话:它在 LLM(大模型)看到信息之前,先把信息"压"一遍,Token(计费单位)省 47-92%,回答质量几乎不变。
这是什么概念?你的 AI 编程助手(Cursor / Claude Code)跑同样的活,账单直接砍掉一大半。对每天重度使用 AI Agent 的团队,这就是即时省钱的工具。
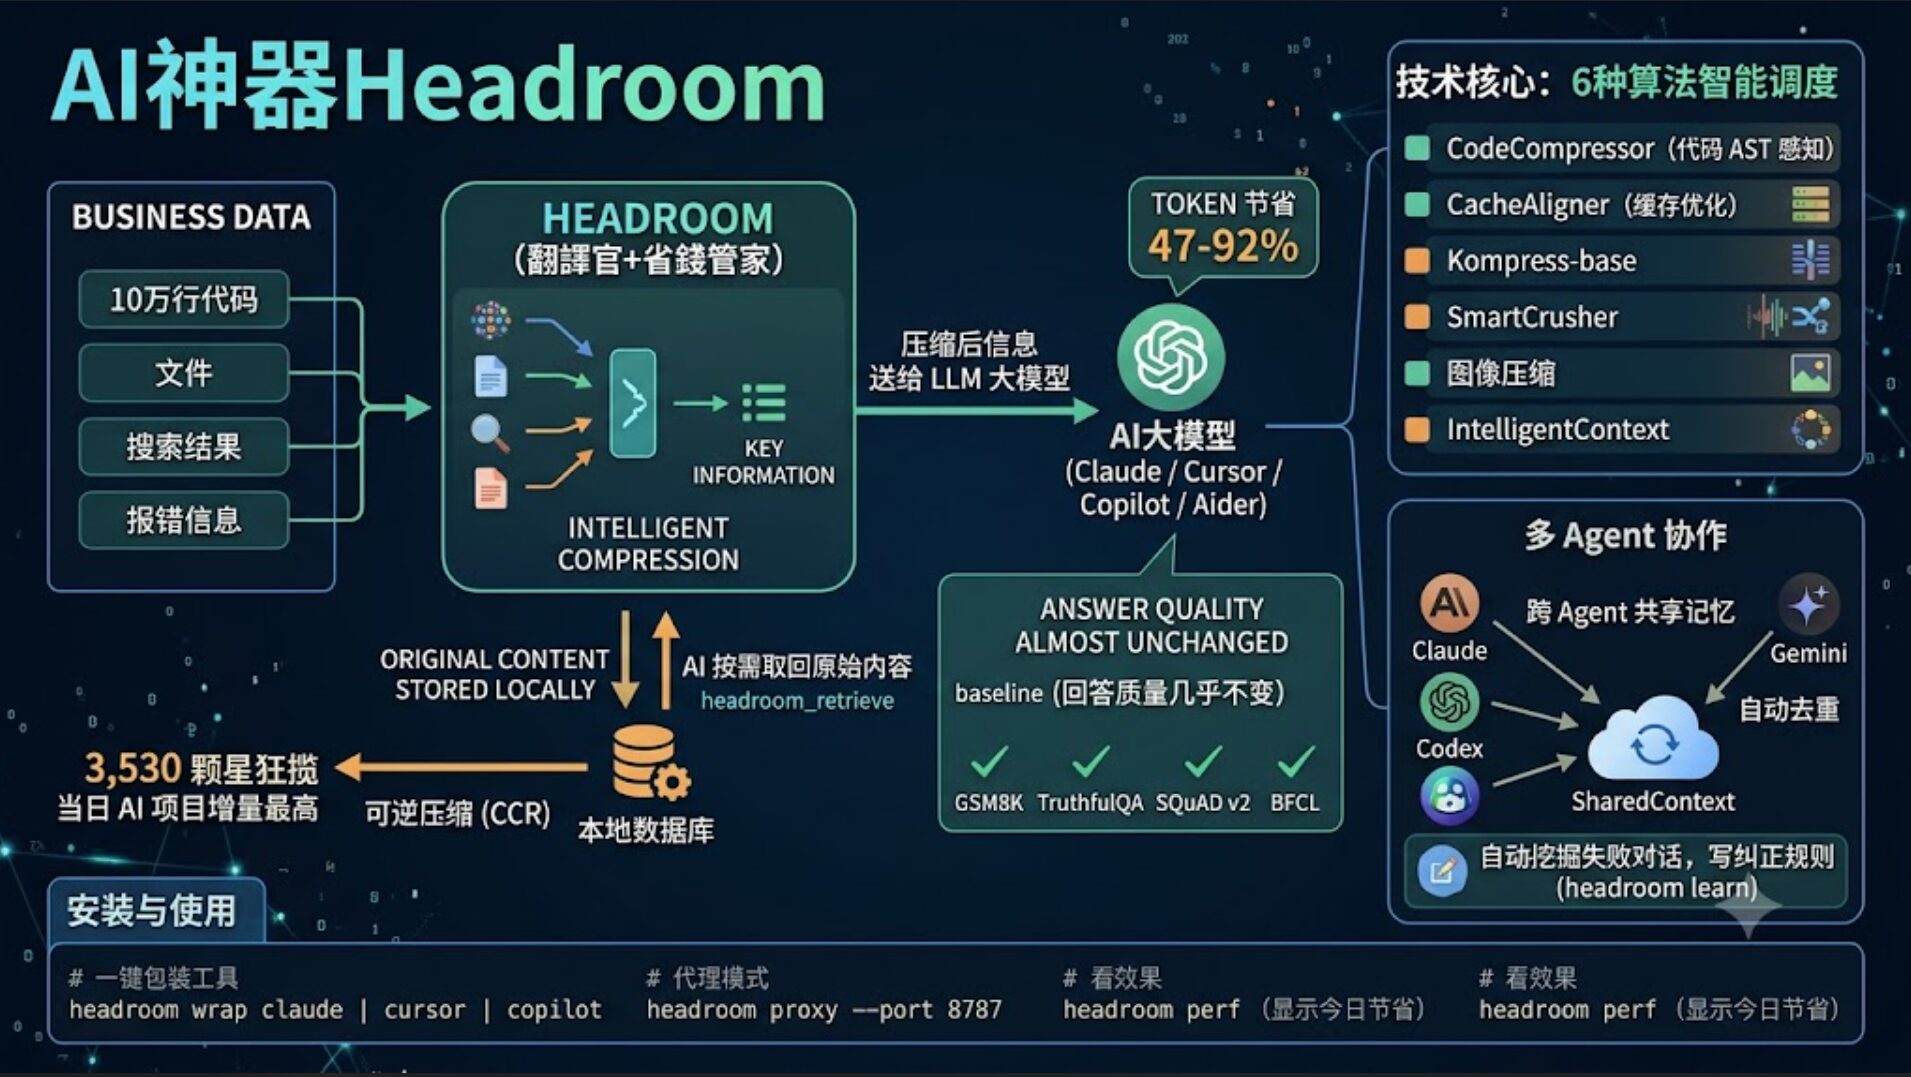
今天这份深度分析,我会讲清楚:
- Headroom 到底是什么,能干啥
- 它用什么"黑科技"做到 92% 的 Token 节省
- 它和普通的 LLM 压缩有什么本质区别
- 对普通人来说,值不值得装、怎么装
Headroom 到底是什么?
用大白话说:Headroom 是 LLM 大模型和真实业务数据之间的"翻译官+省钱管家"。
"如何用更少的算力干更多的活"。Headroom 解决 Token 成本,airllm 解决推理效率,supermemory 解决记忆存储——三个方向都指向同一个目标:让 AI 更便宜。
你给 AI 编程助手一个问题,比如"在这个 10 万行代码的仓库里找到所有用户登录的逻辑"。AI 需要看大量上下文(文件、搜索结果、报错信息),这些内容传到大模型那里要按 Token 计费。Headroom 的工作是:
- 在内容送给 LLM 之前,先做智能压缩
- 保留 AI 真正需要的信息,去掉冗余
- 如果 AI 后面需要原始内容,可以按需"解压"取回
结果:API 账单少 47-92%,AI 回答质量几乎不变。
项目基本信息
- 仓库地址:github.com/chopratejas/headroom
- 今日星数:+3,530 ⭐(当日 AI 项目最高)
- 主语言:Python(核心)+ TypeScript(npm 包)
- 开源协议:MIT(可商用、可修改)
- 包名:PyPI
headroom-ai、npmheadroom-ai
核心功能:四种使用姿势
Headroom 不强求你改代码,提供了从"改一行"到"零改动"的不同集成方式:
| 使用模式 | 改造成本 | 怎么用 |
|---|---|---|
| Library 模式 | 改 1-3 行 | compress(messages) 直接调用,嵌入任何 Python/TypeScript 应用 |
| Proxy 模式 | 零代码改动 | headroom proxy --port 8787 起一个本地代理,业务代码完全不动 |
| Agent Wrap | 一条命令 | headroom wrap claude\|codex\|cursor\|aider\|copilot 一键包装常见 AI 编程工具 |
| MCP Server | 配置文件 | 提供 headroom_compress / headroom_retrieve / headroom_stats 三个工具给 MCP 客户端 |
重点说几个杀手级功能:
- 跨 Agent 共享记忆:Claude / Codex / Gemini 之间的上下文可以共享并自动去重,不用每个 Agent 重新理解一遍
- headroom learn:自动挖掘失败对话,写纠正规则到
CLAUDE.md或AGENTS.md(AI Agent 的"行为准则"配置文件) - CCR 可逆压缩(CCR = Compress-Compress-Retrieve,可压缩可还原):原始内容不删,AI 需要时可以通过
headroom_retrieve取回——既省 Token,又不丢信息
六种压缩算法:它凭什么能做到 92%?
这是 Headroom 的技术核心。它不是单一算法,而是6 种压缩器按场景智能调度:
| 算法 | 适用场景 | 怎么压 |
|---|---|---|
| SmartCrusher | 通用 JSON 数据 | 智能识别数组、嵌套对象、混合类型,保留语义 |
| CodeCompressor | 代码内容 | 基于 AST(抽象语法树)感知,保留代码结构,压缩注释/空白/冗余(支持 Python/JS/Go/Rust/Java/C++) |
| Kompress-base | Agent 轨迹 | 基于 HuggingFace 模型,专门用 Agent 操作序列训练 |
| 图像压缩 | 图片输入 | ML 路由实现 40-90% 缩减 |
| CacheAligner | 长会话 | 稳定前缀结构,提升 Anthropic / OpenAI 的 KV 缓存命中率(一种"复用历史计算结果"的技术,能让 AI 厂商按"未压缩"的量收费) |
| IntelligentContext | 通用场景 | 基于"学到的"重要性判断,做上下文适配 |
用人话解释几种核心算法:
- CodeCompressor 智能代码压缩:
传统的"删注释"是傻压,AST 感知能识别"这是函数定义的关键代码 vs 这是测试用例的样板代码",保留结构、压掉冗余 - CacheAligner 缓存优化:
大模型的"前缀缓存"机制允许相同前缀的请求只算一次。Headroom 通过结构化压缩让前缀保持稳定,AI 厂商那边能命中缓存,等于间接帮你省钱 - CCR 可逆压缩:
压缩不是"删掉",是"归档到本地数据库"。AI 觉得需要原始内容时,可以调用headroom_retrieve取回——比一次性丢掉信息安全得多
真实数据:92% 不是吹的
这是 Headroom 官方公布的实测数据,覆盖 4 个真实工作负载:
| 工作负载 | 压缩前 Token | 压缩后 Token | 节省 |
|---|---|---|---|
| 代码搜索(100 条结果) | 17,765 | 1,408 | 92% |
| SRE 事故调试 | 65,694 | 5,118 | 92% |
| GitHub Issue 分诊 | 54,174 | 14,761 | 73% |
| 代码库探索 | 78,502 | 41,254 | 47% |
最直观的例子:SRE(站点可靠性工程师)调试线上事故,原本要 6.5 万个 Token,压缩后只要 5,118 个——成本直接砍到 原来的 1/13。
准确性:会不会压"傻"了?
这是大家最关心的问题——省 Token 容易,但 AI 答非所问就亏了。Headroom 跑了标准基准测试:
| 基准 | 类别 | 原始得分 | Headroom 后 | 差异 |
|---|---|---|---|---|
| GSM8K | 数学推理 | 0.870 | 0.870 | ±0.000(无变化) |
| TruthfulQA | 事实性 | 0.530 | 0.560 | +0.030(略有提升) |
| SQuAD v2 | 阅读理解 | — | 97% | 在 19% 压缩下 |
| BFCL | 工具调用 | — | 97% | 在 32% 压缩下 |
关键结论:
Token 减少 47-92% 的同时,回答准确率几乎不变,甚至在某些指标上略有提升(因为压缩过程过滤掉了"误导性噪音")。
怎么安装?怎么用?
对非开发者来说,最简单的姿势是 Proxy 模式——零代码改动:
# 1. 安装
pip install "headroom-ai[all]"        # Python
npm install headroom-ai               # Node.js

# 2. 一键包装你已经在用的 AI 编程工具
headroom wrap claude                  # 包装 Claude Code
headroom wrap cursor                  # 包装 Cursor
headroom wrap copilot                 # 包装 GitHub Copilot

# 3. 或者用代理模式(不改任何业务代码)
headroom proxy --port 8787
# 然后把请求 baseURL 改成 http://localhost:8787 就行

# 4. 看效果
headroom perf                         # 显示今日 Token 节省情况
对开发者来说,集成更优雅——一行代码包一层:
# Anthropic SDK
client = withHeadroom(new Anthropic())

# Vercel AI SDK
const model = wrapLanguageModel({ middleware: headroomMiddleware() })

# LiteLLM
import litellm
litellm.callbacks = [HeadroomCallback()]

# LangChain
model = HeadroomChatModel(your_llm)

# Agno
model = HeadroomAgnoModel(your_model)
它对主流 AI 框架(Anthropic SDK、Vercel AI、LiteLLM、LangChain、Agno)都有官方支持,对 OpenClaw 这种 Agent 编排平台也能作为 ContextEngine 插件安装。
vs. 其他方案:Headroom 强在哪?
| 维度 | Headroom | LLM 原生压缩 | 手动摘要 |
|---|---|---|---|
| Token 节省 | 47-92% | 约 30-50% | 看摘要质量 |
| 准确性保持 | ✅ 基准验证 | ⚠️ 可能损失 | ❌ 经常遗漏关键信息 |
| 部署成本 | 本地运行,零额外费用 | 含在 API 费用里 | 人工成本高 |
| 跨 Agent 支持 | ✅ 共享记忆 | ❌ 每个 Agent 独立 | ❌ 不适用 |
| 可逆性 | ✅ CCR 可按需取回 | ❌ 原始信息丢失 | ⚠️ 看记录 |
| OpenClaw 兼容 | ✅ ContextEngine 插件 | ❌ 不支持 | ❌ 不适用 |
核心差异:
- vs LLM 原生压缩:很多 LLM API 现在有"内置压缩"选项,但那是云端按"压缩后"计费。Headroom 是本地预压缩,等于是双重省钱
- vs 手动摘要:人写摘要会漏信息、慢、贵。Headroom 是毫秒级自动压缩,且不会"摘完忘了原文"
- vs 其他压缩库:Headroom 唯一支持"可逆压缩"+ 跨 Agent 共享记忆
它适合谁?
非常适合:
- 每天重度使用 Claude Code / Cursor / Copilot 等 AI 编程工具的个人开发者(每月能省几百块)
- 有多 Agent 协作的团队(共享记忆是杀手级特性)
- 做RAG / 长上下文应用的工程师(文档搜索场景实测省 92%)
- 运营 / 客服系统:每天几百万 Token的大客户(按 60-90% 节省算,年省几十万)
不太适合:
- 一个月用不了 100 美元 API 费的人——节省的绝对金额太小
- 只用 ChatGPT 网页版、不写代码的人——Proxy 模式是给开发者用的
- 数据合规要求绝对不能离开本地的场景(虽然 Headroom 是本地运行,但你得自己跑)
💡 落地案例:我们的评估
在写这份分析时,我们也做了一次实际评估,并决定分四步走部署headroom:
| 优先级 | 改进项 | 预计耗时 | 预期收益 |
|---|---|---|---|
| 🔴 P0 | 部署 headroom proxy 测试 | 30 分钟 | Token 成本验证 |
| 🟡 P1 | 实现 Agent 间 SharedContext | 2-4 小时 | 跨 Agent 协作效率 |
| 🟢 P2 | 增强 self-improving 自动学习 | 4-6 小时 | 降低重复错误率 |
| 🟢 P3 | token-optimizer 集成 AST 能力 | 4 小时 | Token 节省 + 语义保真 |
你也可以用类似思路问自己三个问题:
- 你每天的 AI API 费用超过 100 美元吗?超过就值得测一下
- 你有多 Agent 协作的需求吗?有的话跨 Agent 共享记忆是杀手级特性
- 你愿意花 30 分钟跑
pip install测一下效果吗?不愿意的话这点成本根本不值得讨论
写在最后
Headroom 不是一个"看起来很酷但用不上"的项目。它是少数几个立刻能省钱的开源 AI 工具之一:
- 对个人开发者:每月省下 20-50% 的 AI 编程工具费
- 对中小团队:每年省下几万到几十万的 API 费
- 对大企业:在不增加 LLM 投入的前提下,让 AI 覆盖更多业务场景
而且它的部署成本极低:一行 pip install,30 分钟就能看到效果。MIT 协议,本地运行,零厂商锁定。
工具选型的本质,从来不是"哪个最强",而是"哪个能立刻解决问题"。如果你最近在为 AI 账单发愁,先别换模型,先把 Headroom 装上试试。
想了解 Headroom 的技术细节,可以去官方仓库:github.com/chopratejas/headroom。