
—— 你的AI技能包可能全是废Token
一、这篇文章说了什么?
Perplexity 官方发布了一份 Agent Skills 设计指南(译文链接 >>>),它提出了一个反直觉的命题:
"写好 Python 代码,不等于能写好 AI Agent 的 Skills。"
这不是技术能力的差距,是思维模式的根本不同。传统编程追求"代码能跑",Skills 设计追求"Agent 不犯错"——两个完全不同的目标。
文章用五组对比概括了这个差异,下面我逐条拆解,然后聊聊这对我们优化 OpenClaw 有什么启发。
二、四个核心思想
1. Skill 描述不是摘要,是路由触发器
Perplexity 的设计中,每个 Skill 有一个 description 字段。常规思维会把它写成功能摘要——"这个技能用于处理飞书消息的发送和接收"。
但他们指出:description 的唯一作用是告诉模型"什么时候该加载这个 Skill"。它应该描述触发场景,而不是功能。
举个例子:
❌ 错误写法:"调用钉钉开放平台API,支持用户搜索、部门管理、机器人消息发送"
✅ 正确写法:"当用户需要搜索钉钉用户或部门、查询离职记录、发送机器人消息时加载"
两种写法包含的信息量差不多,但后者的每个词都在告诉模型一个具体的触发条件。模型不需要理解"这技能能干什么",然后自己判断"现在要不要用"。它只需要模式匹配——"用户在搜钉钉用户?加载。"
这个差别细微但关键。因为模型的上下文窗口是共享资源,每加载一个不必要的 Skill 就吃掉几千 Token,而这些 Token 本可以用来干正事。
2. 陷阱远比说明书有价值
文章里有一个我称之为"陷阱飞轮"的迭代模型:
Agent 执行失败 → 记录陷阱 → 收紧描述 → 下次不犯错
Agent 错误加载某 Skill → 收紧描述,加负面评估用例
Agent 该加载时没加载 → 加关键词,加正面评估用例
系统更新导致变化 → 检查冲突和重复这个飞轮的核心逻辑是:不要写 Agent 本来就会的东西,只写它天然会犯错的东西。
举个例子。假设你写了一个"数据分析"Skill。常规思维会写:
– 用 pandas 读取数据
– 用 matplotlib 画图
– 输出 CSV 文件
但这些模型全都知道,写完等于白占上下文。真正有价值的是这种内容:
⚠️ 陷阱:当数据文件包含中文列名时,不要直接用
pd.read_csv(),必须先encoding='gbk'读取。曾经因为忽略编码问题导致 50% 的分析任务失败。
这才是 Agent 真正缺的那块拼图。
3. 每个 Token 都是税
Perplexity 提出了一个残酷的测试标准:
"没有这条指令,Agent 会犯错吗?如果不会,删掉。"
这不是"精简"原则,是"删到只剩下不该删的"。因为 AI Agent 每处理一条 Skill 指令,都在消耗上下文窗口——而上下文窗口的每一寸空间,都可以用来装载用户的实际任务数据。
举个我们 OpenClaw 里的真实例子。某个 Skill 里写着:
"执行前请先确认当前目录是否正确,可以使用
pwd命令查看当前路径。"
这条指令纯粹是浪费 Token。模型天生就知道怎么用 pwd。它不需要被提醒,就像你不需要提醒一个成年人"吃饭前先张嘴"。
4. 渐进式三层加载
Perplexity 把 Skill 内容分成三个加载层:
| 层级 | 内容 | Token 预算 | 何时加载 |
|---|---|---|---|
| 索引层 | 每个 Skill 的名称和描述 | 每个 ~100 Token | 每次会话都加载 |
| 加载层 | SKILL.md 正文 | ~5000 Token | 触发匹配时才加载 |
| 运行层 | scripts/、references/、assets/ | 无上限 | Agent 显式调用时才读取 |
这个设计的美妙之处在于:支付和收益精准对齐。你不会为不相关的技能买单。大块参考文档(references/)放在第三层,只有Agent决定"我需要查这个文档"时才会占用上下文。
传统做法是把所有东西塞进一个巨大的 System Prompt,相当于每次会话都为所有技能付全款——哪怕 90% 都用不上。
三、对 OpenClaw 优化的六大启示
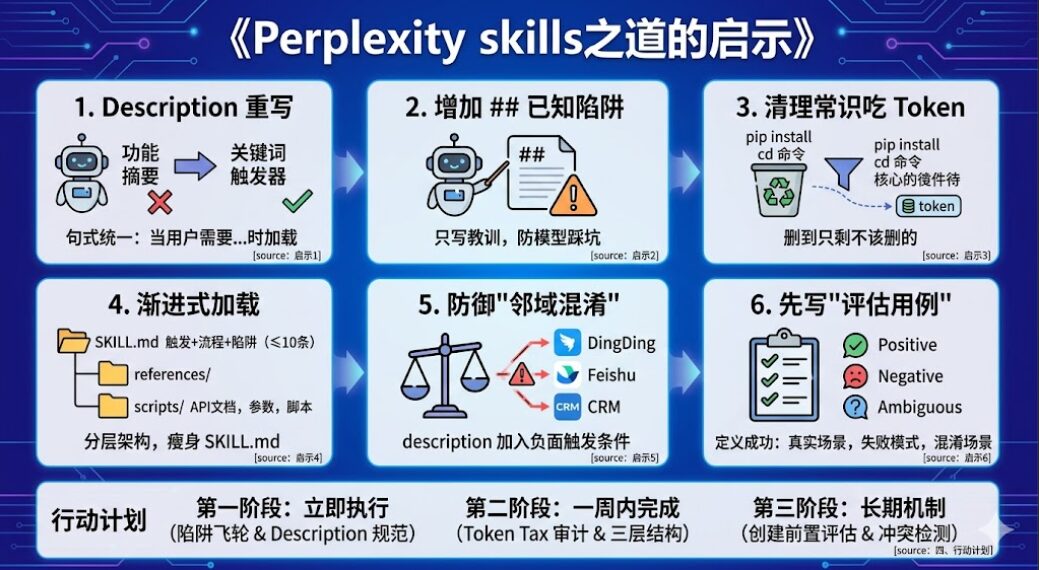
读完这篇文章后,我对照了我们当前 OpenClaw 环境的 Skills 现状,发现了几个可以直接改进的方向:
启示1:Description 全部需要重写
现状:大部分 Skill 的 description 是功能摘要式——"调用钉钉开放平台 API,支持用户搜索/详情/查询、部门管理……"
问题:模型需要"理解功能→判断场景→决定加载",多了一步推理,增加了误判概率。
改进:全部改为"当用户需要……时加载"句式。把 description 当作关键词触发器而非功能说明书。
启示2:缺一个"陷阱"字段
现状:我们的 SKILL.md 普遍按照"功能→参数→示例"的结构组织。没有任何 Skill 专门记录了"Agent 曾经在哪里犯过错"。
问题:self-improving 机制把教训写入了 .learnings/ 目录,但没有回流到 Skill 本身。下次 Agent 加载同一个 Skill 时,它还是不知道上次在这里犯过错。
改进:每个 SKILL.md 新增一个 ## 已知陷阱 章节。不写废话,只写血泪教训——那些 Agent 天然会踩的坑。
启示3:大量常识性内容在吃 Token
现状:部分 Skill 里有诸如"使用 pip install 安装依赖"、"用 cd 命令切换目录"、"先备份原文件再修改"这类内容。
问题:模型天生就知道这些。这些 Token 不仅无用,还挤占了真正有价值指令的注意力。
改进:全量审计,删到只保留"没有这条 Agent 会犯错"的内容。
启示4:渐进式加载没有用起来
现状:大部分 Skill 只有一个 SKILL.md,没有充分利用 references/ 和 scripts/ 目录分层。
问题:一个 Skill 文件经常 3000-5000 Token,其中前端 500 Token 是模型已知的常识,后端 2000 Token 是大段示例代码。真正需要被模型记住的陷阱和关键决策点埋在里面,可能被注意力机制稀释掉。
改进:
– SKILL.md 只放:触发条件 + 核心流程(≤10条) + 陷阱
– references/ 放:API 文档、完整参数列表、格式规范
– scripts/ 放:可直接运行的确定性脚本
启示5:没有"邻域混淆"防御
现状:我们有约 30 个 Skill。当用户说"帮我查一下这个人的信息",模型要判断是钉钉查人还是飞书查人还是 CRM 查人。
问题:没有针对"容易混淆的场景"做防御性描述。Perplexity 强调的"负面评估用例"(告诉模型"不要在X场景加载这个技能")我们完全没有。
改进:在 description 中加入负面触发条件——"当用户明确提到'钉钉'时加载,当用户只说'查人'而未指明平台时不要加载"。
启示6:缺"先写评估用例"这个环节
现状:新建 Skill 的流程是:理解需求 → 写 SKILL.md → 测试 → 上线。
问题:没有在写之前先定义"什么叫成功"。Perplexity 要求在 Skill 之前写好三类评估用例:真实用户查询、已知失败案例、邻域混淆场景。我们跳过了这一步。
改进:每个新 Skill 在动笔前,先列 5 个真实场景问题 + 3 个预期失败模式 + 3 个容易误触发的场景。写完 Smart 后,用这些用例逐条验证。
四、行动计划
基于以上分析,制定了一个分三阶段执行的优化计划:
🥇 第一阶段:立即执行(今天完成,零成本)
行动1:建立"陷阱飞轮"闭环
以后每次 Agent 执行任务失败或被用户纠正,执行以下标准动作:
1. 判断失败原因是否属于"Agent 缺了这个知识就会犯错"
2. 如果是 → 找到对应 Skill,在 SKILL.md 中新增 ## 已知陷阱 条目
3. 如果 Agent 根本没触发正确的 Skill → 收紧该 Skill 的 description
4. 记录到当天的 memory/YYYY-MM-DD.md
行动2:Description 统一改写规范
所有 Skill 的 description 改为统一句式:
"当用户需要 [具体场景/操作] 时加载。[负面条件:但不要在 X 场景下加载]。"
示例:
Before: "飞书多维表格的创建、查询、编辑和管理工具"
After:  "当用户创建或管理飞书多维表格(Bitable)、增删改查数据表记录、
         管理字段和视图时加载。不要在处理飞书文档或飞书消息时加载。"
🥈 第二阶段:一周内完成
行动3:Token Tax 全量审计
扫描 ~/.openclaw/workspace/it-engineer/skills/ 下所有 SKILL.md,用"删到只剩不该删的"标准逐文件审查:
– 删除模型已知的常识指令(git 基础操作、pip install、cd、ls 等)
– 删除"你应该仔细检查"、"请确保"等无效安全提示
– 删除示例代码中可以直接从 references/ 查阅的部分
– 保留触发条件、核心决策逻辑、已知陷阱、负面例子
行动4:三层结构改造
为每个高频 Skill 建立 references/ 目录:
– references/api-reference.md — API 详细文档
– references/format-spec.md — 数据格式规范
– references/examples.md — 完整示例
SKILL.md 瘦身到 2000 Token 以内,只留触发器 + 流程 + 陷阱。
🥉 第三阶段:长期机制
行动5:Skill 创建前置评估
制定并固化为规范:
– 新建任何 Skill 前,必须先输出一份"评估用例清单"
– 包含:5 个真实用户场景 + 3 个已知失败模式 + 3 个邻域混淆场景
– 用例通过 review 后才能开始写 SKILL.md
行动6:跨 Skill 冲突检测
随着 Skill 数量增长,不同 Skill 的 description 可能产生重叠触发。定期检查:
– 同一用户 query 是否可能同时触发多个 Skill
– 如果是,description 是否需要加入排他条件
– 引入"加载顺序"或"优先级"机制
五、总结
Perplexity 这份指南最有价值的地方,不是它给了什么模板或者 checklist,而是它定义了一个全新的思考框架:
Skill 不是让 AI 变聪明的工具,是让 AI 不犯错的护栏。
从这个框架出发,设计 Skills 的标准就变了——不是问"这个 Skill 能帮 AI 做什么",而是问"没有这个 Skill,AI 会在哪里翻车"。
对我们 OpenClaw 团队来说,最紧迫的三件事是:
1. 改描述——从功能摘要改为触发条件
2. 加陷阱——失败一次记录一次,不让同一个坑绊倒两次
3. 删废话——Token 不是免费的,只留 AI 真不知道的东西
这些都不是技术难题,是习惯的改变。而习惯的改变,从今天开始。