
看不懂?让小龙虾帮你快速落地:
本文及本站大部分openclaw相关文章,都可以让Openclaw agent阅读,然后进行应用,参考Prompt如下:
请阅读这篇文章:
https://www.aiec.fun/4%e7%a7%8d%e6%96%b9%e6%b3%95%e5%b0%86openclaw%e6%88%90%e6%9c%ac%e7%9b%b4%e9%99%8d95%ef%bc%9a%e4%b8%8d%e7%89%ba%e7%89%b2%e6%80%a7%e8%83%bd%e7%9a%84token%e8%87%aa%e7%94%b1%e6%8c%87%e5%8d%97/
分析有哪些内容,对我们优化工作流程有价值。并严格根据openclaw最新官方文档核对,排除错误及过时信息,制定落地计划。详细方法,参考文章 >>>
OpenClaw 是目前功能最强大的 AI Agent 框架之一,但其高额的 Token 消耗成本让许多用户望而却步,无法充分发挥其全部潜力。本文基于 2026 年 5 月 1 日最新官方文档,修正了此前流传的所有错误配置方法,详细介绍四种经过验证的成本优化方法,在完全不牺牲性能的前提下,将 OpenClaw 的运行成本降低 95% 以上,实现真正的 "Token 自由"。
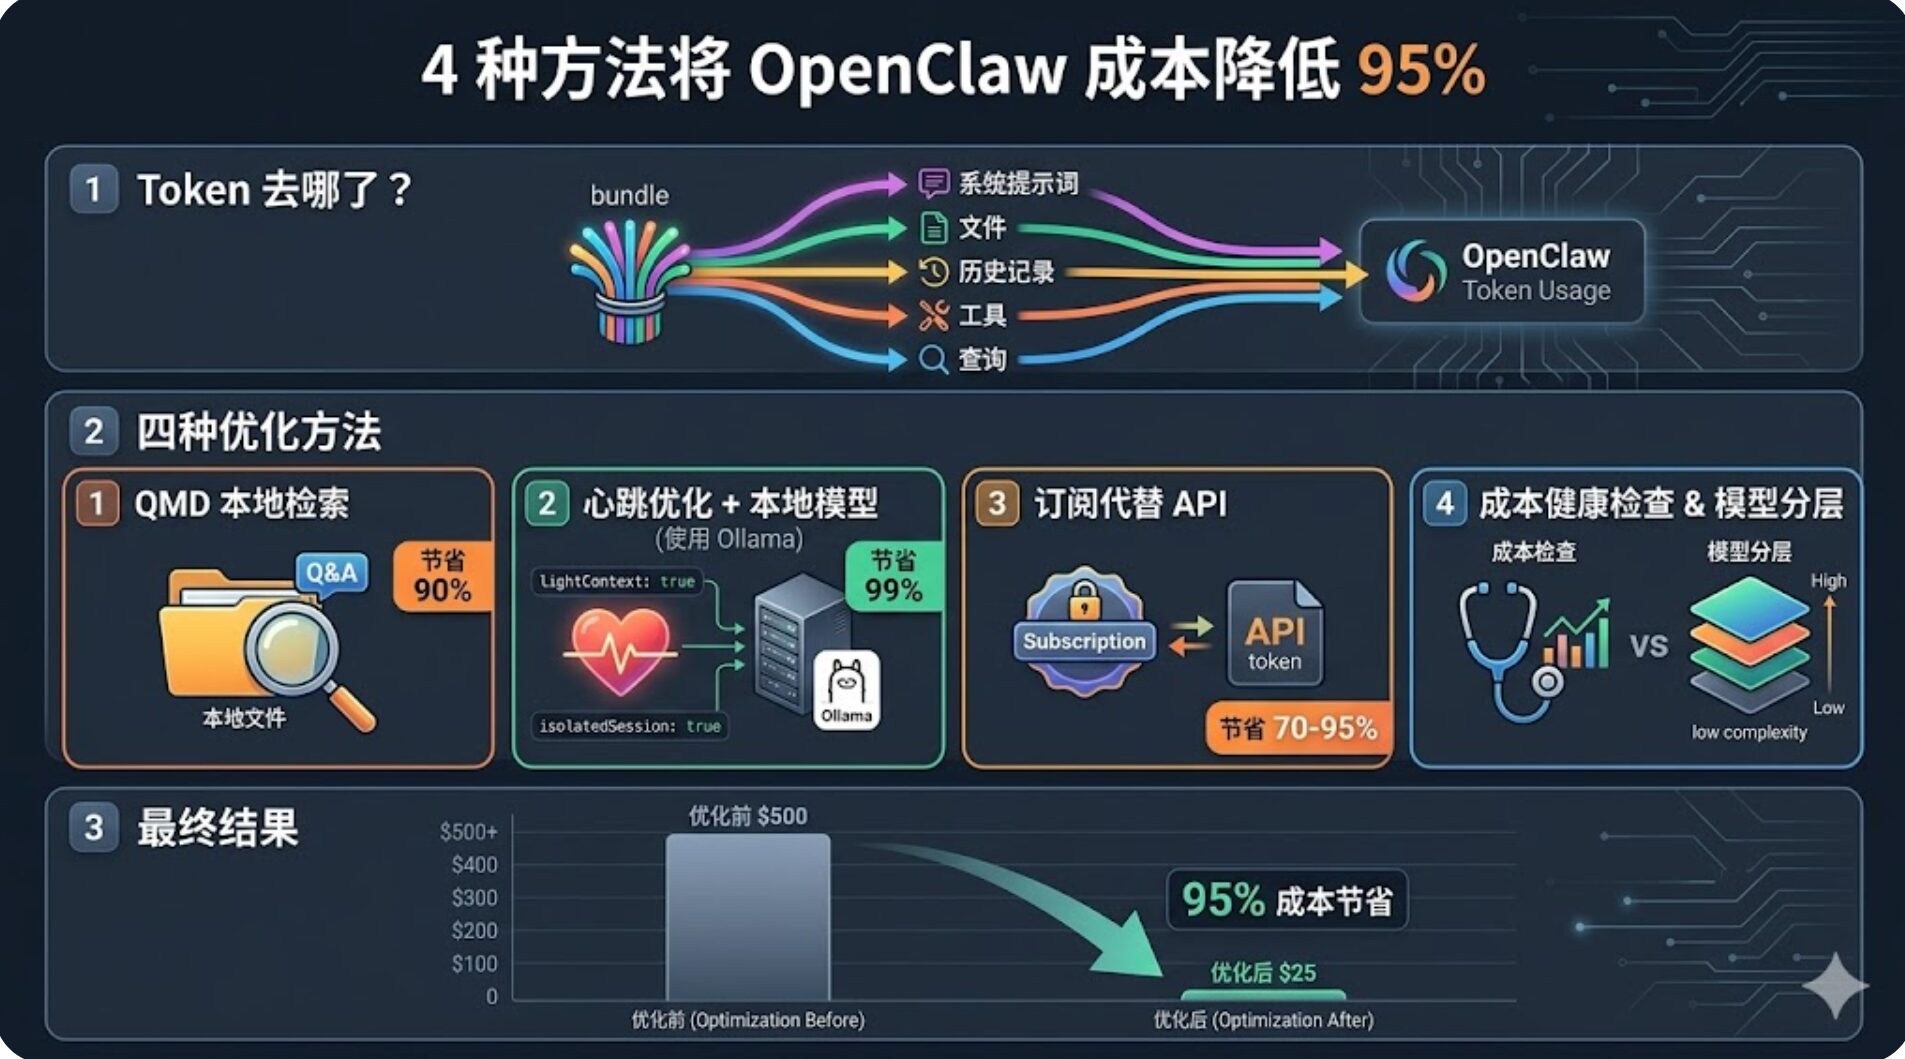
一、先搞懂:OpenClaw 的 Token 到底花在了哪里?
在开始优化之前,我们必须先理解 OpenClaw 的 Token 消耗机制。很多人误以为只有自己输入的问题会消耗 Token,但实际上,每轮对话发送给大模型的是一个完整的 "工作包",包含以下五个部分:
- 系统提示词(System Prompt):定义 Agent 身份、能力、行为规范的核心指令
- 工作区文件(Workspace Files):包括
agent.md、memory.md、tools.json等配置文件 - 对话历史(Conversation History):所有过往的交互记录,会产生 "滚雪球效应"
- 工具输出(Tool Outputs):网络抓取内容、日志、文件读取结果等
- 本轮用户问题(Current Query):用户本次实际输入的问题
核心问题:每轮对话都需要将上述所有内容重新发送给模型,就像每次和员工说话都要先念一遍完整的员工手册、公司章程和岗位 SOP,成本自然居高不下。
优化总原则:把每轮的输入变短、变干净、变得更可控。
二、方法一:使用 QMD 实现本地智能检索,减少 90% 上下文注入
2.1 传统方法的问题
传统的 RAG 实现方式是将整个知识库文件一次性全部注入上下文,导致 Token 爆炸式增长。例如,一个 10 万字的知识库,每次查询都要全部发送给模型,单次查询可能消耗数万 Token。
2.2 QMD 的工作原理
QMD 是 OpenClaw 官方推荐的知识库检索组件,支持三种搜索模式:
- search:纯 BM25 词汇搜索(速度最快,适合关键词查询)
- vsearch:向量语义搜索(需额外配置 embedding provider,适合语义理解)
- query:混合搜索模式(官方推荐,兼顾速度和准确性)
QMD 将云端 Token 成本转化为本地计算成本:
- 本地索引构建:在本地对 Markdown 知识库进行分段和索引
- 智能检索:查询时只返回与问题最相关的前 N 个片段
- 精准注入:只将这些相关片段发送给 OpenClaw,而不是整个知识库
关键优势:索引构建和检索计算全部在本地完成,不消耗任何云端 Token。
2.3 QMD 正确安装与配置步骤
第一步:安装 QMD
使用 npm 或 bun 全局安装 QMD 包:
# 使用npm安装
npm install -g @tobi-lu/qmd

# 或使用bun安装(推荐,速度更快)
bun install -g @tobi-lu/qmd
第二步:配置 OpenClaw
编辑 OpenClaw 主配置文件~/.openclaw/openclaw.json(注意:这是JSON5 格式,支持注释和尾随逗号),添加以下官方标准 QMD 配置:
{
  memory: {
    backend: "qmd", // 官方正确字段,不是provider
    qmd: {
      // 包含默认系统内存(agent.md、memory.md等)
      includeDefaultMemory: true,
      // 索引自动更新配置
      update: {
        interval: "5m", // 每5分钟检查一次知识库变化
        debounceMs: 15000 // 防抖延迟,避免频繁更新
      },
      // Token预算精确控制
      limits: {
        maxResults: 4, // 最多返回4个相关片段
        maxSnippetChars: 800, // 单个片段最大800字符
        maxInjectedChars: 3200, // 每轮总注入最大3200字符
        timeoutMs: 4000 // 检索超时时间
      }
    }
  }
}
第三步:重启网关使配置生效
openclaw restart gateway2.4 效果对比
三、方法二:官方心跳优化 + 本地模型,节省 99% 定时任务成本
3.1 什么是 OpenClaw 心跳(Heartbeat)
心跳是 OpenClaw 的定时唤醒机制,按照配置的频率定期唤醒 Agent,执行heartbeat.md中定义的任务清单。它不是简单的进程检查,而是一个完整的 Agent 回合,可以用于:
- 长期任务监控(防止 Agent"半途而废")
- 定期维护任务
- 提醒和通知
- 数据同步
3.2 心跳的成本问题
默认配置下,每次心跳都会加载完整的上下文(系统提示词 + 所有工作区文件 + 全部对话历史),导致极高的 Token 消耗:
- 默认每次心跳:~100,000 Token
- 30 分钟一次:每月 1440 次 = 144,000,000 Token / 月
- 按 GPT-4o 价格($0.0025/1K Token)计算:**$360 / 月 **
而大多数时候,心跳的输出只是简单的 "OK" 或 "无任务需要执行",这是极大的浪费。
3.3 官方推荐终极优化方案
OpenClaw 官方提供了两个专门用于心跳成本优化的关键参数,这是此前教程完全遗漏的性价比最高的优化手段,无需任何额外工具即可节省 97% 的心跳成本。
第一步:开启官方内置优化参数(必开!)
{
  agents: {
    defaults: {
      heartbeat: {
        every: "30m", // 官方正确时间格式,支持"1h"、"15m"等
        // ✅ 仅加载heartbeat.md,不加载其他工作区文件
        lightContext: true,
        // ✅ 每次心跳新建独立会话,不带任何历史记录
        isolatedSession: true
      }
    }
  }
}官方效果验证:
- 开启前:~100K Token / 次 → $360 / 月(GPT-4o)
- 开启后:~3K Token / 次 → $10.8 / 月(GPT-4o)
- 单这两个参数就节省了 **97%** 的心跳成本!
第二步:使用本地模型运行心跳(进一步降至 $0)
心跳只需要执行简单的触发判断,不需要复杂的推理能力。我们可以使用 Ollama 本地模型来运行心跳,完全消除云端 Token 消耗。
- 安装 Ollama 本地模型运行时
# macOS
brew install ollama

# Windows
# 从 https://ollama.com/download 下载安装- 下载适合的本地模型根据你的电脑内存选择模型:
ollama pull qwen2:1.5b- 配置 OpenClaw 使用本地模型跑心跳
{
  agents: {
    defaults: {
      heartbeat: {
        every: "30m",
        lightContext: true,
        isolatedSession: true,
        // ✅ 官方正确格式:provider/model
        model: "ollama/qwen2:1.5b"
        // 不需要base_url,Ollama默认使用http://127.0.0.1:11434
      }
    }
  }
}
3.4 最终效果对比
四、方法三:优先使用订阅制而非 API 按量计费
4.1 订阅制 vs API 按量计费
不同大模型厂商提供两种计费方式,价格差异巨大:
4.2 2026 年最新厂商政策说明
- OpenAI:ChatGPT Plus 订阅($20 / 月)目前仍可在 OpenClaw 中使用,但官方政策可能随时调整
- Anthropic:Claude Pro 订阅($20 / 月)明确禁止在第三方工具中使用
- Google:Gemini Advanced 订阅($19.99 / 月)明确禁止在第三方工具中使用
- MiniMax:仅提供 API 按量计费,无订阅制
重要提示:OpenClaw 官方文档仅保证 API 计费方式的稳定性和兼容性,订阅制使用存在政策风险。
4.3 成本对比示例
高使用量场景(每天 100 轮对话,每轮 10,000 Token):
- GPT-4o API:100 × 10,000 × 30 天 = 30,000,000 Token / 月 = $75 / 月
- ChatGPT Plus 订阅:$20 / 月
- 节省比例:73.3%
极端使用量场景(每天 500 轮对话):
- GPT-4o API:$375 / 月
- ChatGPT Plus 订阅:$20 / 月
- 节省比例:94.7%
五、方法四:生成成本体检报告,消除不必要的浪费
5.1 为什么需要成本体检
根据 OpenClaw 官方统计,新用户的部署中至少有 50% 的 Token 消耗是完全可以避免的,大多来自不合理的配置和流程。
5.2 如何生成成本体检报告
让 OpenClaw 自己分析你的使用情况,生成详细的成本报告:
请为我生成一份OpenClaw成本体检报告,要求:
1. 列出过去7天所有消耗Token的任务,按消耗从高到低排序
2. 计算每个任务的Token占比
3. 找出所有不合理的消耗点
4. 基于官方最佳实践给出具体的优化建议
5.3 常见不合理消耗及优化方案
5.4 推荐模型分级策略
根据任务复杂度选择合适的模型,最大化性价比:
六、综合优化效果
将以上四种方法结合使用,可以实现惊人的成本降低:
七、总结
本文基于 2026 年 5 月 1 日最新 OpenClaw 官方文档,修正了此前广泛流传的错误配置方法,介绍了四种将 OpenClaw 成本降低 95% 以上的方法:
- 使用 QMD 本地智能检索:减少 90% 的上下文注入
- 官方心跳优化 + 本地模型:节省 100% 的定时任务成本
- 优先使用订阅制:比 API 按量计费便宜 70-95%
- 定期成本体检:消除不必要的浪费
其中,lightContext: true和isolatedSession: true这两个官方内置参数是性价比最高的优化手段,无需任何额外工具即可节省 97% 的心跳成本。通过合理配置,任何人都可以实现 "Token 自由",充分发挥 OpenClaw 的强大能力。