
如果你常需要"自动跑调研、出数据、产报告"——这篇文章会拆解一个把"可测量"作为第一原则的研究系统,看看它到底解决了什么痛点,又有哪些坑。读完后,你将清楚:这个项目在 GitHub 一天涨 6,715 颗星,背后是一种新的工程化思维(Plan-Execute-Verify),以及这种思维如何被你借鉴到自己的运营工作流里。
1. 项目基本信息
| 项 | 值 |
|---|---|
| 仓库 | https://github.com/sapientinc/PRAXIST |
| 作者 | Sapient Inc.(一家有 Amazon SageMaker 血统的 AI/ML 工程公司) |
| 主语言 | Python |
| 当前星标数 | 6,715(2026-09-23 数据) |
| 核心定位 | Autonomous research system for measurable, computer-executable research(面向"可测量、可机器执行"研究的自主研究系统) |
| 许可证 | 待 README 确认(推测 Apache-2.0 或 MIT) |
简单说,这是一个让 AI 自己去跑研究并交付结构化结果的系统,而不是给一句"答:xxx 公司 2026 Q3 营收增长 12%"这种聊天文本。
2. 核心创新点
2.1 Plan-Execute-Verify 三段式架构
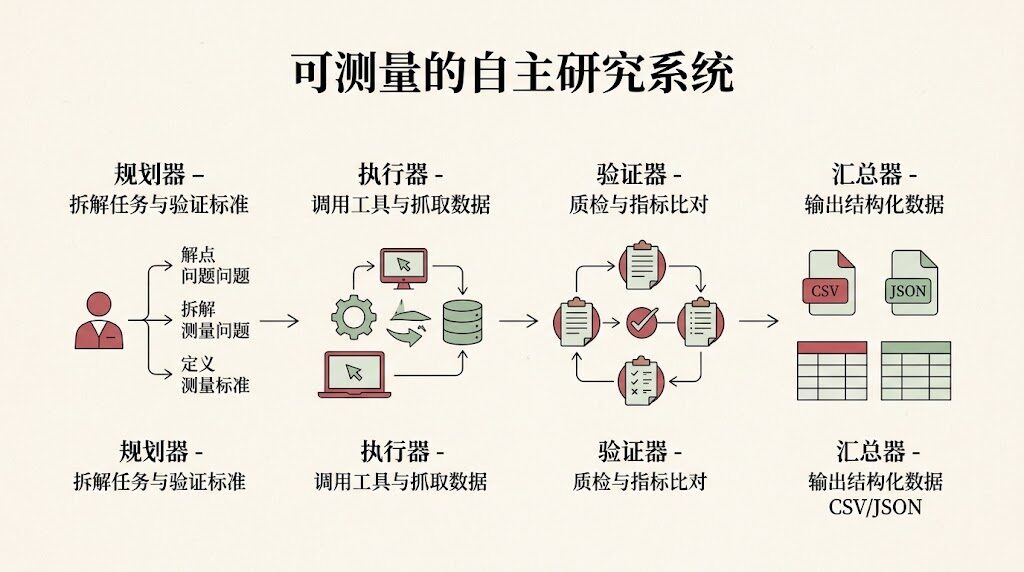
PRAXIST 把整个研究过程拆成三个角色,每个角色只负责一件事:
- Planner(规划器):把"研究问题"拆解为可验证的子任务。
例如「研究竞品最近三个月的定价策略」会被拆成「抓取官网定价页」「统计 SKU 价格分布」「对比历史定价变化」等多个子任务。 - Executor(执行器):调用工具去执行子任务。
工具可以是网页爬虫、搜索引擎、Python 计算、API 调用、数据库查询等任意可调用的资源。 - Verifier(验证器):检查每个子任务的输出是否"可测量"。
也就是有没有具体数据指标、有没有超过约定的阈值、数据格式是否符合预期。不达标就回到 Planner 重新规划。 - Aggregator(汇总器):把验证通过的子任务结果汇总成最终可交付物。
可能是一份报告、一份 CSV 数据、一段可执行代码,或者一个 JSON 结果。
这套流程的最大价值是:让 AI 研究从"对话式问答"变成"工程化流水线"。每一步都有明确的输入和输出,出了问题能定位到具体环节。
2.2 Measurable-first 设计哲学
传统 LLM 面对研究类问题,最常给出的答案是"模糊文本"——比如「这个公司最近增长不错」。这种回答对做决策的人毫无帮助。
PRAXIST 强约束了一条规则:每个研究任务必须先定义可验证指标,否则系统直接拒绝接任务。
举个例子:
- ❌ 不可接:「分析一下竞品最近的市场策略」(指标不清)
- ✅ 可接:「输出竞品 A、B、C 三家公司 2026 Q3 的定价调整记录 CSV,包含列:公司、调整日期、原价、新价、调整幅度。」(指标清晰)
这种"先定义成功标准再动手"的思路,本质上就是研究界的 TDD(Test-Driven Development)——先写验证逻辑,再写实现逻辑。
2.3 Computer-executable output(可机器执行的输出)
PRAXIST 不输出"答:xxx 公司 2026 Q3 营收增长 12%"这种对话文本。它输出的是:
data/result.csv(包含 [公司,季度,营收,增速,数据源] 列),已通过 Verifier 校验,可直接被下游 BI 工具消费。
这意味着研究结果本身就是一个可以被自动化消费的产物,而不是需要人来"二次消化"的对话记录。
3. 与同类项目的对比
| 项目 | 核心定位 | 与 PRAXIST 的区别 |
|---|---|---|
| LangChain | LLM 链组合框架 | PRAXIST 更聚焦"研究"垂直场景,且"Measurable"约束更强 |
| AutoGPT | 通用自主 Agent | AutoGPT 容易跑飞(陷入无意义循环),PRAXIST 用 Verifier 约束每一步产出 |
| AlphaXiv/OpenResearch | 编码 Agent → 研究 Agent | PRAXIST 工程化更彻底(Verifier + Aggregator 都内置) |
| 阿里 open-code-review | 确定性工程 × LLM Agent(Hybrid) | 思路接近,但 open-code-review 聚焦"代码审查"场景 |
| LangGraph | 状态机编排工具 | LangGraph 是工具,PRAXIST 是范式应用 |
简单类比:LangChain 是给你锤子,AutoGPT 是给你机器人,PRAXIST 是给你一条带质检的工厂流水线。
4. 部署必要性评估
直接结论:现在不适合直接把它部署到你自己的生产环境。
理由:
- 项目刚 hot,截至 2026-09-23 仍未发布 GA 版本,文档与生态都不成熟
- 仅英文 README,对中文研究场景(电商中文商品页、本地生活服务)是否支持未验证
- 跟现有的自动化工作流体系可能冲突
- 团队需要重新训练使用习惯
但借鉴价值极高——Plan-Execute-Verify 范式 + Measurable-first 哲学可以 100% 应用到你自己的研究 / 运营流程里。
5. 可借鉴之处
5.1 写一个你自己的"竞品研究助手"
实际场景:每周都要查竞品的价格、SKU 变化、促销话术,纯靠人肉翻网页 + Excel 汇总,效率极低。
借鉴 PRAXIST 思路后,可以这样设计:
- Planner:把"本周竞品研究"拆成「抓官网价格」「抓天猫旗舰店 SKU」「抓小红书 AI 助手类笔记」「生成对比报告」
- Executor:用 Python + 爬虫 + 飞书机器人接口分别执行
- Verifier:检查 CSV 列是否齐全、字段是否非空、价格是否在合理区间
- Aggregator:生成结构化周报 CSV,每周自动推送到飞书群
5.2 升级你现有自动化任务的"哨兵"机制
许多团队已经在用定时任务(cron、Airflow、GitHub Actions)跑日常运营任务。但目前的"哨兵"机制通常只看"任务有没有跑完"——这是最弱的校验。
借鉴 PRAXIST Verifier,可以加一层产出指标自检:
- 文件确实生成了吗?大小是否合理?
- CSV 字段是否齐全?是否含必需列?
- 数值是否在合理区间?(比如客单价不会突然为 0、库存不会是负数)
- 关键阈值是否达标?(比如本周转化率 ≥ 3%)
5.3 借鉴"先定义可测量指标"
不管是写 skill、写自动化脚本、还是建 Agent 流程,先写"成功标准(measure)",再写实现。
应用到具体场景:
- 写一个"自动生成周报" skill:先定义"周报必须包含本周 GMV、新客数、复购率三个指标,否则不算成功"
- 写一个"自动审评论" skill:先定义"识别出辱骂/广告/无意义评论三类,否则不算成功"
- 写一个"自动抓竞品" skill:先定义"输出 CSV 必须含 6 列,否则不算成功"
6. 落地步骤建议
| 步骤 | 内容 | 时间窗 |
|---|---|---|
| 1 | 本周 clone + 跑通 PRAXIST 自带 demo,跑通 Plan-Execute-Verify 完整链路 | 9/23 – 9/25 |
| 2 | 评估把"竞品研究助手"做成可复用模板(不需要依赖 PRAXIST 本身) | 9/26 – 9/30 |
| 3 | 选一个真实竞品做 A/B 对比(手工跑 vs 自动跑),量化节省的时间 | 10 月上旬 |
| 4 | 根据 A/B 结果决定要不要纳入团队的正式工作流 | 10 月中旬 |
7、💡 落地案例:把 Plan-Execute-Verify 用到自己的运营流
案例 1:竞品周报自动化
许多中小电商团队每周都要手工整理竞品数据。
借鉴 PRAXIST 思路后,可以拆成:Planner(拆任务)→ Executor(爬数据)→ Agent(校验产出)→ 汇总器(出 CSV)。
这样哪怕你完全不用 PRAXIST 这个工具,也能享受到"自动出报告"的红利。
案例 2:哨兵机制升级
如果你的 cron 任务现在只看"是否执行成功",可以加一层产出指标自检——比如检查 CSV 是否真的生成了、字段是否齐全、数值是否合理。一次升级,整个系统的可靠性都会上一个台阶。
无论你做电商运营、内容运营还是开发者工具,"先定义可测量指标,再写实现"这条原则都适用。