
你以为 prompt 越长 AI 越懂你,其实恰恰相反——prompt-master 的核心理念就一句话:The best prompt is not the longest. It's the one where every word is load-bearing.(最好的 prompt 不是最长的,而是每个词都"承重"的。)这篇文章会介绍这个 Claude Skill 怎么用、能用到哪、不能用到哪,以及它和 6 个真正在做 prompt 自动优化的工具,到底差在哪。
为什么你的 prompt 总是越写越长
我最近在整理 Claude、OpenClaw 这类工具的使用经验时,撞上一个很常见的现象:
- 同一个问题,问 ChatGPT 和问 Claude 写法不能一样
- 写代码给 Cursor 和画图给 Midjourney 的 prompt,结构完全是两套语言
- 改 prompt 改到第 5 版,自己都忘了哪些 token 是必要、哪些是"为了安心"
- 写了一条"看起来很专业"的 prompt,结果 o3 / DeepSeek-R1 反而变笨了——因为它们本来就会推理,你给它的 CoT 提示词是噪音
prompt-master 要解决的,就是这套"到处抄提示词模板、抄完也不一定对"的日常。
它的项目自述一句话讲清楚立场:
"A Claude skill that writes the accurate prompts for any AI tool. Zero tokens or credits wasted."
——一个为任何 AI 工具写"准确"prompt 的 Claude Skill。不浪费一次 token 或一次额度。
prompt-master 是什么
先讲一个反直觉的事:它不是一个程序,不是一个 CLI,不是一个 Web 服务。
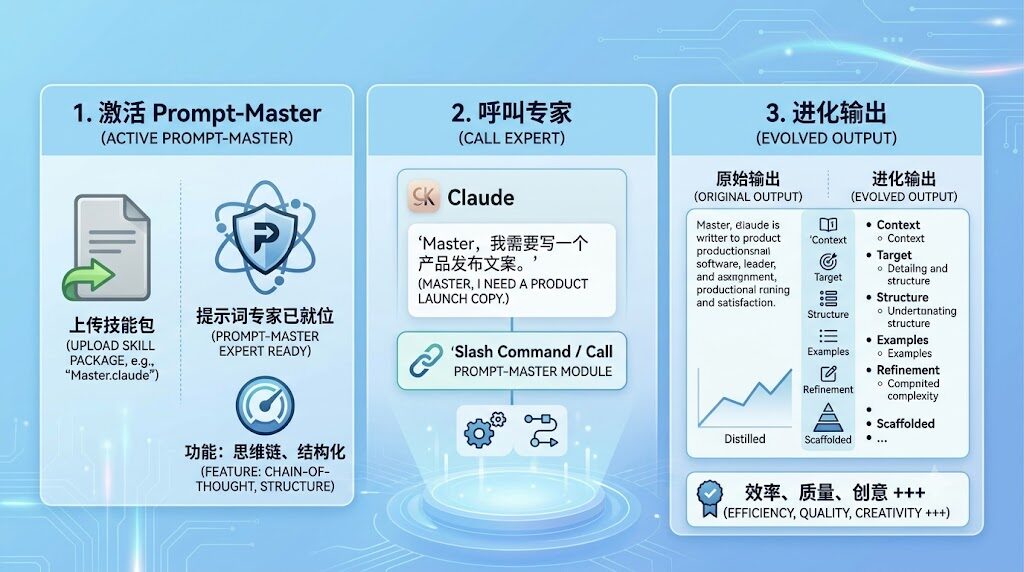
prompt-master 本质是一个 Claude Skill,由 SKILL.md 和 references/ 目录里的参考文档组成。你把它放进 Claude 的 Skills 体系里,Claude 就会在需要时把它当作"调用"对象——你用自然语言告诉它你要写什么 prompt,它会按一套规则帮你产出可直接复制的成品。
仓库根目录只有四项:
prompt-master/
├── SKILL.md          # 主技能定义(frontmatter + 三区执行逻辑)
├── references/       # 12 套模板、35 个反模式等按需加载的参考文档
├── README.md
└── LICENSE
它的版本号目前是 v1.7.0(写在 SKILL.md 的 frontmatter 里)。整个仓库只有 53 个提交,是一个"精炼优先"的小型项目。
它解决的具体问题,作者在 README 的开篇写得很直白:
🔥 解决什么问题:
- 写一段给 ChatGPT 的 prompt,去到 Claude 就不灵了
- 写一段 prompt 反复"再调一遍、再加一句"直到超长
- 写 prompt 像猜谜,每个 token 都在赌
- 写给 o1 / o3 的 prompt 反而被自己加的"一步一步想"拖慢
- 写完 prompt 还要再去搜"为什么 AI 不按我说的做"
它到底怎么工作
SKILL.md 把整个执行过程拆成三个"区域"(PRIMACY / MIDDLE / RECENCY),对应到一次任务中的"身份与硬规则 → 执行逻辑 → 验证收尾"。
第一步:识别目标 AI 工具
这是它的硬规则第一条:
"Never produce a prompt until the target tool is confirmed."
——没确认目标工具之前,不许输出 prompt。
这一步由 Universal Fingerprint 机制兜底:你说"帮我写个 prompt",但没说给谁用,它会最多追问 3 个澄清问题(也是硬规则),然后在 30+ 内置工具 profile 里匹配一个最接近的,再按该工具的写法去改写。
内置的 30+ 工具 profile,按场景分大致是:
- 推理 LLM:
Claude(Opus 4.8)、ChatGPT/GPT-5.x、Gemini 3 Pro、o3/o4-mini、DeepSeek-R1、Qwen2.5/Qwen3、本地 Ollama、Mistral/Llama - Agentic / IDE:
Claude Code、Cursor、Windsurf、Cline、GitHub Copilot、Antigravity - 全栈生成器:
Bolt、v0、Lovable、Figma Make、Google Stitch - 自主代理:
Devin、SWE-agent、Manus - Computer-use 代理:
OpenAI Computer Use、Perplexity Computer、OpenClaw Agents - 图像 AI:
Midjourney、DALL-E 3、Stable Diffusion、ComfyUI、SeeDream - 3D / 视频 / 语音 / 工作流:
Meshy、Tripo、Rodin、Unity AI、BlenderGPT、Sora、Runway、Kling、LTX、Dream Machine、ElevenLabs、Zapier、Make、n8n
如果遇到列表外的工具,Universal Fingerprint 会用 4 个固定问题适配任意未见过系统。
第二步:九维度需求梳理
执行时先静默跑一遍这套清单,再决定要不要追问:
| 维度 | 提取内容 | 何时必抓 |
|---|---|---|
| Task | 具体动作 | 总是 |
| Target tool | 目标 AI 系统 | 总是 |
| Output format | 形状 / 长度 / 结构 | 总是 |
| Constraints | 必须 / 禁止 | 复杂时 |
| Input | 用户附带输入 | 适用时 |
| Context | 域 / 项目状态 | 有历史时 |
| Audience | 读者技术层级 | 面向用户时 |
| Success criteria | 二元成功标准 | 复杂时 |
| Examples | 输入 / 输出对 | 格式关键时 |
关键点:这一步不输出给用户。模型自己消化完,再决定是否追问。
第三步:选模板 + 套安全技巧
references/templates.md 里存了 12 套自动选择的模板(M/A-G-H-J-K-L 等),按任务类型和工具特征自动选。
SKILL.md 的硬规则里明确禁用了几个"听起来很高级但单 prompt 风险大"的技术:MoE、ToT、GoT、Universal Self-Consistency。它只用稳妥技术——角色分配、Few-shot 示例、XML 结构、grounding anchors、Memory Block。
第四步:关键的反模式排查
references/patterns.md 整理了 35 个"耗 credit 模式"(反模式),按失败原因分六类:
- Task failures:模糊动词、双任务合一、无成功标准、情绪化描述、范围过大
- Context failures:假设先验知识、引诱幻觉、未提已尝试
- Format failures:无格式 / 长度 / 角色 / 美学规范
- Scope failures:无文件边界、无停止条件、全代码库粘贴
- Reasoning failures:给推理模型加 CoT
- Agentic failures:无起点 / 终点状态、静默 agent、无人类审查触发
这些是它每次改写时会逐项排查的 checklist。
第五步:推理模型不加 CoT
这是一个特别值得展开的硬规则:
"Never force CoT on reasoning-native models (o3, o4-mini, DeepSeek-R1, Qwen3 thinking)."
对 o3、o4-mini、DeepSeek-R1、Qwen3 thinking 这类原生会推理的模型,prompt-master 不会在 prompt 里强行加"请一步一步想"
——它们已经会了,多此一举反而会拖慢、还会让 DeepSeek-R1 之类默认输出 <think> 标签污染结果。
第六步:Token 效率审计
SKILL.md 的 RECENCY 区有一段 6 步交付前验证,核心目的就是拒绝任何没必要的句子。这呼应了它的整体哲学:好 prompt 不靠长度,靠每个词都"承重"。
第七步:交付
最终给你的输出结构是:
- 一个可直接复制粘贴的 prompt 块
- 紧跟一行 🎯 Target + 💡 一句话说明
- 仅在必要时附 1-2 行设置说明(不主动啰嗦)
附带一个 Memory Block 机制,把当前任务里的 stack、架构决策、约束、已经试过并失败的方案沉淀下来,下次同一项目再写 prompt 时会带上,避免"你之前定好的规则这次又让我重新决策"。
在 Claude 上怎么用
这是它的官方推荐方式——SKILL.md 本身是为 Claude Skills 体系设计的,Anthropic 已经把 Agent Skills 作为开放标准发布(agentskills.io),Claude.ai、Claude Code、Claude Agent SDK、Developer Platform 都已支持。
推荐路径(Claude.ai 浏览器):
- 下载仓库 ZIP
- claude.ai → 侧边栏 → Customize → Skills → Upload a Skill
- 上传后,对话中直接用自然语言描述需求即可
备选路径(Claude Code):
README 明确标注 Not Suggested(不建议),但如果你坚持要本地用:
mkdir -p \~/.claude/skills
git clone https://github.com/nidhinjs/prompt-master.git \~/.claude/skills/prompt-master使用示例(直接说人话):
- "为 Cursor 写一个重构认证模块的 prompt"
- "修复这条写给 GPT-4o 的低质量 prompt"
- "生成一条 Midjourney v7 的图像 prompt"
- "我想让 Claude 帮我写技术博客的 prompt,工具选 Claude"
- 也可以显式
/prompt-master起头再描述任务
关键信息缺失时,它会最多追问 3 个问题,然后给出可直接复制的成品。
在 OpenClaw 上能不能用
简短结论:能,而且 prompt-master 已经为它写了专门的工具 profile;但"自动 prompt 优化"这个边界要看清。
OpenClaw 兼容 Claude Skills 吗
兼容。 OpenClaw 官方文档明确表示 Skills 遵循 AgentSkills 规范(这是 Anthropic 2025-12-18 把 Skills 发布为开放标准后的同一份规范)。最简结构就是带 frontmatter 的 SKILL.md:
---
name: image-lab
description: Generate or edit images via a provider-backed image workflow
---

When the user asks to generate an image, use the `image_generate` tool...也就是说,prompt-master 的 SKILL.md 在格式上和 OpenClaw 的 Skills 体系是直接可移植的。
OpenClaw 加载 Skill 的优先级(高 → 低):
| 优先级 | 来源 | 路径 |
|---|---|---|
| 1 | Workspace skills | <workspace>/skills |
| 2 | Project agent skills | <workspace>/.agents/skills |
| 3 | Personal agent skills | \~/.agents/skills |
| 4 | Managed / local skills | <state-dir>/skills |
| 5 | Bundled skills | 安装自带 |
| 6 | Extra directories | skills.load.extraDirs + plugin |
只要你把 prompt-master 放到上述任一目录,OpenClaw 就会在会话开始时把它加入技能清单。
也可以走官方安装命令:
openclaw skills install git:nidhinjs/prompt-master⚠️ OpenClaw 官方原话:
"Treat third-party skills as untrusted code. Read them before enabling."(把第三方 Skill 当作不信任的代码看待)。
prompt-master 仓库只有 53 个提交、代码量极小(一个 SKILL.md + references 文档),审计成本很低。
prompt-master 视角的 OpenClaw
在 SKILL.md 的"Computer-Use 代理"工具列表里,OpenClaw 与 Perplexity Comet、OpenAI Atlas、Claude in Chrome 并列,对它的描述是:
为 OpenClaw 写 prompt本身就是 prompt-master 明确支持的输出目标——你可以在和 Claude 的对话里直接说"为 OpenClaw 写一条 XXX 的 prompt",它会自动套用 OpenClaw 的 profile。
"自动 prompt 优化"的边界
要说清一件事:prompt-master 是"专家规则 + LLM 单次改写"式的优化,每次按最佳实践帮你重写一条 prompt,效果立竿见影,但没有"评估数据集 → 打分 → 自动迭代搜索"的闭环。
如果你要的是:
- 可量化的"线上 prompt 准确率从 78% 提到 90%"
- 可批量回归测试
- 可复现的优化过程
——这不是 prompt-master 的菜,那是下一节里 DSPy、PromptWizard、Opik 的菜。
6 个真正在做 prompt 优化的工具,和 prompt-master 怎么对比
把目前主流的 prompt 优化工具按"优化方式"分一下类,prompt-master 属于第一类,但你要做"自动优化"就得往下选:
| 工具 | 类型 / 开源 | 优化方式 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|---|---|
| prompt-master | Claude Skill(MIT) | 专家规则 + LLM 单次改写 | 个人日常、跨多工具写 prompt | 零门槛、即装即用、覆盖面广 | 无评估闭环,不可批量回归 |
| DSPy | 开源 Python 框架(37k stars,7.5M+ 月下载) | 编译器式自动优化(MIPROv2、GEPA 等),用数据集 + 评分函数自动搜索最优 prompt | 生产级 LLM 管线、RAG/Agent 程序 | 真正的自动化、可复现;Shopify/Databricks/Dropbox 在产线用 | 学习曲线陡,需 Python ≥3.10 + 示例集 + 评分指标;优化耗算力 |
| Promptfoo | 开源 CLI / 平台(23.9k stars) | 评估 / 红队 / 变体对比 + 修复建议 | 团队 CI 回归、安全测试、prompt 版本对比 | YAML 配置简单、CI 友好、红队能力强、156 家财富 500 强在用 | "自动 prompt 优化"非主打;偏安全测试和验证 |
| TextGrad | 开源(Stanford 学术项目) | "文本梯度反向传播",用 LLM 反馈迭代优化 prompt/代码 | 研究实验、复杂任务调优 | PyTorch 风格接口、LeetCodeHard +20%、GPQA 51%→55% | 偏学术、工程化成熟度一般 |
| Opik(Comet) | Apache-2.0 全栈开源 + 自托管 | 追踪 + 评估 + Opik Agent Optimizer SDK 自动优化 prompt/agent | 想要开箱即用自动优化框架的团队 | 开源免费、自托管、框架无关、40M+ traces/天规模 | 社区相对新;具体优化器算法成熟度需看 release notes |
| PromptWizard | 微软开源(MIT,\~4k stars) | 任务感知的 prompt 自动优化(反馈驱动精炼 + 合成示例 + 自生成 CoT) | 学术 / 企业研究、数学推理 / BBII 等基准 | 论文背书、自带 GSM8k/SVAMP/AQUARAT/BBII demo | 单数据集优化 20-30 分钟,需 LLM API 配额 |
还有一类是"Prompt 版本管理与可观测性平台"
——PromptLayer、PromptHub、Promptmetheus、Helicone、Arize Phoenix 等,它们的强项是协作、版本管理、可观测,自动 prompt 优化通常不深。如果你需要"非工程人员也能参与 prompt 治理",看这一类。
选型一句话建议
- 个人日常、不想写代码 →
prompt-master这类 Skill 就够了 - 需要在 CI 里做 prompt 回归测试 + 红队评估 →
Promptfoo - 有评估数据集、想让机器自动搜索最优 prompt 的生产管线 →
DSPy(目前公认最成熟的路线) - 想要追踪 / 评估 / 自动优化一体的开源平台 →
Opik - 做数学推理 / BBII 类的研究或企业级任务优化 →
PromptWizard - 团队协作 + 版本治理 + 跨人协作 →
PromptLayer / PromptHub / Promptmetheus - 想体验"文本梯度"这种新范式 →
TextGrad
一个常见的组合打法:用 prompt-master 快速产出初版 prompt → 用 Promptfoo 在 CI 里做回归和红队 → 用 DSPy 在生产环境上基于真实流量做指标驱动的自动迭代。三段式覆盖了"从无到有 → 安全可信 → 持续优化"的完整链路。
安装与使用方法(给真要上手的人)
1. Claude.ai(推荐)
# 1. 下载 ZIP
# 2. claude.ai → 侧边栏 → Customize → Skills → Upload a Skill
# 3. 上传 prompt-master 目录里的 SKILL.md 和 references/
上传后直接说:"帮我给 Cursor 写一个重构用户认证模块的 prompt,要避免改动数据库迁移文件" —— 它会自动识别 Cursor,套 agentic profile,给出可直接复制的成品。
2. Claude Code(不推荐,但可用)
mkdir -p \~/.claude/skills
git clone https://github.com/nidhinjs/prompt-master.git \~/.claude/skills/prompt-master
README 自己写了 "Not Suggested"——因为 Claude Code 原生的 skills 机制和 Claude.ai 的 Skills 体系不是 1:1 对齐,部分触发逻辑会有差异。日常用 Claude.ai 装最稳。
3. OpenClaw
# 把仓库放到 skills 加载路径之一
git clone https://github.com/nidhinjs/prompt-master.git \~/.agents/skills/prompt-master

# 或者用官方安装命令
openclaw skills install git:nidhinjs/prompt-master
提醒:OpenClaw 官方建议把第三方 Skill 当作"untrusted code",先读后用。
prompt-master仓库只有SKILL.md+ 几个 markdown 文档,没有可执行脚本,审计成本极低。
4. 使用技巧
- 明确说目标工具:"给 Claude 写 / 给 Cursor 写 / 给 OpenClaw 写" —— 触发最准确的 profile
- 用"修复"句式:"修复这条 prompt" → 自动跑 35 个反模式排查
- 要 Memory:同一次会话里多次写 prompt 时,前面沉淀的 stack / 决策 / 已失败方案会自动带到下一条
- 不要强求 CoT:给 o3 / DeepSeek-R1 写 prompt 时,明确说"不要在 prompt 里加 step-by-step",它会遵守
它适合谁、不适合谁
适合
- 每天在多个 AI 工具间切换的人:写代码 agent、画图、视频、语音、办公自动化
- 不打算深入研究 prompt 工程,但要稳定拿到好结果的"效率型"用户
- 想给团队 / 客户做 prompt 模板的人:12 套模板 + 35 个反模式是现成的内部培训材料
- OpenClaw / Claude Code 用户:本地有 Skills 体系、需要节省 token 又想拿稳结果
不适合
- 要指标驱动的批量优化——去找 DSPy
- 要 CI 里的 prompt 回归 + 红队——去找 Promptfoo
- 要 prompt 的可观测和版本管理——去找 Opik / PromptLayer / Helicone
- 要学术研究 / 新范式探索——去看 TextGrad / PromptWizard
写在最后
prompt-master 解决的是一个"今天就要用、明天还要用、每天用 20 次"的痛点。它不打算替代 DSPy 的自动优化器,也不打算替代 Promptfoo 的红队框架——它的野心小很多,就是在你下一次想复制粘贴一段 prompt 之前,省你 10 分钟、几个 token、几次重试。
如果你正在用 Claude,或者刚把 OpenClaw 装上,今天花 5 分钟把 prompt-master 上传为 Skill,明天的第一条 prompt 你就能感觉到区别。
一句话总结:好 prompt 不是更长的 prompt,是每个 token 都在做事的 prompt。
附录:本文引用与可核实来源
prompt-master仓库:https://github.com/nidhinjs/prompt-masterprompt-master的SKILL.md(v1.7.0):https://github.com/nidhinjs/prompt-master/blob/main/SKILL.md- Anthropic Agent Skills 介绍:https://www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills
- Agent Skills 开放标准:https://agentskills.io/
- OpenClaw README:https://github.com/openclaw/openclaw
- OpenClaw Skills 文档:https://docs.openclaw.ai/tools/skills
- DSPy 官方站:https://dspy.ai/
- Promptfoo 官方站:https://www.promptfoo.dev/
- TextGrad 官方站:https://textgrad.com
- Opik 项目:https://github.com/comet-ml/opik
- PromptWizard:https://github.com/microsoft/PromptWizard(Agarwal et al., 2024, arXiv:2405.18369)