yetone/magpie:把Claude Code、Codex等69个AI Agent的模型收进一个本地网关
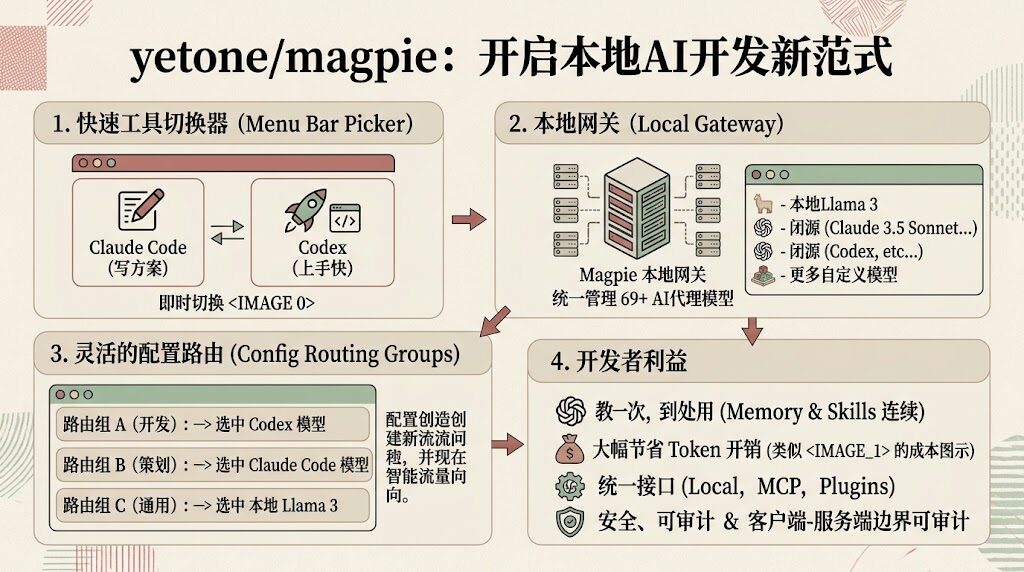
yetone/magpie 24,773 星:本地网关统一 69 个 AI Agent 的模型路由,支持额度自动切换、意图路由和请求出网前隐私掩码。

aiec.fun
yetone/magpie 24,773 星:本地网关统一 69 个 AI Agent 的模型路由,支持额度自动切换、意图路由和请求出网前隐私掩码。
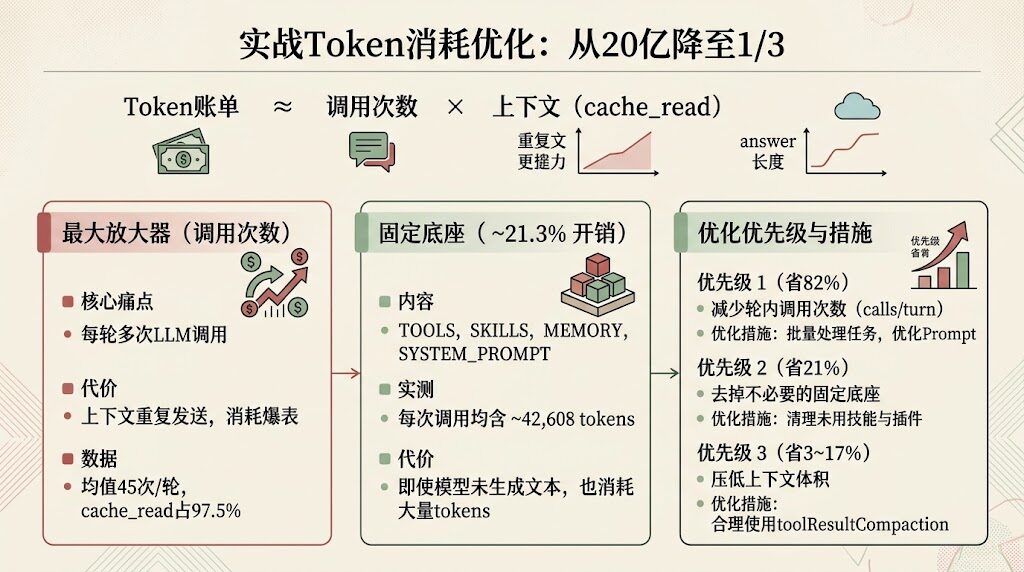
27.6 天、40,436 次模型调用烧掉 80.8 亿 tokens,97.5% 花在重复上下文上。实测证明放大器是调用次数(37.2 倍)而非上下文膨胀,附技能与 MCP 回收清单、配置收紧方案。
vllm-project/vllm 是 UC Berkeley 出品的高吞吐 LLM 推理引擎,9.5 万星。本文讲清 PagedAttention、连续批处理、前缀缓存等核心机制,对比 SGLang/TensorRT-LLM/llama.cpp,给出安装部署命令、选型建议与 8 条可迁移的工程思路。
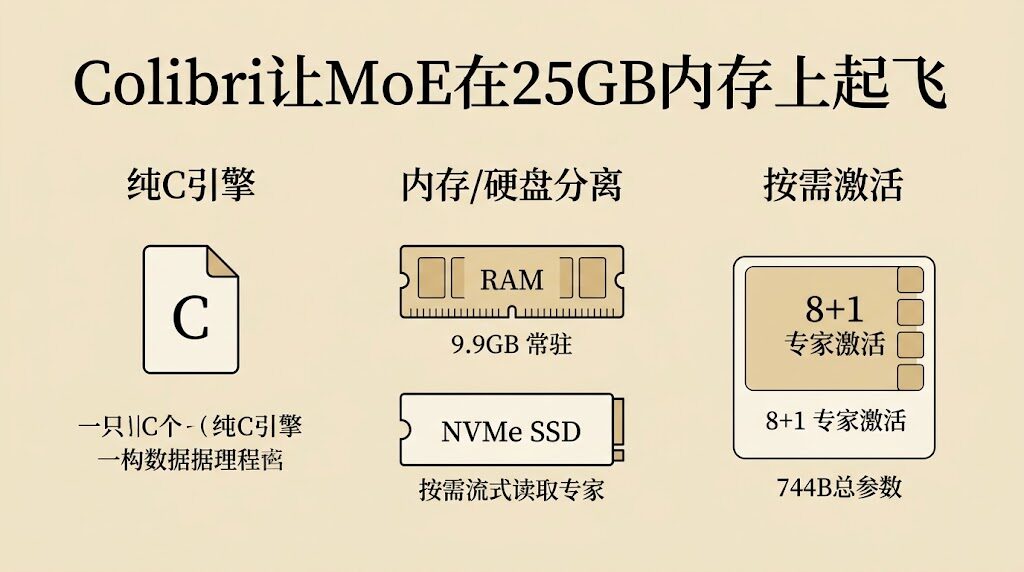
JustVugg/colibri 用纯C语言实现零依赖的MoE推理引擎,将744B参数的GLM-5.2模型部署到仅有25GB内存的消费级设备,通过「磁盘换内存」的三档分层架构(VRAM/RAM/SSD)让超大MoE模型在本地流畅运行。冷启动32秒、常驻<10GB、Apache 2.0开源。本文从机制、性能、横向对比、架构启示四维度拆解。
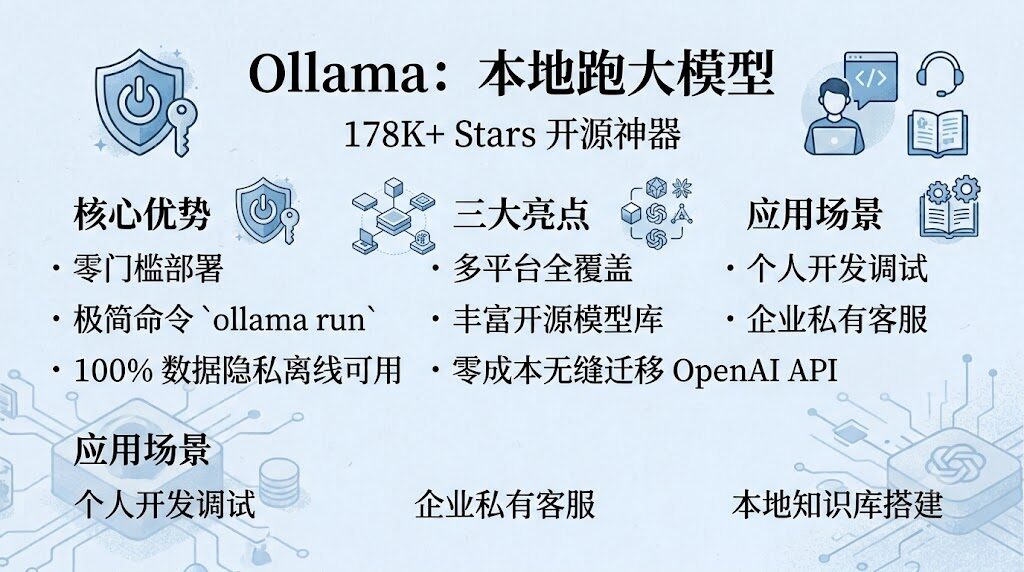
本文介绍 GitHub 178K 星开源项目 Ollama,让你在本地一键跑 Kimi-K2.6/GLM-5.2/Qwen/DeepSeek 等主流大模型,电商团队可私有化部署 AI 客服,数据不出服务器。
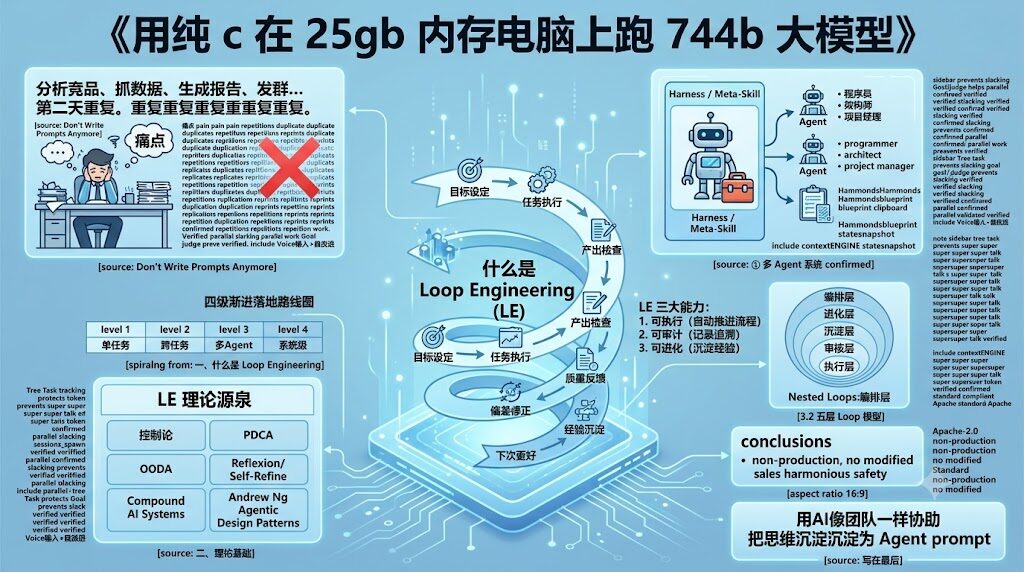
JustVugg/colibri 用单文件纯 C 引擎把 GLM-5.2 (744B MoE) 装进 25GB 内存笔记本:MoE 稀疏激活 40B/次、19,456 expert 流式加载、MLA 把 KV 压到 576 floats/token(57× 缩小)、MTP 投机解码提速 2.2-2.8×。22 天拿 17K⭐。本文拆解原理、硬件分层、同类对比与上手步骤。
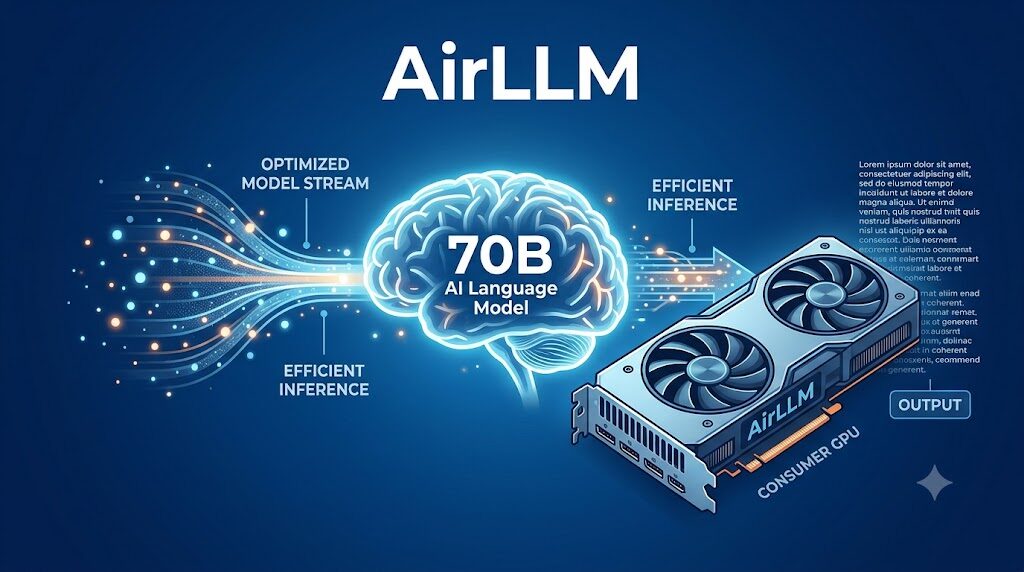
AirLLM 通过非均匀块量化 + 流式内存管理,让 4GB 显存消费级 GPU 也能推理 70B 大模型。本文拆解四大核心技术,对比 vLLM / llama.cpp 等同类方案。
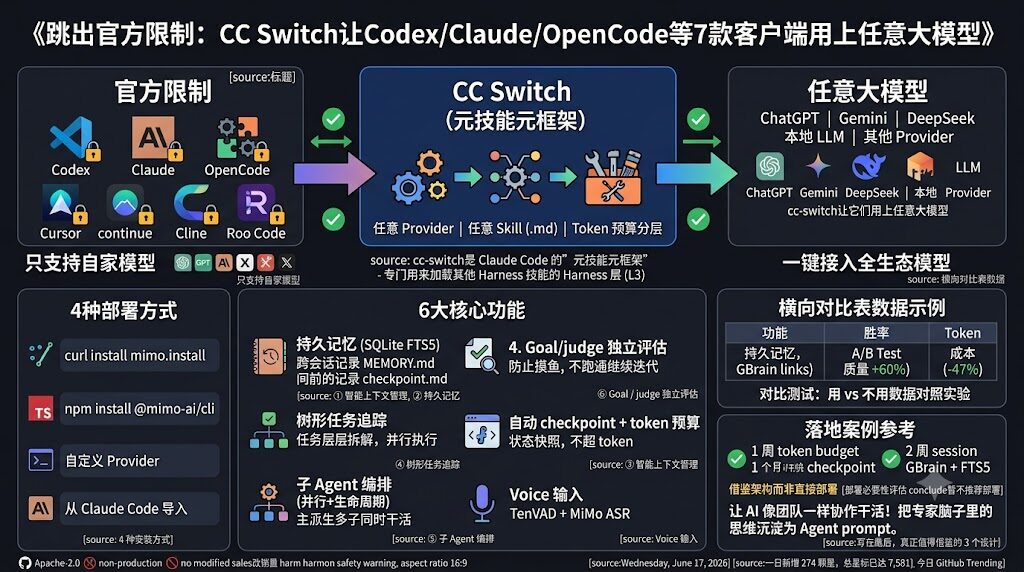
CC Switch是一款免费本地 AI 代理网关,让 Codex、Claude、OpenCode 等 7 款客户端突破官方格式限制,统一接入任意大模型,集中管理密钥、用量与成本。
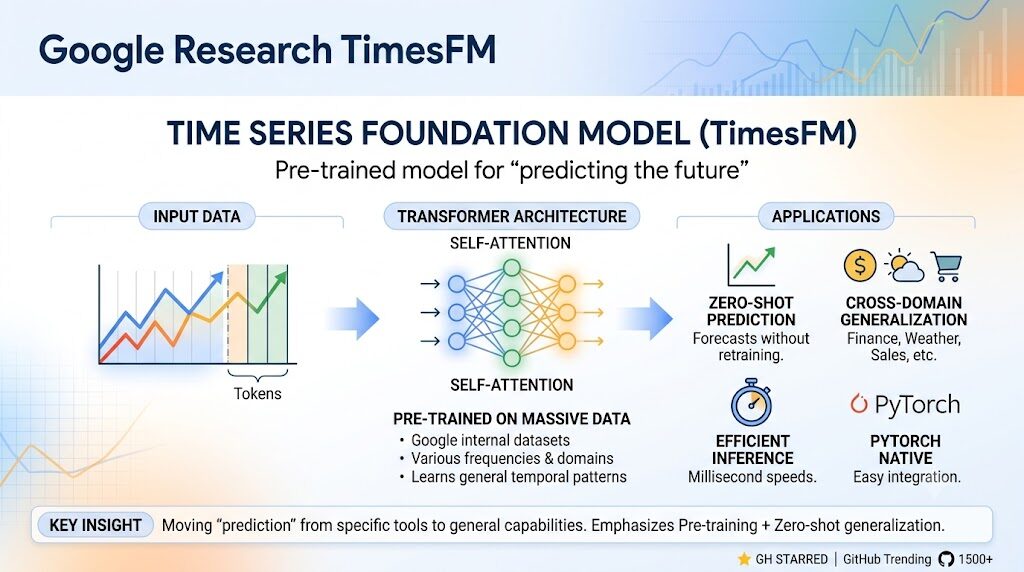
Google Research开源的时间序列基础模型TimesFM,支持零样本预测与跨领域泛化。本文深度解析其Transformer架构、性能表现及电商场景应用前景。
Openclaw 是当下极具代表性的开源 AI Agent 框架,因以龙虾为标识,被开发者形象地称作 "养龙虾"—— 它能部署在本地电脑 24 小时自主运行,突破了传统大语言模型(LLM)"只动口不动手" 的局限,可自主完成创建平台账号、制作视频、执行电脑操作等全流程任务。本文将以 Openclaw 为核心案例,拆解 AI Agent 的底层运作逻辑、核心机制、实操案例及安全风险,让你从零开始理解 AI Agent 的工作原理。
基于百度千帆 OpenClaw 的实战应用逻辑,从核心能力解析、场景化实战演示、部署配置指南到安全最佳实践,进行全方位拆解。无论你是个人用户、自媒体从业者、企业办公人员还是科研人员,都能通过本教程掌握 OpenClaw 的完整使用流程,让 AI 真正成为 "可落地执行任务的数字员工"。
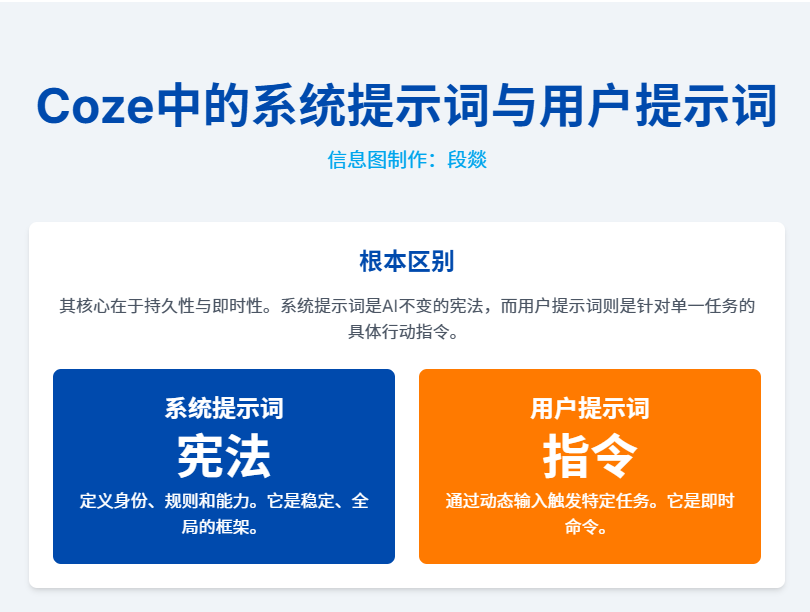
在扣子的工作流中,系统提示词和用户提示词是模型节点中的关键配置项。而这两者的区别,让很多人困惑。这两者分工明确、协同运行,共同控制大模型的输出逻辑。