实战Token消耗优化:帮你节省2/3的大模型花费
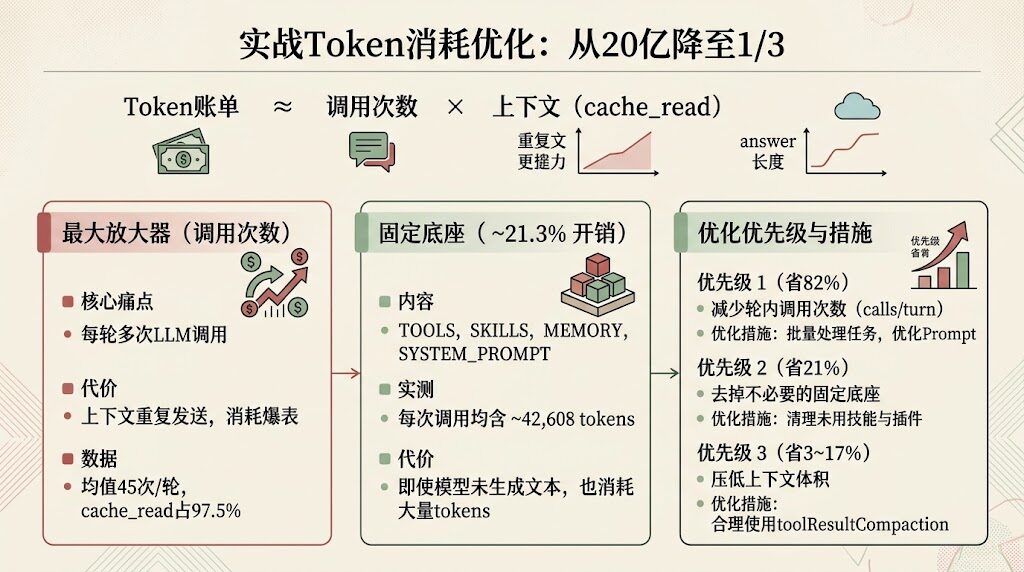
27.6 天、40,436 次模型调用烧掉 80.8 亿 tokens,97.5% 花在重复上下文上。实测证明放大器是调用次数(37.2 倍)而非上下文膨胀,附技能与 MCP 回收清单、配置收紧方案。

aiec.fun
27.6 天、40,436 次模型调用烧掉 80.8 亿 tokens,97.5% 花在重复上下文上。实测证明放大器是调用次数(37.2 倍)而非上下文膨胀,附技能与 MCP 回收清单、配置收紧方案。
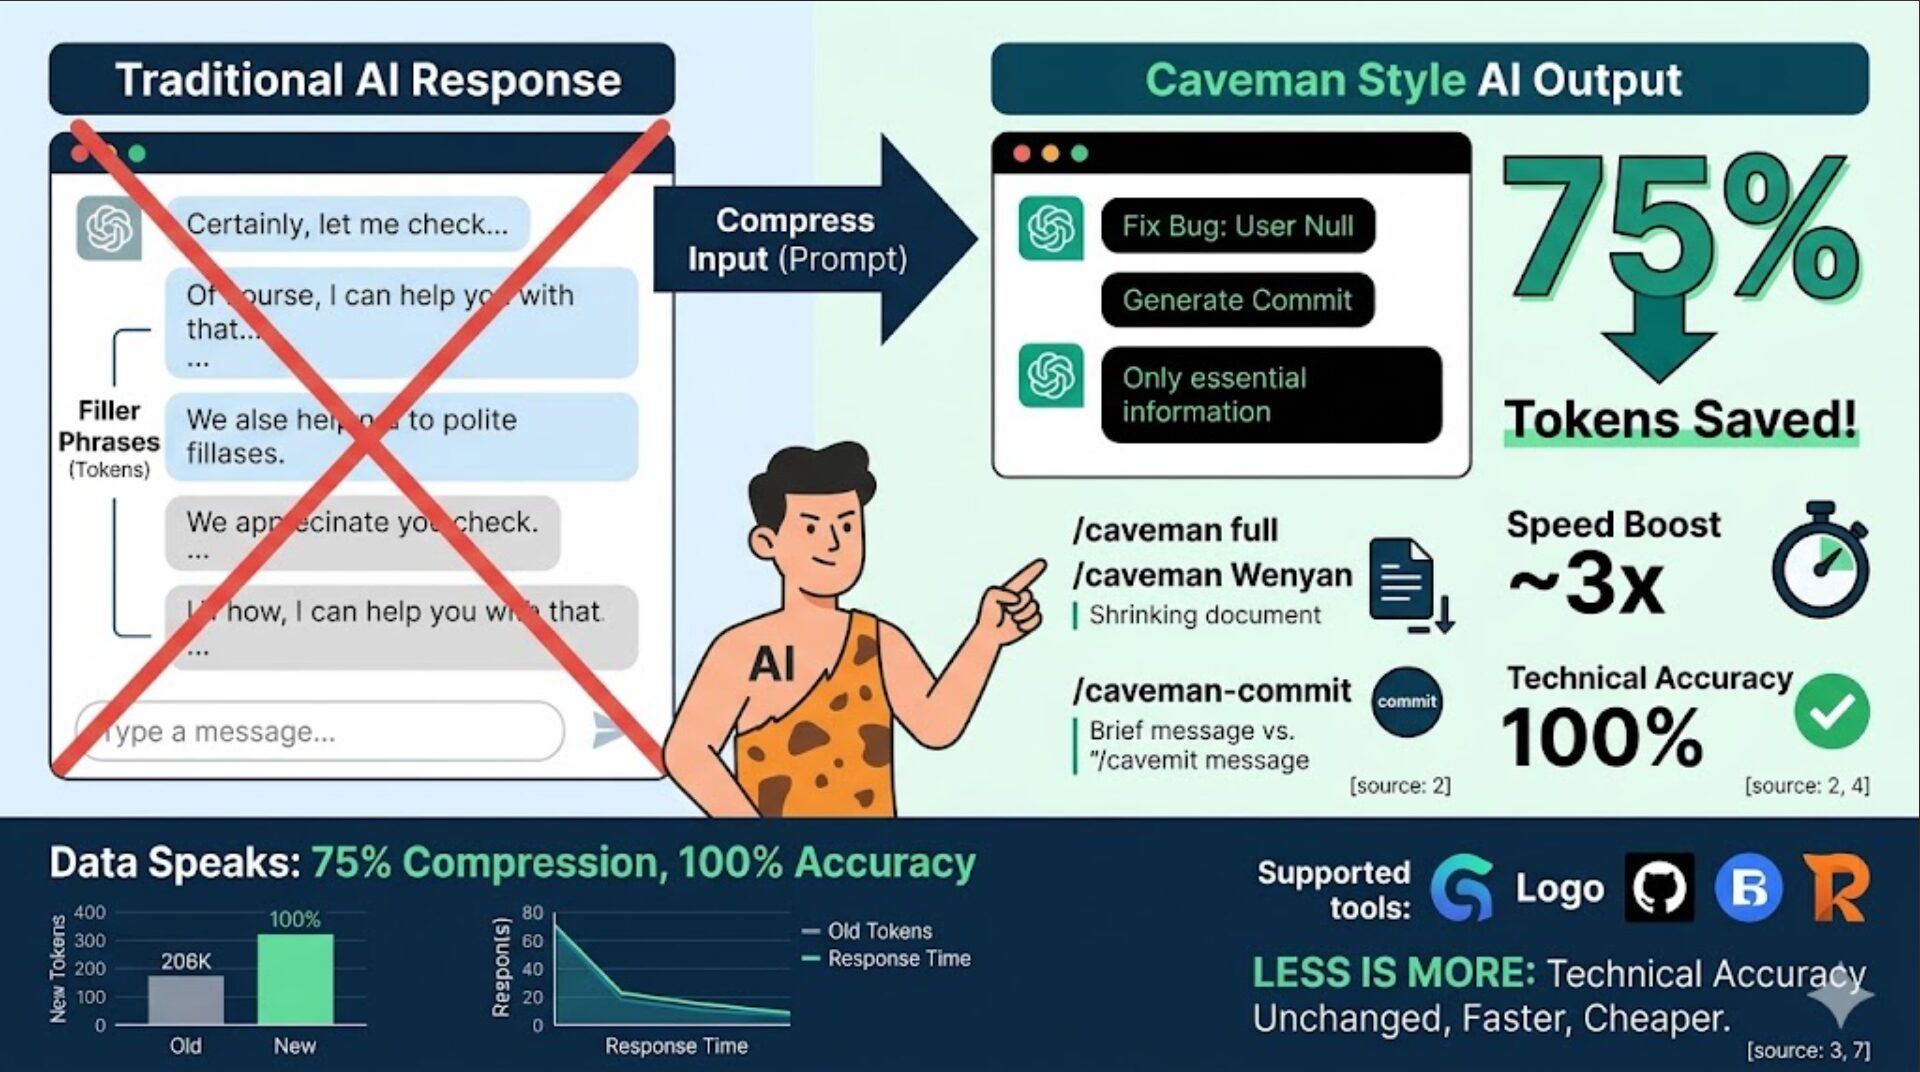
开源项目 caveman 以 "穴居人说话法" 精简 AI 回复,剔除冗余话术,可削减 75% 输出 token、提速近 3 倍且准确度不变。它功能丰富、适配多款 AI 工具,相较同类产品优势明显,也为优化提示词、提升 AI 使用效率带来实用启发。

装了GBrain以为就够用,结果专家agent依然丢三落四。直到研究了腾讯的TencentDB Agent Memory,才明白记忆需要分层——知识归知识,事件归事件。本文分享我们如何借鉴大厂思路,用轻量化方案实现AI记忆优化。
本文针对MacBook M4 24G设备,详细讲解OpenClaw本地大模型的选型、配置方法、完整安装步骤,以及飞书调用Agents的流程。无需修改默认云端模型,仅特殊任务调用本地模型节省token,实操性强,小白可直接跟着操作。